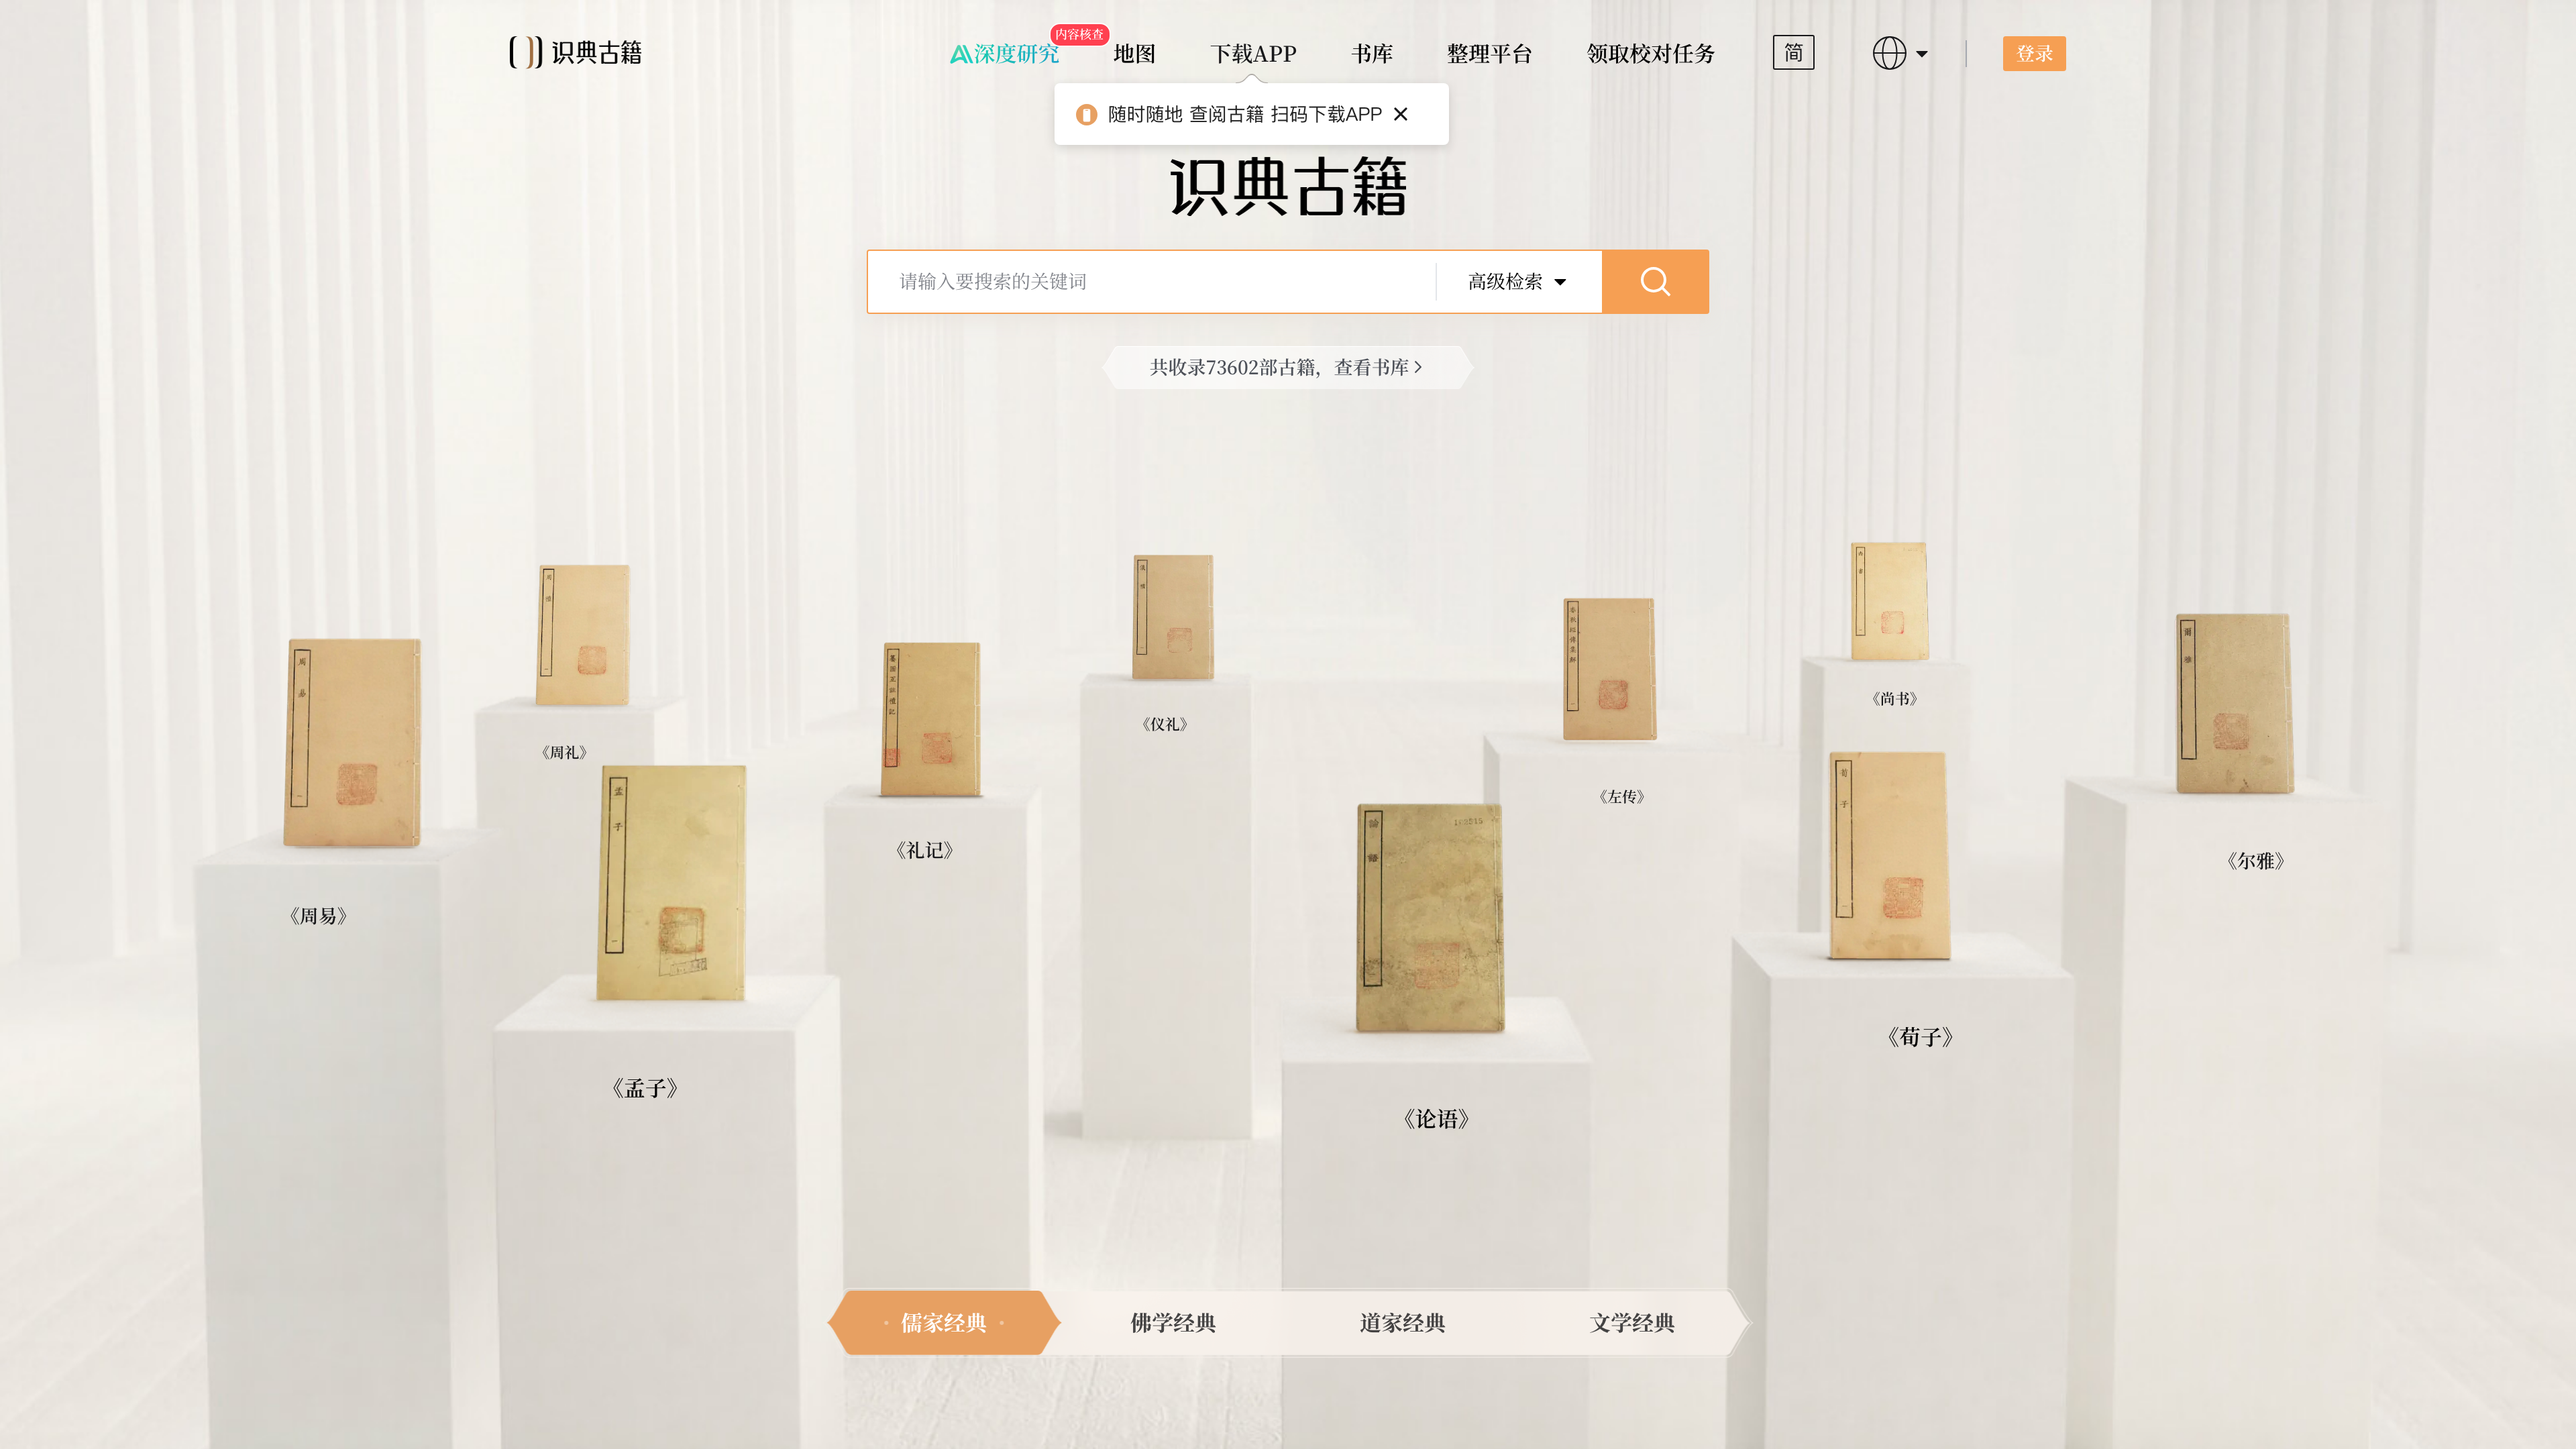
識典古籍(shidianguji.com)是一個免費的中國古籍數位閱讀與整理平台,由抖音集團(字節跳動)與北京大學合作建設,2022 年 10 月測試版上線。平台把古籍從掃描影像進一步推進到可全文檢索的數位化文本:讀者可以按經、史、子、集等傳統分類瀏覽書庫,在全部收錄文本中檢索字句,或線上閱讀帶現代標點的橫排文本並對照原刻本影像。據官網首頁顯示,截至 2026-09-01 平台共收錄 73,602 部古籍;北京日報 2026 年 8 月報導引述北京大學介紹稱,平台月均讀者超過 240 萬、總訪問量近 3 億次。與古籍影像庫或純文本庫相比,它可核實的特點在於:全流程 AI 整理管線(OCR、自動標點、命名實體識別)、文本按「精校/粗校」分級標註、配套整理平台向公眾免費開放,以及大規模群眾外包校對機制。
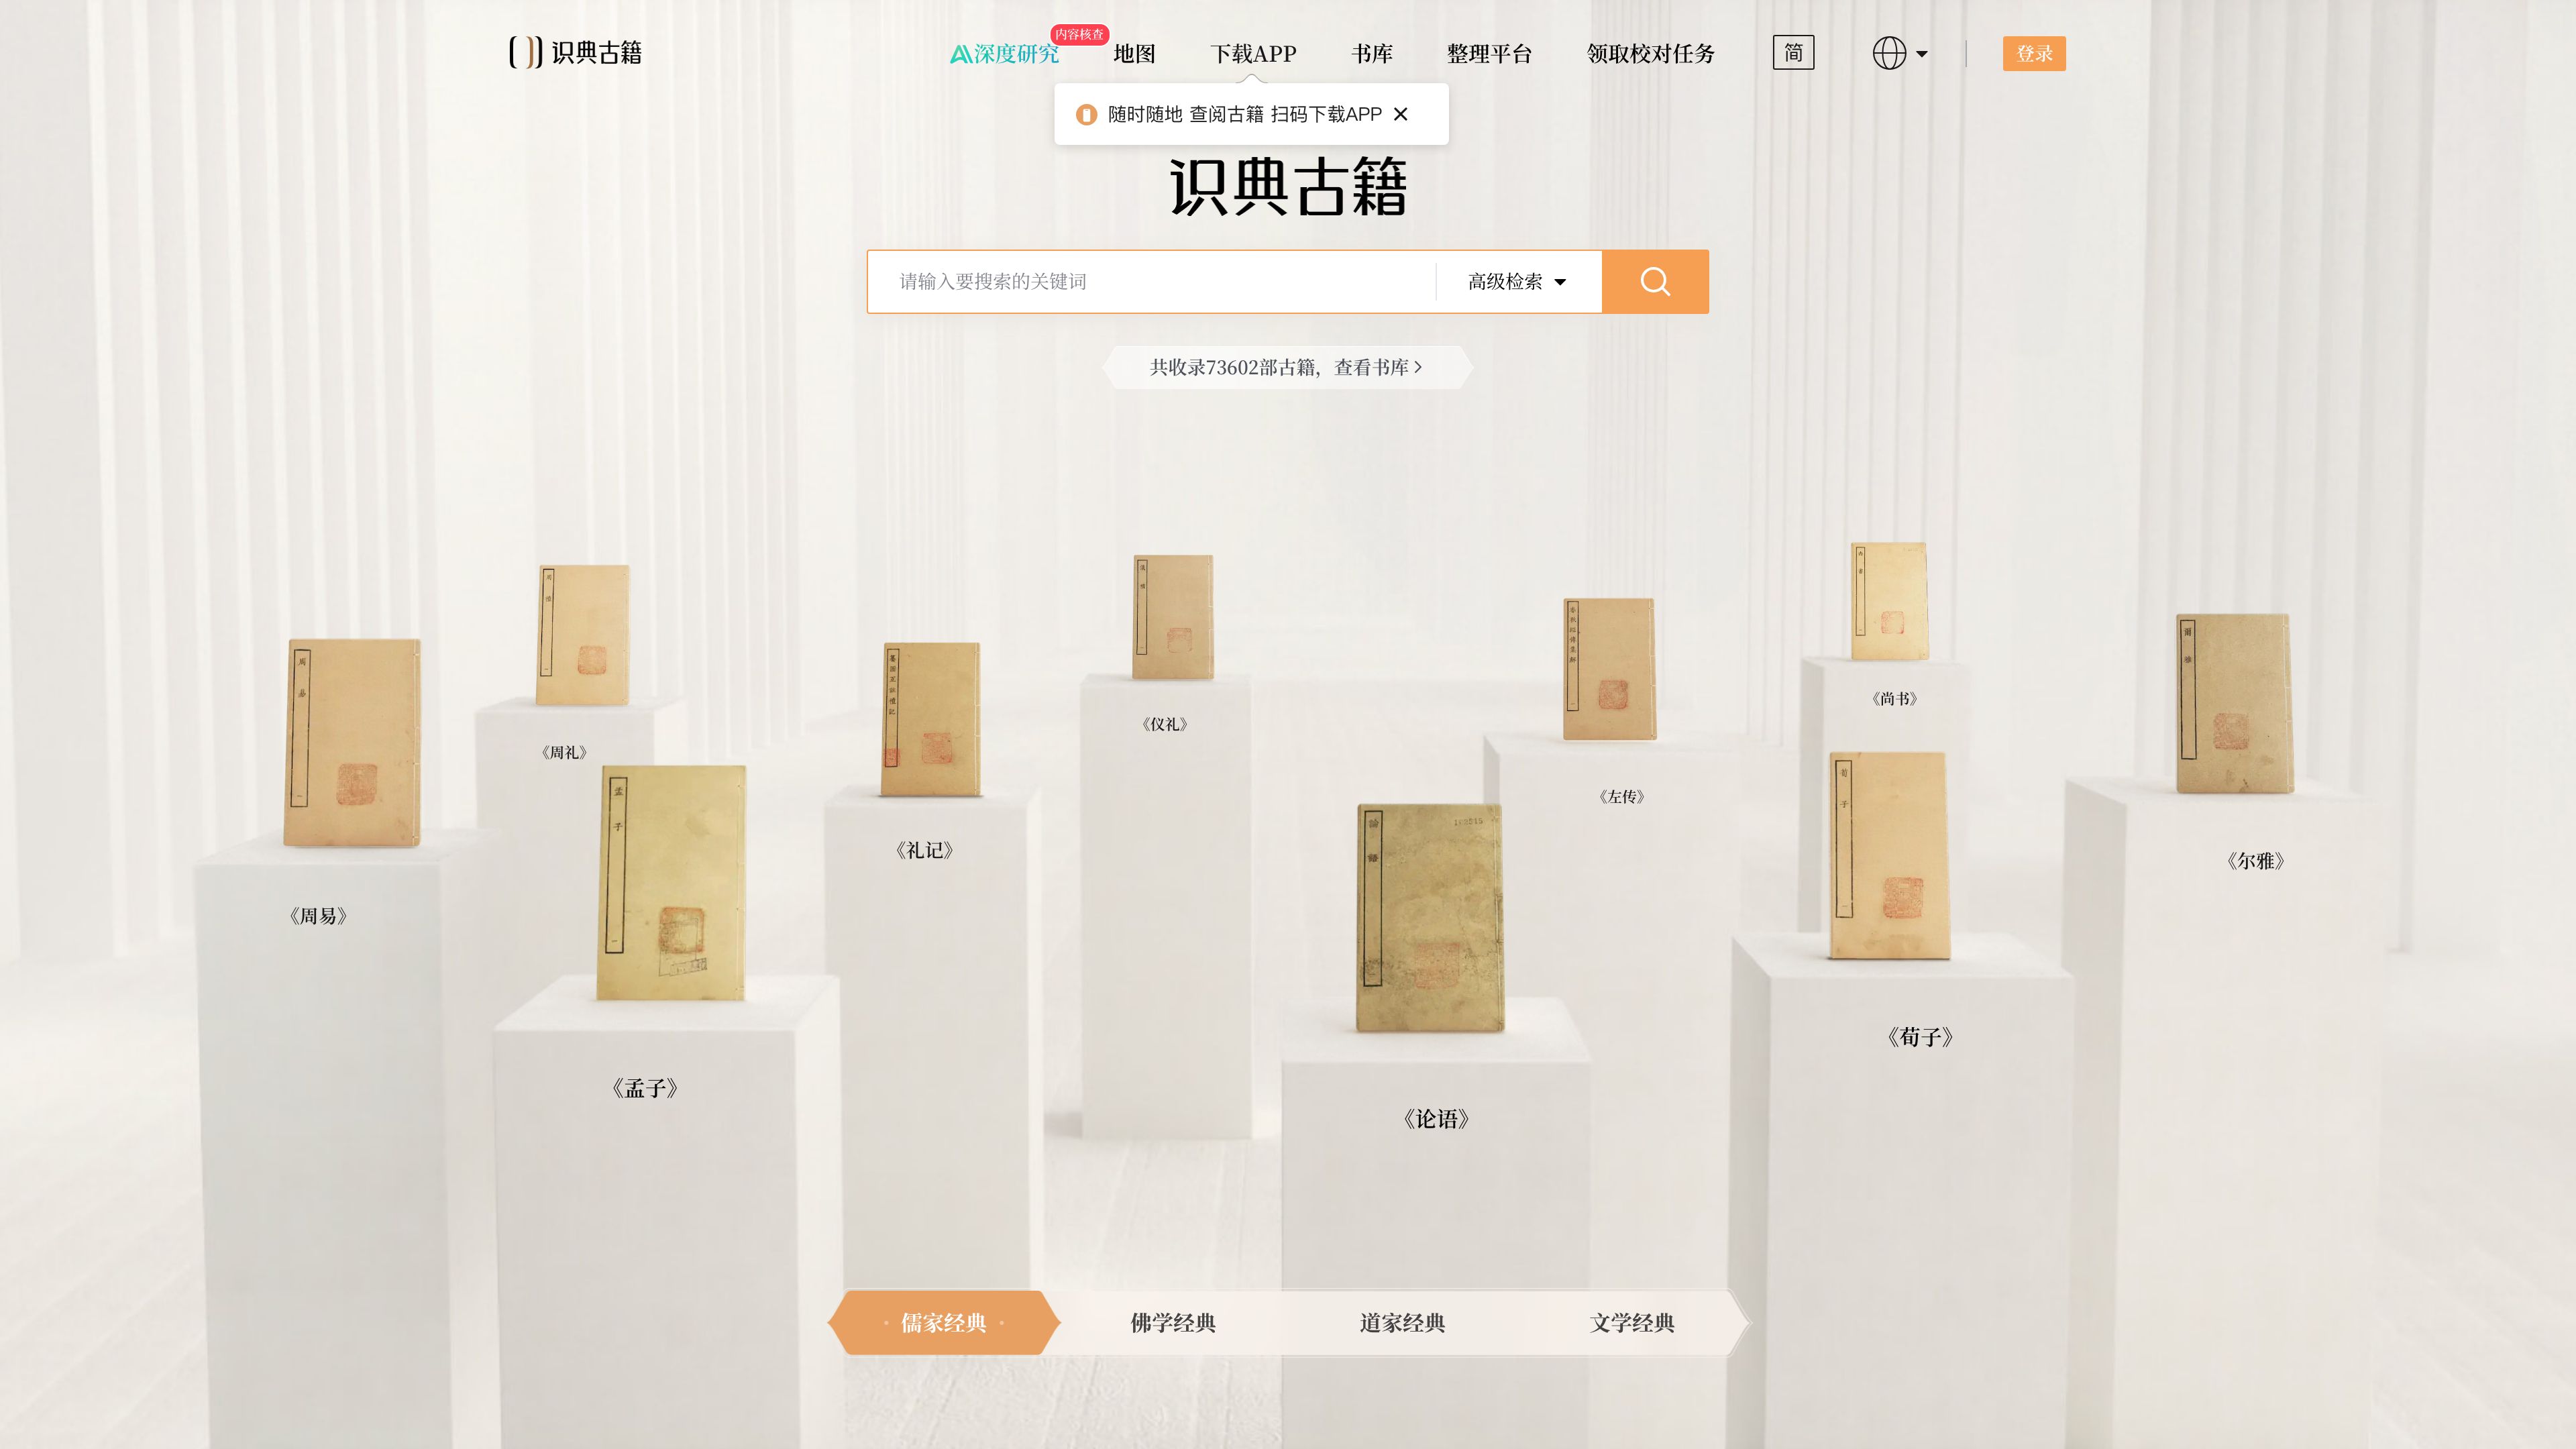
站點速覽
- 網址:https://www.shidianguji.com/
- 類型:中國古籍數位閱讀、全文檢索與整理平台
- 費用:完全免費、無廣告;官方公眾號口徑為「永久免費,沒有廣告」
- 註冊要求:瀏覽書庫、閱讀正文、全文檢索無需註冊;書架、筆記、複製文本、深度研究和整理平台等功能需登入
- 介面語言:以簡體中文為主,提供英文介面(書庫條目附部分英文譯名);正文支援機器繁簡轉換
- 行動端:2025 年上線 iOS 與 Android 獨立 App;網頁版保留原版影像對照
站點背景
平台由北京大學與抖音集團合作建設。據北京大學數位人文研究中心專案頁,2022 年 3 月抖音集團向北京大學教育基金會捐贈,雙方依託「北京大學-字節跳動數位人文開放實驗室」共建該平台,期望解決古籍數位化利用的瓶頸,面向海內外學者和古籍愛好者免費開放。合作分工為:北大方面提供設計指導和古籍圖文資料並組織專家整理校對,字節跳動捐贈資金並負責研發營運;平台「關於我們」頁說明,北京大學提供的古籍圖文資料版權歸北京大學所有。
建設的現實背景是古籍數位化的斷層:字節跳動公益 2022 年發布稿稱,中國現存古籍約 20 萬種,已完成影像掃描約 8 萬種,而實現文本數位化的僅 3–4 萬種——掃描影像無法全文檢索,文本化才是「完全數位化」。
收錄規模隨時間持續擴大,引用時需注意口徑時點:
- 2022 年 10 月 11 日測試版上線:390 部,主要來自《四部叢刊》(新華網)
- 2023 年末:2200 餘部(北京大學新聞網)
- 2024 年末:10000 部;2025 年上半年突破 20000 部(字節跳動公益)
- 2026 年 8 月:超過 7 萬部免費開放閱讀(北京日報);截至 2026-09-01,官網首頁自報 73,602 部
書庫與文本品質分級
書庫按經部、史部、子部、集部、道教部、佛教部、出土文獻部、文書檔案部等一級分類組織,下設多級類目。條目顯示書名、卷數、作者、年代、版本(如「四部叢刊景上海涵芬樓藏宋刊」)和文本來源(如「北京大學-字節跳動古籍開放文本庫」、《儒藏》)。
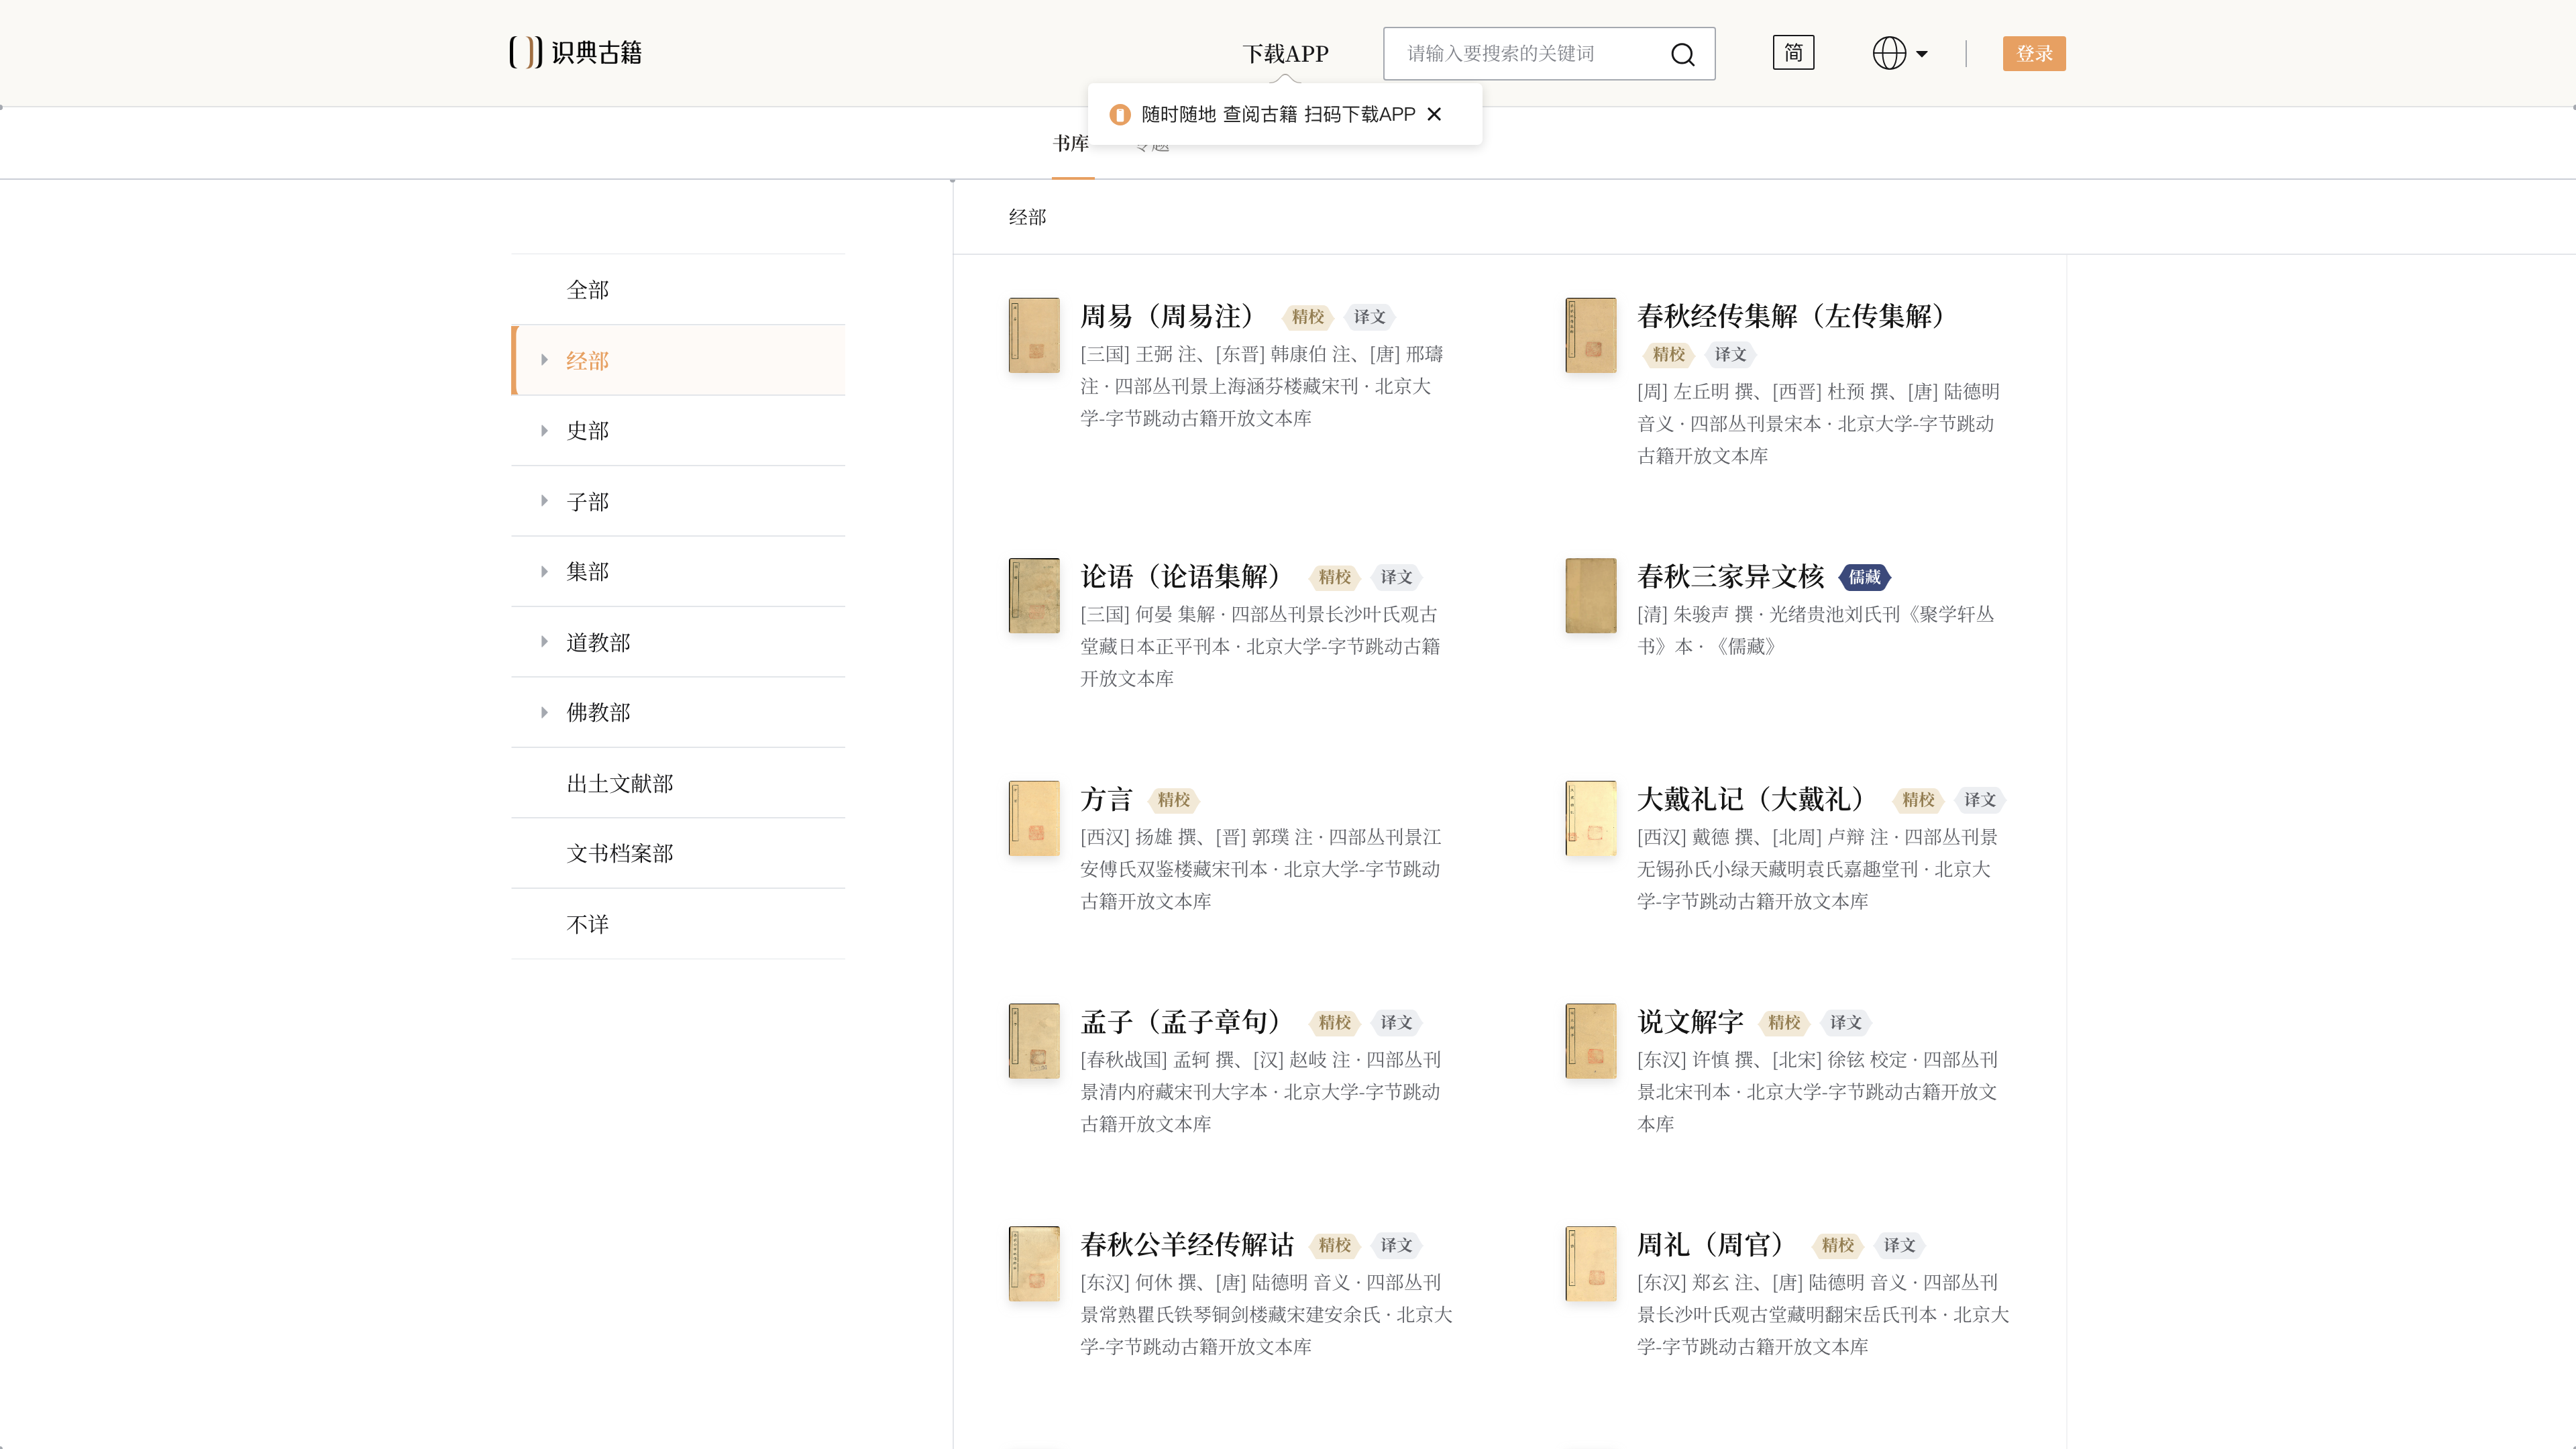
每條文本以角標標註品質等級:「精校」表示文字、標點與實體均經人工校對,「粗校」或「AI整理」表示機器處理結果;頁面同時提示「該文本內容為機器處理結果,請結合原圖閱讀或使用」。這一分級機制讓讀者可以區分文本的可信程度,是正式引用前必須留意的資訊。
全文檢索
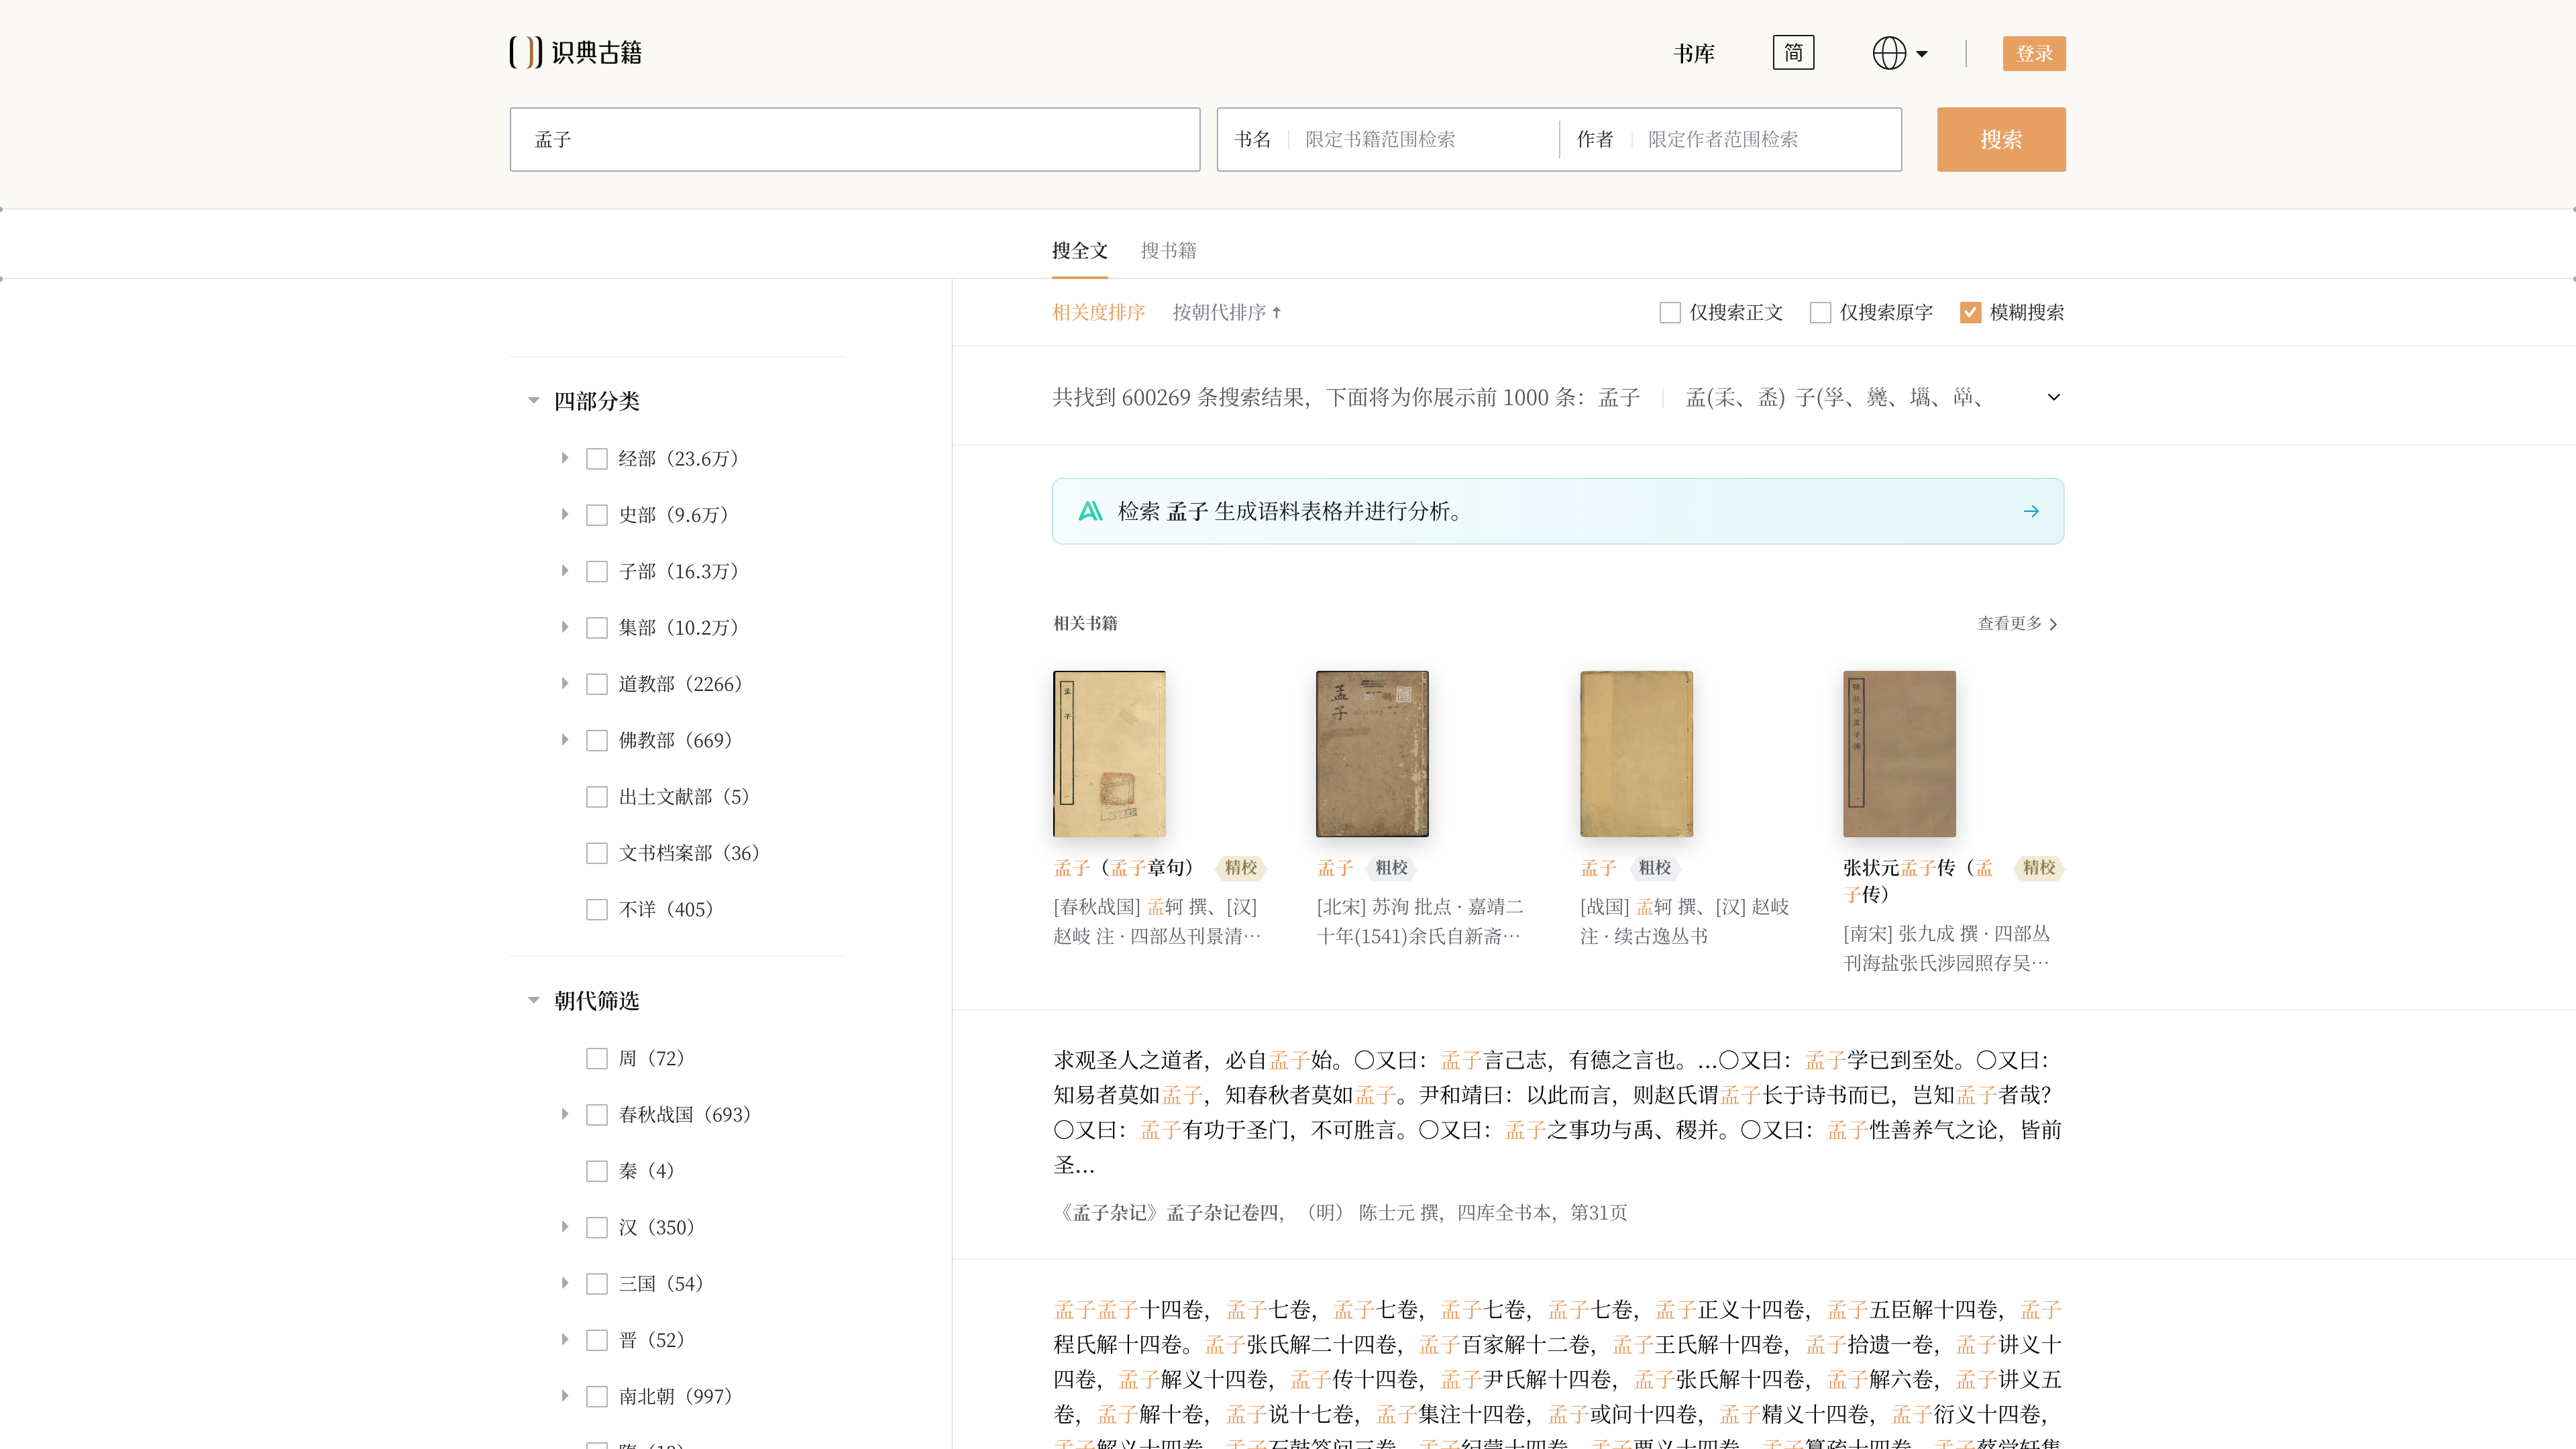
全文檢索無需登入即可使用,支援「搜全文」與「搜書籍」兩種模式。結果可按四部分類、朝代篩選,按相關度或朝代排序,並提供「僅搜索正文」「僅搜索原字」「模糊搜索」等選項;異體字會歸併展示(例如檢索「孟子」時提示「孟(𣏍、𥁪)子(㜽…)」)。每條命中附書名、卷次、版本與頁碼出處,便於回溯原書。檢索入口還提供「生成語料表格並進行分析」的語料分析功能。
閱讀與輔助工具
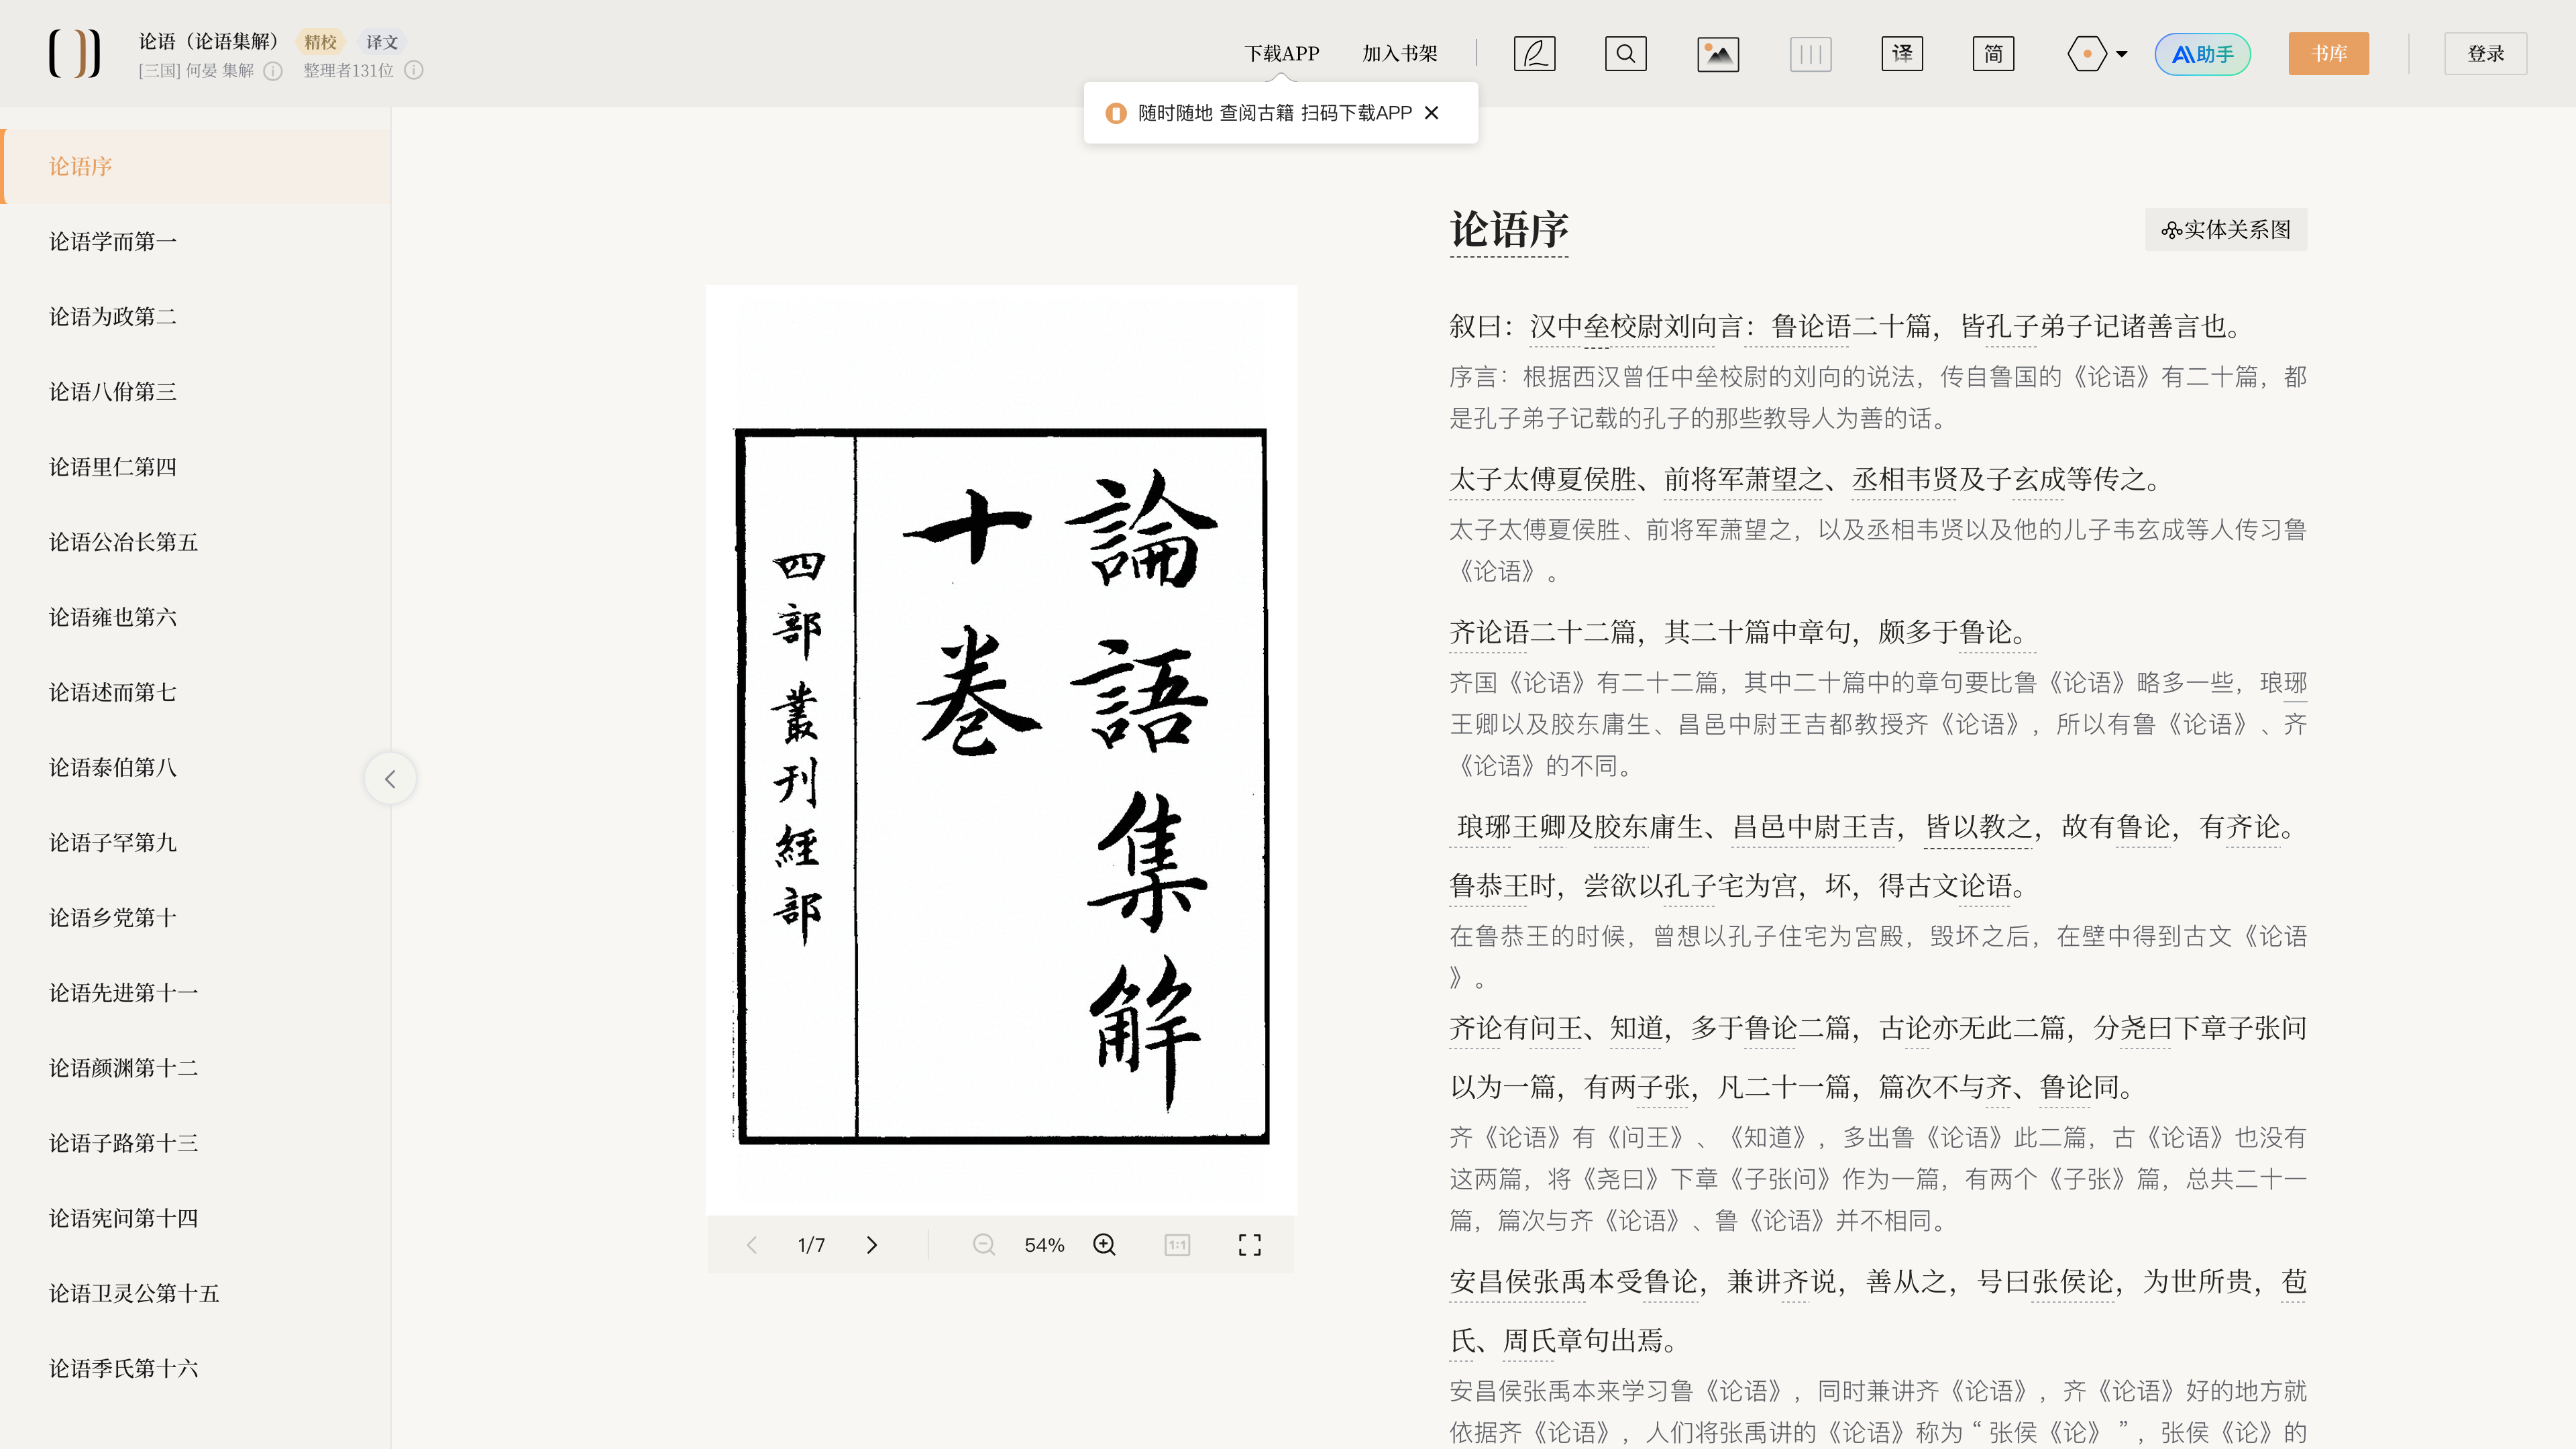
閱讀頁提供橫排文本與現代標點,左側為章節目錄,可開啟原本影像與整理文本同屏對照——文本可溯源到底本影像是平台的建設原則。輔助工具包括:注疏內容的顯示與隱藏、機器繁簡轉換(頁面標註「機器簡體,僅供參考」)、生僻詞懸浮釋義、人名地名專名號標註與可點擊的實體百科,以及實體關係圖和歷史地圖(頁面聲明部分資料由機器自動生成,可能有錯誤)。
AI 能力方面,北京日報 2026 年 8 月報導稱平台已用 AI 將 1 萬部古籍翻譯成白話文;頁面聲明「白話翻譯為人工檢查過的機器翻譯,僅供參考」。站內 AI 助手基於豆包大模型,頁面提示「內容由AI生成,可能有錯誤,使用前注意查證」,其中「深度研究」功能需登入後使用。
整理平台與群眾外包校對
配套的古籍智能整理平台原為內部系統,2024 年起免費向有公益性古籍整理需求的個人和團隊開放。據官方使用手冊,平台整合 OCR(可識別 9.8 萬字)、自動標點、自動結構整理、自動實體提取與多版本自動校勘,整理成果可發布回閱讀平台共享。群眾外包方面,「我是校書官」(2025 年起稱「我用AI校古籍」)組織公眾參與 OCR 粗校與標點精校;北京大學新聞網 2026 年 1 月報導,累計近 3.8 萬人參與、完成 2 萬餘部古籍整理,粗校字數達 15 億、精校字數 1 億。《儒藏》編纂工程 2025 年起也使用該平台。平台上的專題資料庫還包括永樂大典高清影像資料庫(2023 年公開 40 冊影像)、科技典籍資料庫(2026 年 8 月上線,首批 1982 部)等。
帳號體系與開放能力
匿名狀態下可瀏覽書庫、閱讀正文和全文檢索;使用者服務協議亦說明「您無需註冊也可開始使用識典古籍及相關服務,但部分功能或服務可能會受到影響」。登入後(字節跳動帳號體系,支援手機驗證碼、密碼或經今日頭條 App 掃碼)可使用書架、筆記、專題書單、複製文本與查看引用(頁面提示有額度上限)、深度研究、整理平台和領取校對任務。
平台未見公開的官方 API 或批量資料下載管道;學術界通常以「北京大學-字節跳動古籍開放文本庫」的名義引用其文本。內容介面有嚴格的反爬蟲風控,不利於程式化批量利用。
版權與內容政策
古籍原文本身屬公有領域,但《識典古籍使用者服務協議》對站內內容的使用設有明確限制:未經書面許可不得將平台內容用於商業用途,不得擅自編輯、整理、編排後在站外管道展示,並禁止盜鏈、抓取及用機器人程式複製、下載平台內容(2.4、4.3、4.4、7.5 條);北京大學提供的古籍圖文資料版權歸北京大學所有。平台公布的侵權投訴與合作聯絡信箱為 guji@bytedance.com。
適用場景
- 查證某句話在傳世典籍中的出處:全文檢索直接給出書名、卷次、版本與頁碼。
- 閱讀常見經典的整理文本,並結合原本影像核對關鍵字句。
- 數位人文研究的語料初查、實體關係與歷史地理資訊瀏覽。
- 有公益性質古籍整理需求的個人或團隊,免費使用 OCR 與校勘流水線。
局限
- 機器文本準確率有限:官方 2022 年口徑稱 OCR 識別準確率 96%–97%,即每百字約有 3–4 字誤差;粗校文本的標點與實體識別未經人工校對,正式引用須核對原圖。
- 白話翻譯、繁簡轉換與 AI 助手輸出均為機器生成,平台自身均標註「僅供參考」或提示查證。
- 複製文本與查看引用需登入且有額度上限;無公開 API 或資料集下載,批量利用受協議與風控雙重限制。
- 收錄以漢文中國古籍為中心,傳世典籍為主,兼及佛藏、道藏、出土文獻、方志等;具體某部書是否有影像取決於底本來源。
- 介面以中文為主,英文介面覆蓋有限。
同類參考
- 中國哲學書電子化計劃:學術向的漢籍全文檢索庫,原文與影像逐段對照,進階功能需付費訂閱。
- 書格:公有領域古籍高清影像下載站,側重影像本身而非可檢索文本。
- 中華經典古籍庫:中華書局營運的商業古籍文本庫,面向機構訂閱。
參考資料
- 識典古籍官網首頁(核查日期:2026-09-01)
- 關於我們 - 識典古籍(核查日期:2026-09-01)
- 識典古籍使用者服務協議(核查日期:2026-08-30)
- 整理平台簡介|「識典古籍」整理平台使用手冊(核查日期:2026-08-30)
- 識典古籍閱讀與整理平台 - 北京大學數位人文研究中心(核查日期:2026-08-30)
- 北大攜字節跳動推出古籍數位化平台 - 新華網(核查日期:2026-08-30)
- 匯集《永樂大典》等2200餘部古籍 - 北京大學新聞網(核查日期:2026-08-30)
- 三年,20000部古籍 - 字節跳動公益(核查日期:2026-08-30)
- 「我用AI校古籍」(2025年)總結會舉行 - 北京大學新聞網(核查日期:2026-08-30)
- 超7萬部古籍從「紙」到「網」,讀者可免費雲端閱讀 - 北京日報(核查日期:2026-08-30)
- 終於,識典古籍APP來了 - 識典古籍公眾號(安慶師範大學圖書館轉載)(核查日期:2026-08-30)



