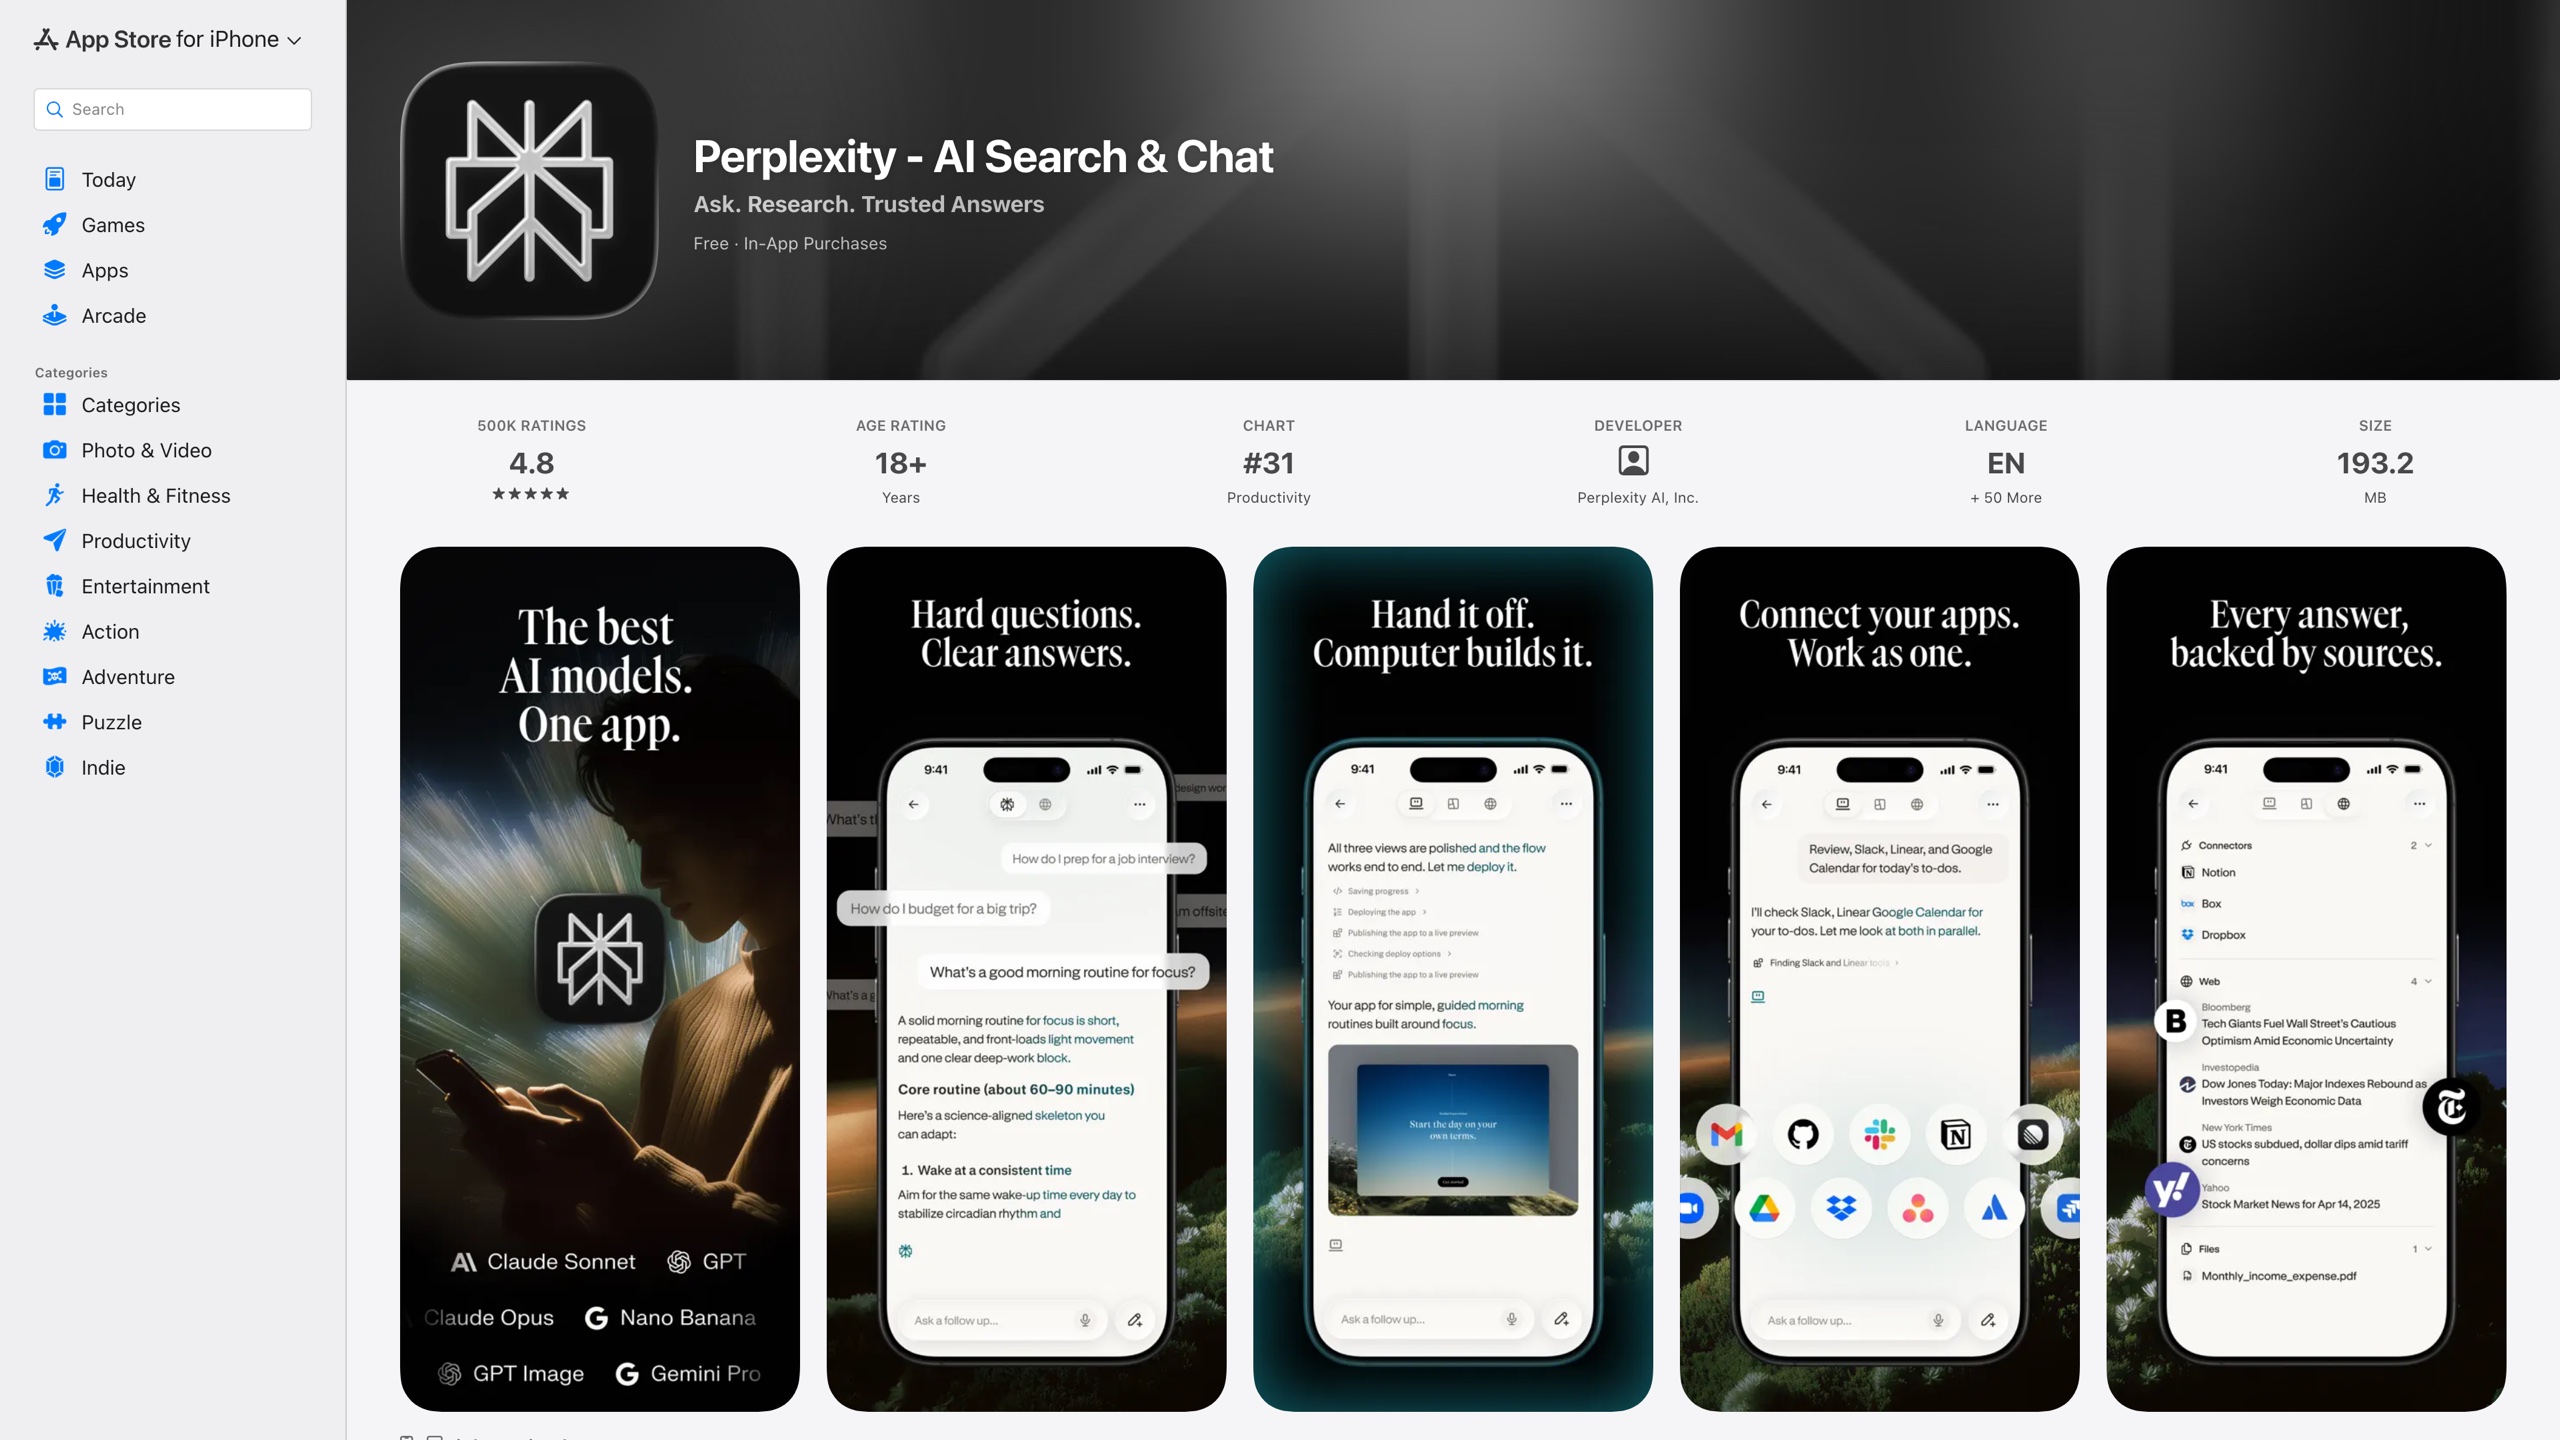
Perplexity 把「搜尋」與「問答」合而為一:輸入問題後,它即時檢索網頁、呼叫大型語言模型,直接生成一段附來源引用的回答,而不是丟給你十條連結自行點閱。官方將其定位為「答案引擎」(answer engine),口號是 "Where Knowledge Begins",並強調每個回答都附上可查證的來源。它由前 OpenAI 研究員 Aravind Srinivas 等四人於 2022 年創立,是目前 AI 搜尋產品中規模最大、爭議也最多的代表之一。收錄它的原因很直接:當你想快速掌握陌生主題、又需要能核對出處的答案時,它是當前最常被提及的選項之一。
站點速覽
- 網址:https://www.perplexity.ai/
- 類型:AI 答案引擎/對話式搜尋
- 費用:基本功能免費;Pro 訂閱 20 美元/月或 200 美元/年;Max 訂閱 200 美元/月;API 按用量計費(價格截至 2026-08-31,詳見下文)
- 註冊要求:不註冊即可使用基本搜尋(據 Bloomberg 報導);註冊後才能保存紀錄並跨裝置同步
- 平台:網頁版、iOS、Android、Chrome 擴充功能,另有獨立 AI 瀏覽器 Comet
- 介面語言:iOS 版提供含繁體中文、簡體中文在內的 51 種介面語言(據 App Store 頁面,截至 2026-08-31)
站點背景
Perplexity AI, Inc. 於 2022 年 8 月由 Aravind Srinivas、Denis Yarats、Johnny Ho 與 Andy Konwinski 四人創立,總部位於舊金山,創辦團隊成員曾任職於 OpenAI、Google DeepMind 等研究機構。核心產品於 2022 年 12 月 7 日公開上線,其後陸續推出 iOS(2023 年 4 月)與 Android 應用。以上沿革見 Wikipedia 條目及其引用的 TechCrunch、Forbes 報導。
規模方面有兩個可參考的數據點:執行長 Aravind Srinivas 在 2025 年 6 月的 Bloomberg 科技峰會上表示,公司於 2025 年 5 月處理了 7.8 億次查詢(公司自述口徑,未經獨立審計);2025 年 9 月,公司完成估值 200 億美元的融資(Reuters 報導)。2025 年 7 月,公司發表以 Chromium 為基礎的 AI 瀏覽器 Comet,同年 10 月起開放免費下載。
核心能力:直接給出附引用的答案
Perplexity 的基本流程是「提問—檢索—生成—引用」:送出問題後,系統即時搜尋網頁,以大型語言模型把多個來源整理成連貫的回答,並在句末標註編號引用,點擊即可跳回原始網頁。回答之後可以繼續追問,對話脈絡會保留在同一個 Thread 中。
在此之上,功能分為幾個層次(名稱以官方為準):
- Pro Search 與 Deep Research:針對複雜問題的引導式深度檢索;Deep Research 會進行多輪搜尋,產生篇幅更長的研究報告。
- 檔案與空間:支援上傳 PDF、試算表等檔案,與網頁內容一併檢索;Spaces/Library 用於整理過往的研究。
- 模型選擇:付費用戶可在 OpenAI、Anthropic、Google 等廠商的模型之間切換,也可使用 Perplexity 自研的 Sonar 系列模型。
- 語音與助理:行動版支援語音提問;Android 版提供可跨應用執行操作的 Assistant。
- Discover:按主題瀏覽資訊的公開內容流。
需要說明的是,上述功能邊界隨版本調整頻繁,免費帳戶各項能力的具體額度官方並未長期固定,本文不予列舉。
訂閱方案與開發者 API
截至 2026-08-31,個人用戶的價格體系為:基本功能免費;Pro 每月 20 美元(年付 200 美元),包含更強的模型選擇、更多 Deep Research 額度與檔案上傳等;Max 每月 200 美元,面向高頻用戶,提供 Labs 不限量、最新模型優先使用權等(Max 方案於 2025 年 7 月推出)。上述價格與 App Store 應用程式內購買列表一致。此外還有面向團隊的 Enterprise 方案。
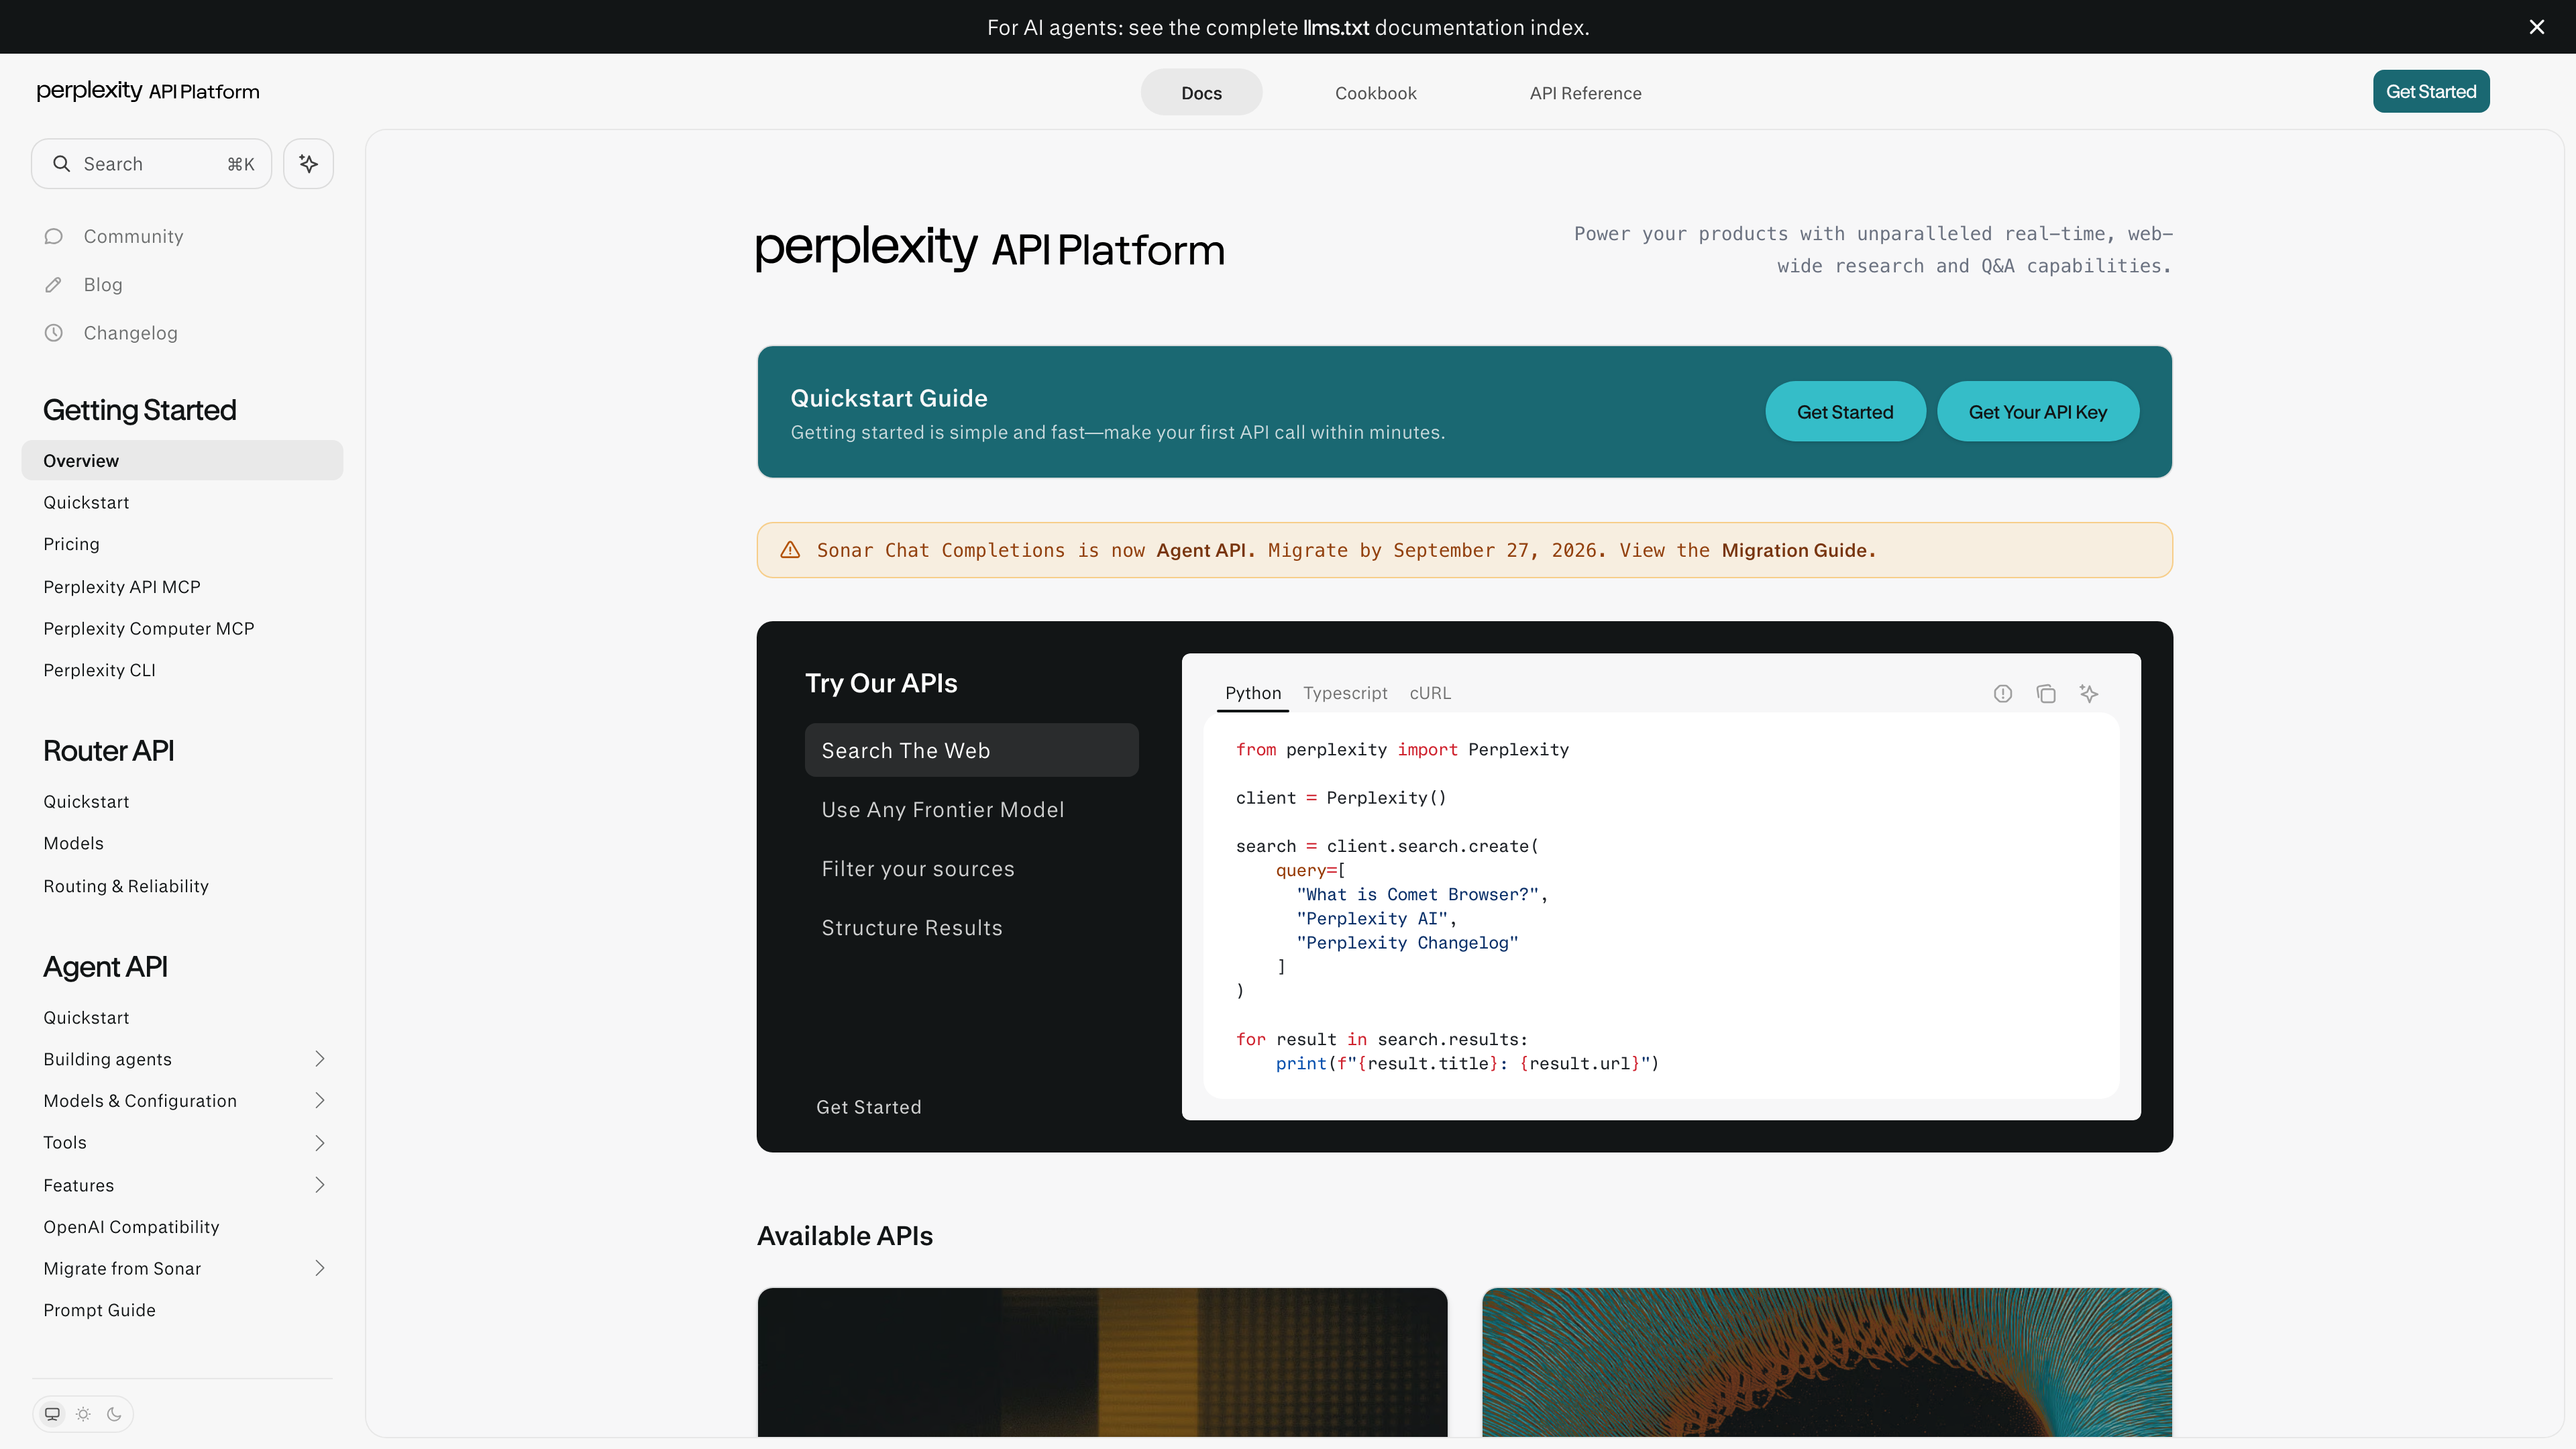
面向開發者,Perplexity 提供獨立的 API 平台(docs.perplexity.ai):直接回傳答案的 Agent API、回傳原始搜尋結果的 Search API(5 美元/千次請求)、託管開源模型的 Router API,以及 Embeddings API;Sonar 模型按 token 計費(例如 sonar 模型輸入為 1 美元/百萬 token,詳見官方定價頁)。API 與網頁版訂閱是兩套獨立的計費體系。
隱私與資料蒐集
Perplexity 的隱私聲明(最近更新於 2026 年 7 月 2 日)載明:註冊帳戶、送出的查詢、上傳的文件與付費資訊都會被蒐集,另有透過 Cookie、裝置與伺服器日誌自動蒐集的資料。App Store 隱私標籤顯示,購買紀錄、位置、識別碼、使用資料與診斷資訊會連結到用戶身分。聲明同時指出,企業版與 API 產品的資料處理由單獨條款涵蓋。如果你會把敏感問題或內部文件交給搜尋工具,這一點值得留意。
版權爭議與爬蟲行為
在使用 Perplexity 之前,有必要知道它是當前與內容出版方衝突最多的 AI 公司之一。據 Wikipedia 條目彙整:2024 年 6 月,Forbes 公開指責其改寫付費報導卻未充分署名;同月 Wired 的調查稱其使用未公開的 IP 與偽裝的 User-Agent 抓取已聲明禁止抓取的網站;此後《紐約時報》發出停止侵權通知,道瓊斯與《紐約郵報》提起訴訟,BBC、讀賣新聞、朝日新聞、日經新聞與 Reddit 也先後在 2025 年採取法律行動。
2025 年 8 月,Cloudflare 發表調查報告,稱在封鎖其公開聲明的爬蟲後,仍觀察到 Perplexity 改用偽裝成一般瀏覽器的未聲明爬蟲繼續抓取,並據此將其移出「已驗證機器人」名單;Perplexity 否認相關指控。作為回應爭議的一環,公司於 2024 年 7 月推出出版商分成計畫,與 Time、Fortune、Der Spiegel 等媒體分享廣告收入。這些爭議不影響一般用戶使用產品,但關係到其內容來源的長期可持續性。
適用場景
- 快速建立對陌生主題的整體認知:直接給出結構化概述與出處,省去逐條點開搜尋結果的時間。
- 需要核對來源的事實性查詢:每個論斷附引用,方便回溯原文驗證——這一點比純聊天機器人更適合研究型問題。
- 時效性強的問題:即時檢索網頁,比受訓練截止日期限制的離線模型更適合查新聞、價格、賽程等資訊。
- 多語言提問:介面覆蓋含中文在內的數十種語言,適合跨語言檢索。
局限
- 答案仍可能出錯。有引用不等於結論正確,它可能誤讀來源、過度概括或引用不相關的網頁;關鍵資訊應點開引用原文核實。
- 免費版的邊界不清晰且經常調整。Pro Search、Deep Research、檔案上傳、模型選擇等能力都向付費檔傾斜,免費額度以官方當時說明為準。
- 面對付費牆內容時能力受限:它無法繞過各網站的付費牆,答案品質受公開可抓取內容的限制。
- 隱私代價:查詢內容會被蒐集並可能用於改進服務,不適合輸入敏感或機密資訊。
- 版權爭議未決:多起訴訟與爬蟲爭議仍在進行中,其內容取得方式未來可能被迫調整。
- 中文支援以介面語言為主:介面提供繁/簡中文,但中文回答品質與中文來源覆蓋深度未經驗證,不應預設等同於英文體驗。
同類參考
- ChatGPT/Gemini:通用聊天機器人,同樣提供連網搜尋,但產品重心在對話與生成,而非檢索引用。
- Google AI Mode:搜尋引擎原生的 AI 答案,覆蓋面與來源生態更完整。
- Kagi:付費無廣告搜尋引擎,AI 摘要只是附加能力,定位更接近傳統搜尋。
參考資料
- Perplexity - App Store(功能描述、訂閱價格、介面語言、隱私標籤,核查於 2026-08-31)
- Perplexity AI - Wikipedia(公司沿革、融資、爭議事件彙整,核查於 2026-08-31)
- Perplexity API Platform 文件與 API 定價(核查於 2026-08-31)
- Perplexity 隱私聲明(2026-07-02 版,核查於 2026-08-31)
- Cloudflare:Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives(2025-08-04)
- Wired:Perplexity Is a Bullshit Machine(2024-06)
- The Verge:Perplexity 出版商分成計畫(2024-07-30)



