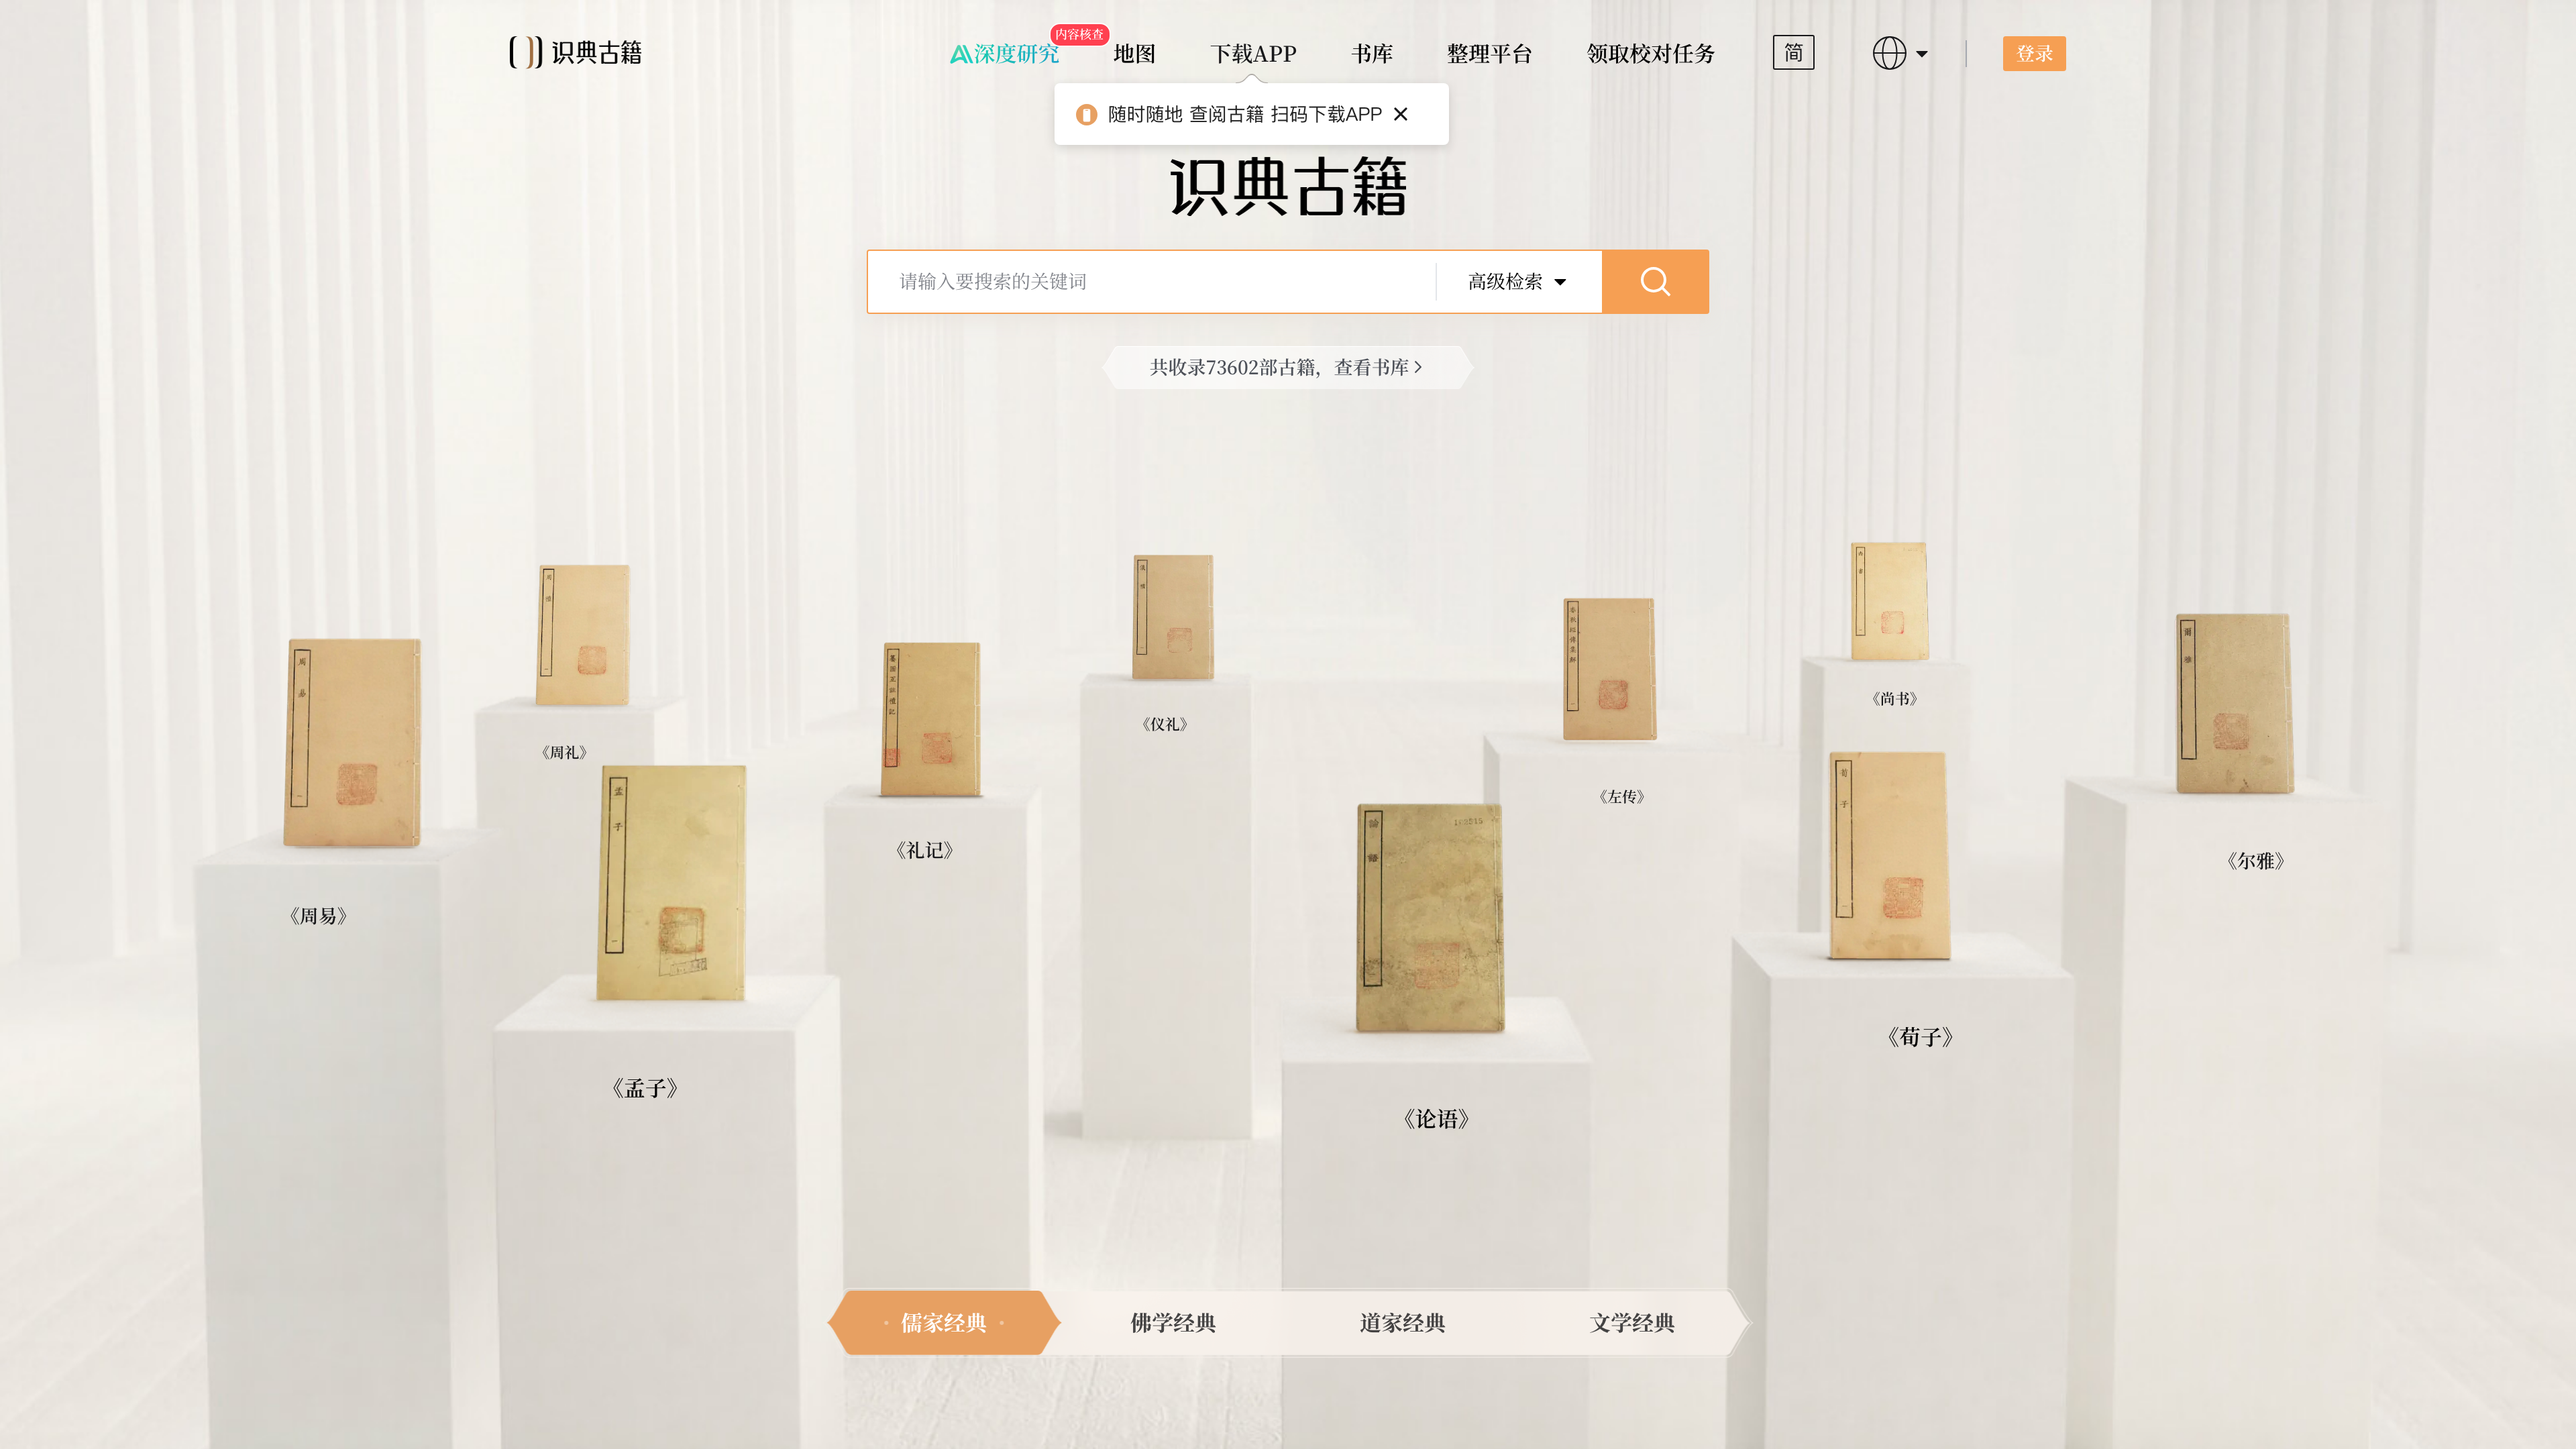
识典古籍(shidianguji.com)是一个免费的中国古籍数字阅读与整理平台,由抖音集团(字节跳动)与北京大学合作建设,2022 年 10 月测试版上线。平台把古籍从扫描影像进一步推进到可全文检索的数字化文本:读者可以按经、史、子、集等传统分类浏览书库,在全部收录文本中检索字句,或在线阅读带现代标点的横排文本并对照原刻本影像。据官网首页显示,截至 2026-09-01 平台共收录 73,602 部古籍;北京日报 2026 年 8 月报道引述北京大学介绍称,平台月均读者超 240 万、总访问量近 3 亿次。与古籍影像库或纯文本库相比,它可核实的特点在于:全流程 AI 整理管线(OCR、自动标点、命名实体识别)、文本按"精校/粗校"分级标注、配套整理平台向公众免费开放,以及大规模众包校对机制。
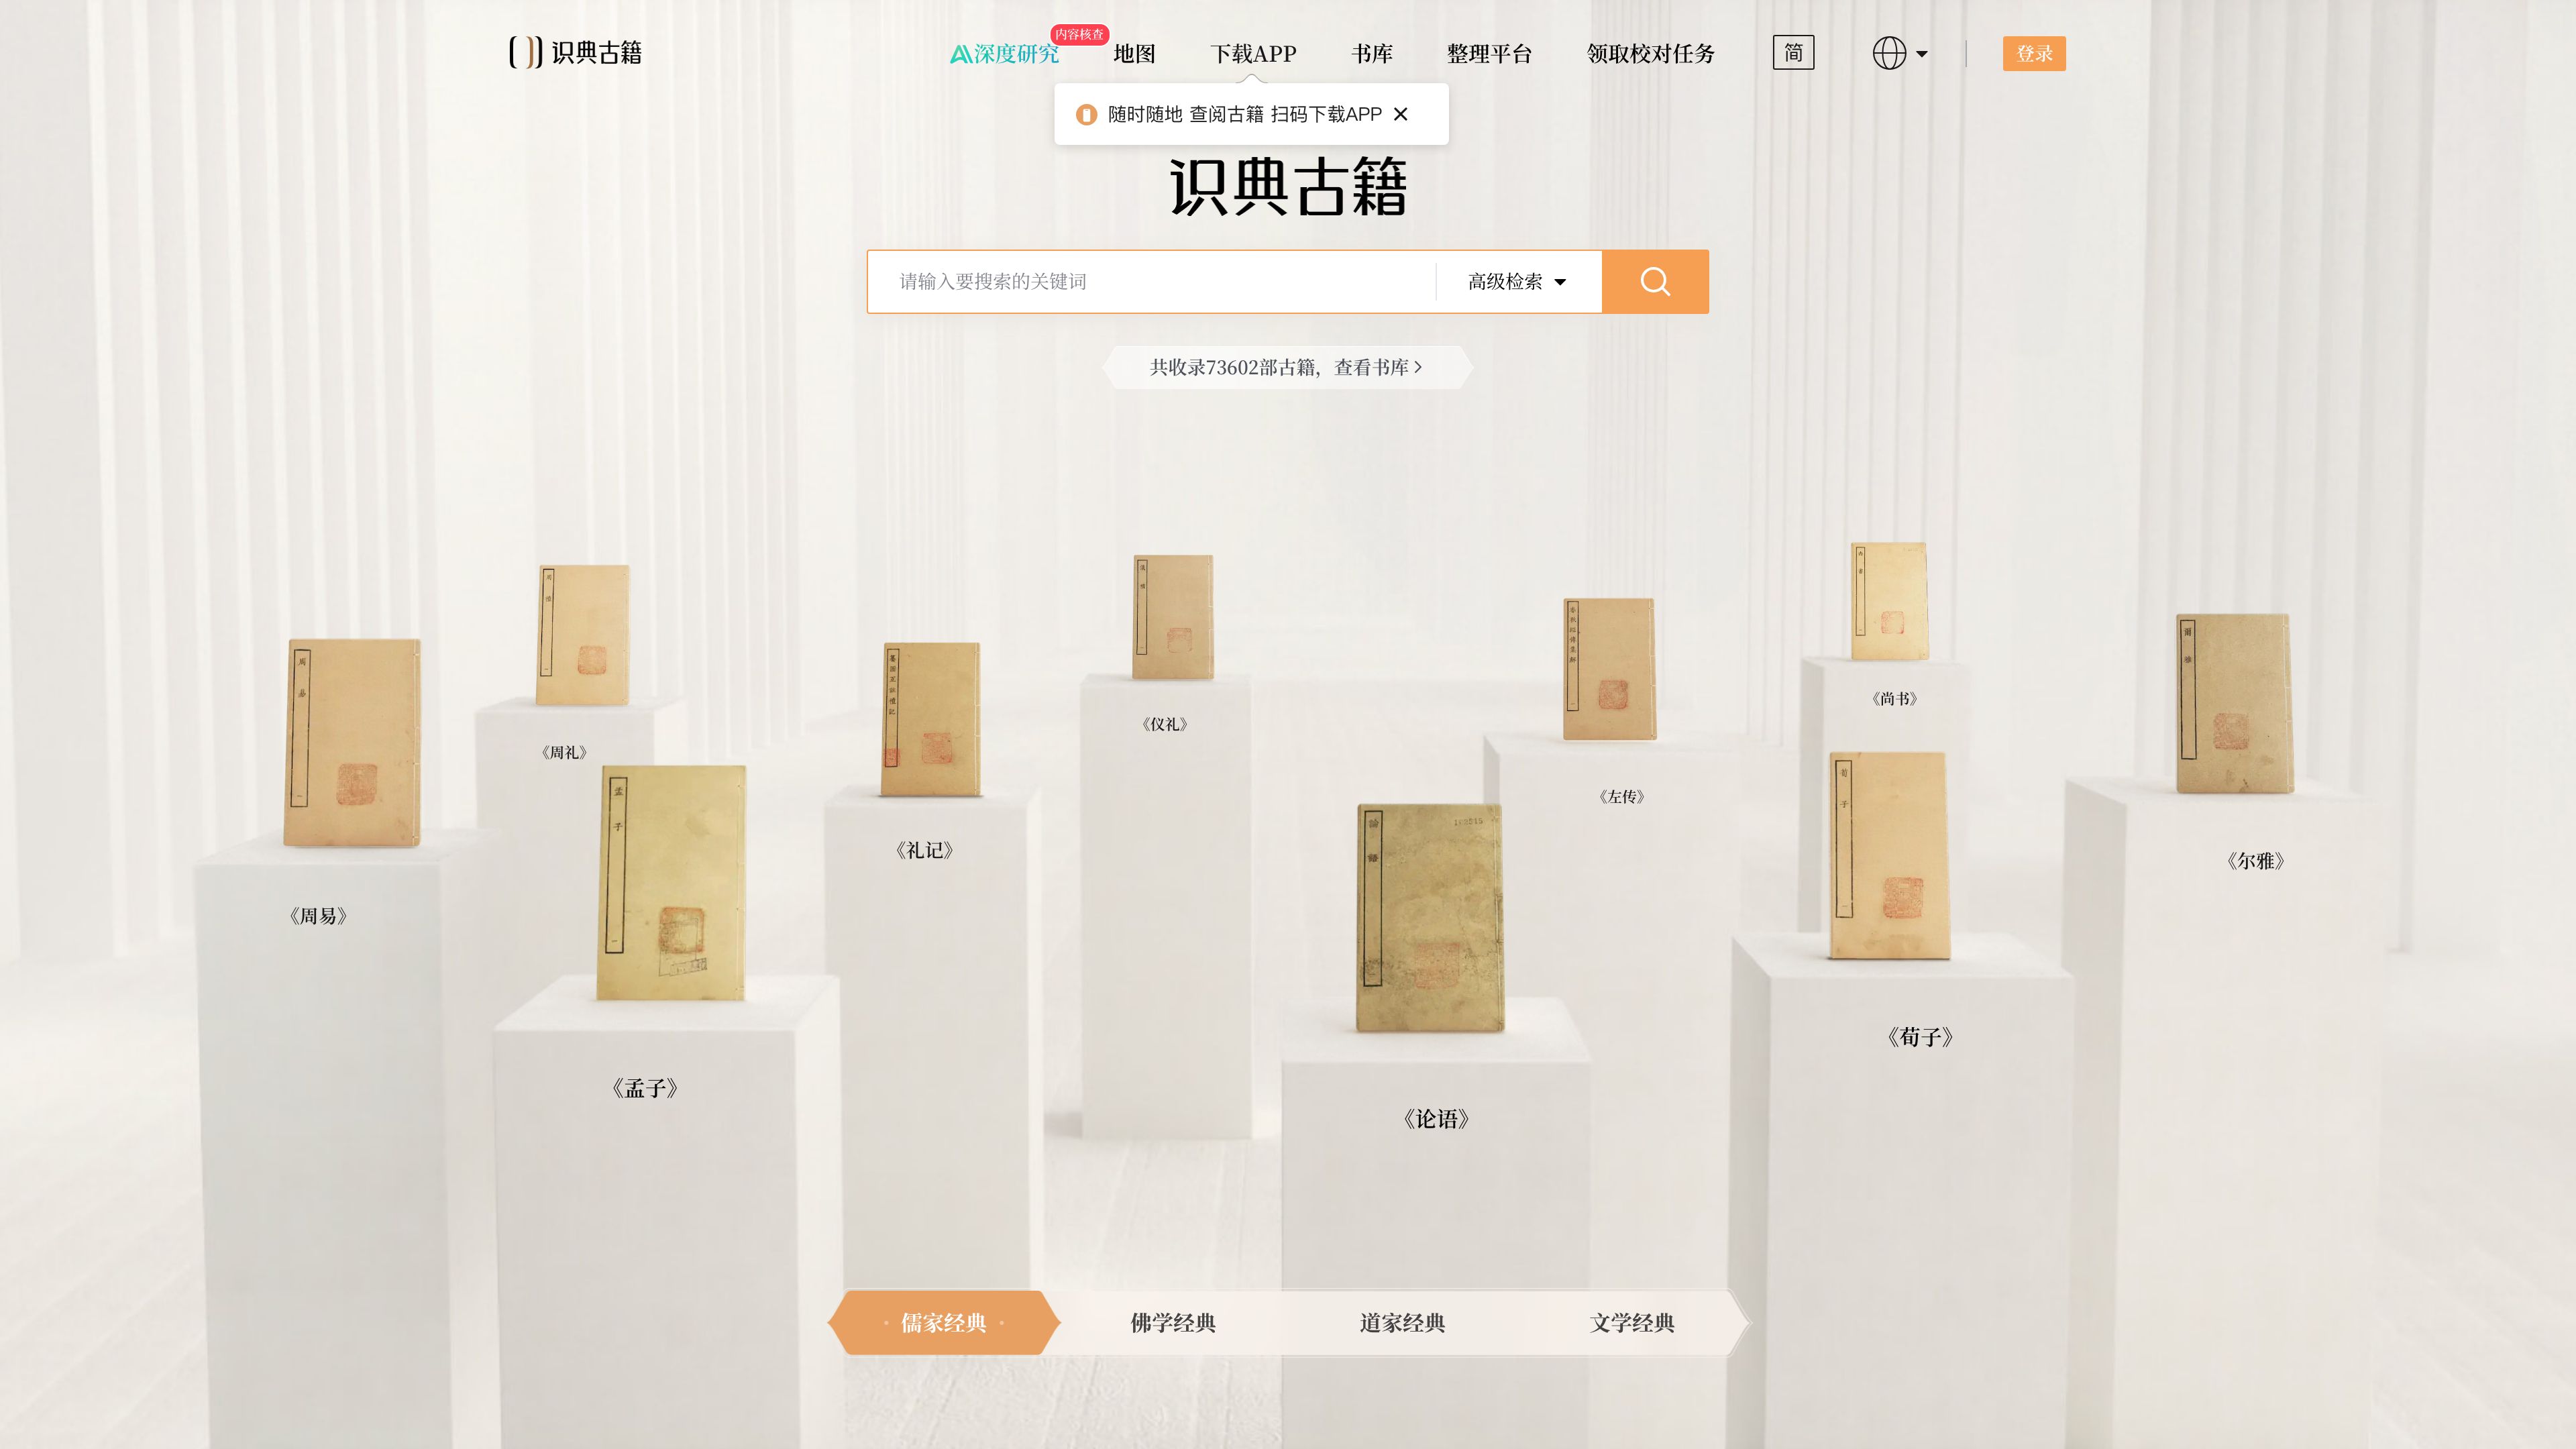
站点速览
- 网址:https://www.shidianguji.com/
- 类型:中国古籍数字阅读、全文检索与整理平台
- 费用:完全免费、无广告;官方公众号口径为"永久免费,没有广告"
- 注册要求:浏览书库、阅读正文、全文检索无需注册;书架、笔记、复制文本、深度研究和整理平台等功能需登录
- 界面语言:以简体中文为主,提供英文界面(书库条目附部分英文译名);正文支持机器繁简转换
- 移动端:2025 年上线 iOS 与 Android 独立 App;网页版保留原版影像对照
站点背景
平台由北京大学与抖音集团合作建设。据北京大学数字人文研究中心项目页,2022 年 3 月抖音集团向北京大学教育基金会捐赠,双方依托"北京大学-字节跳动数字人文开放实验室"共建该平台,期望解决古籍数字化利用的瓶颈,面向海内外学者和古籍爱好者免费开放。合作分工为:北大方面提供设计指导和古籍图文数据并组织专家整理校对,字节跳动捐赠资金并负责研发运营;平台"关于我们"页说明,北京大学提供的古籍图文数据版权归北京大学所有。
建设的现实背景是古籍数字化的断层:字节跳动公益 2022 年发布稿称,中国现存古籍约 20 万种,已完成影像扫描约 8 万种,而实现文本数字化的仅 3–4 万种——扫描影像无法全文检索,文本化才是"完全数字化"。
收录规模随时间持续扩大,引用时需注意口径时点:
- 2022 年 10 月 11 日测试版上线:390 部,主要来自《四部丛刊》(新华网)
- 2023 年末:2200 余部(北京大学新闻网)
- 2024 年末:10000 部;2025 年上半年突破 20000 部(字节跳动公益)
- 2026 年 8 月:超 7 万部免费开放阅读(北京日报);截至 2026-09-01,官网首页自报 73,602 部
书库与文本质量分级
书库按经部、史部、子部、集部、道教部、佛教部、出土文献部、文书档案部等一级分类组织,下设多级类目。条目显示书名、卷数、作者、年代、版本(如"四部丛刊景上海涵芬楼藏宋刊")和文本来源(如"北京大学-字节跳动古籍开放文本库"、《儒藏》)。
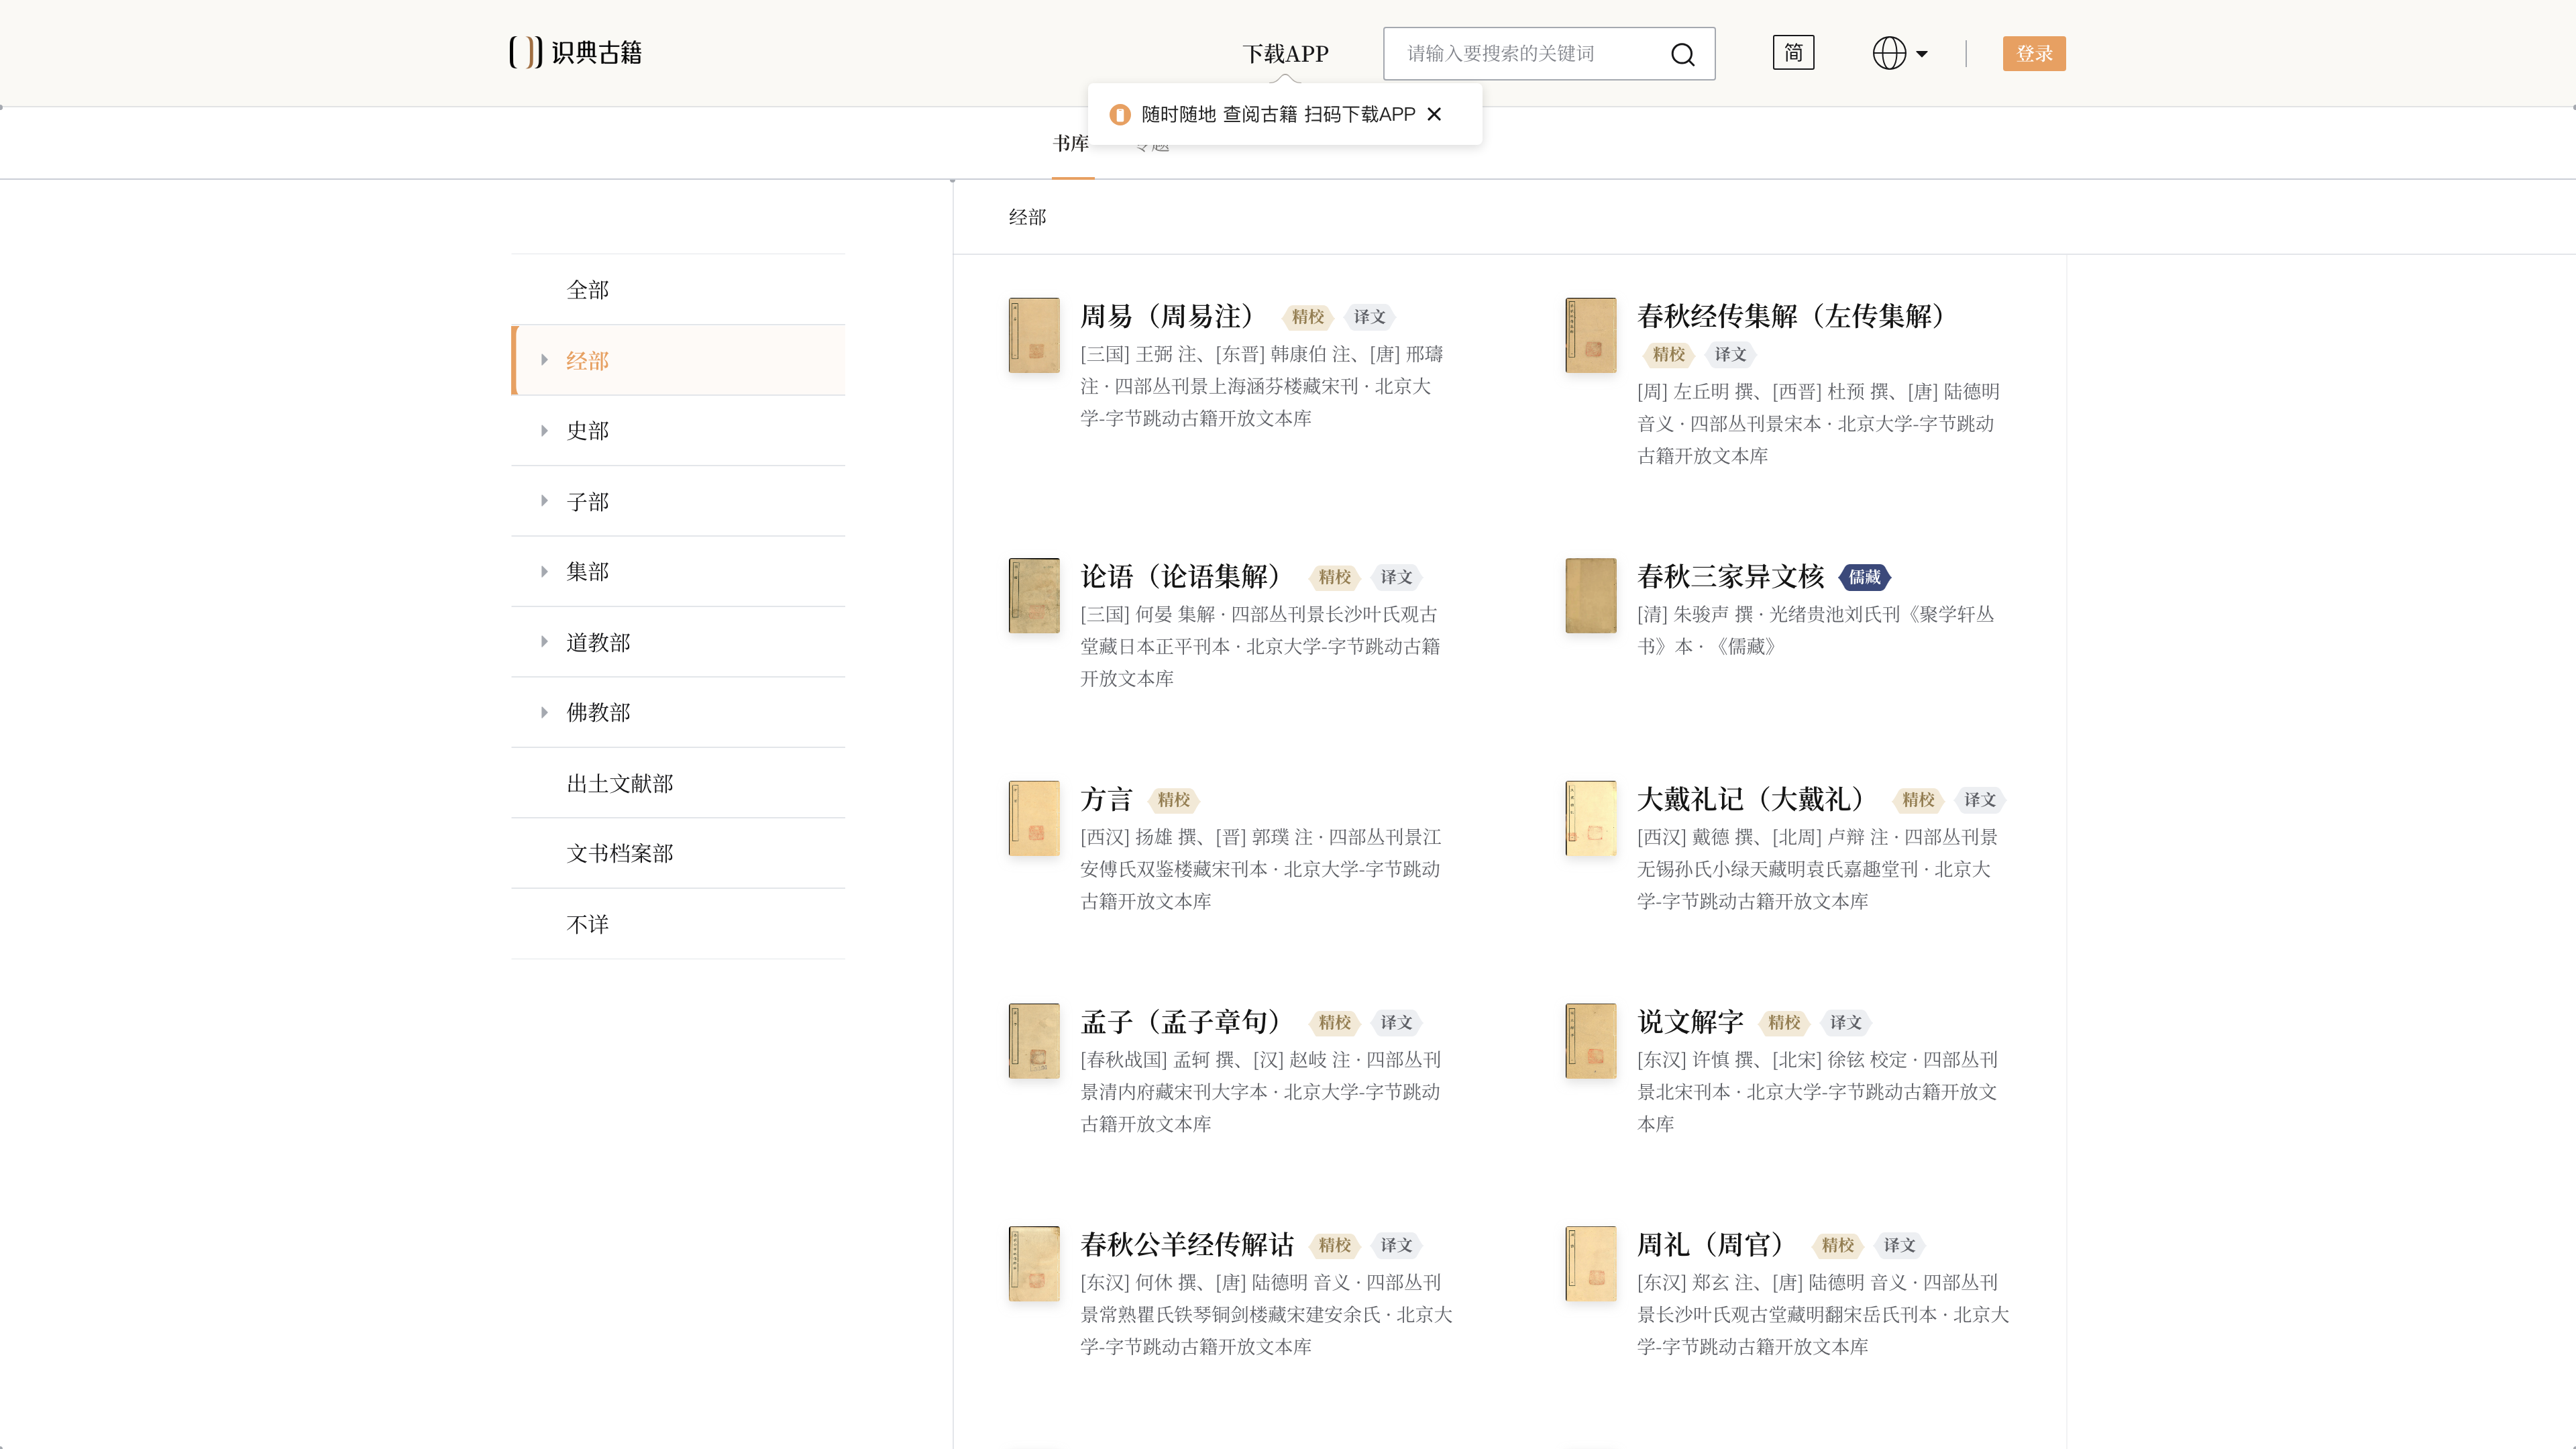
每条文本以角标标注质量等级:"精校"表示文字、标点与实体均经人工校对,"粗校"或"AI整理"表示机器处理结果;页面同时提示"该文本内容为机器处理结果,请结合原图阅读或使用"。这一分级机制让读者可以区分文本的可信程度,是正式引用前必须注意的信息。
全文检索
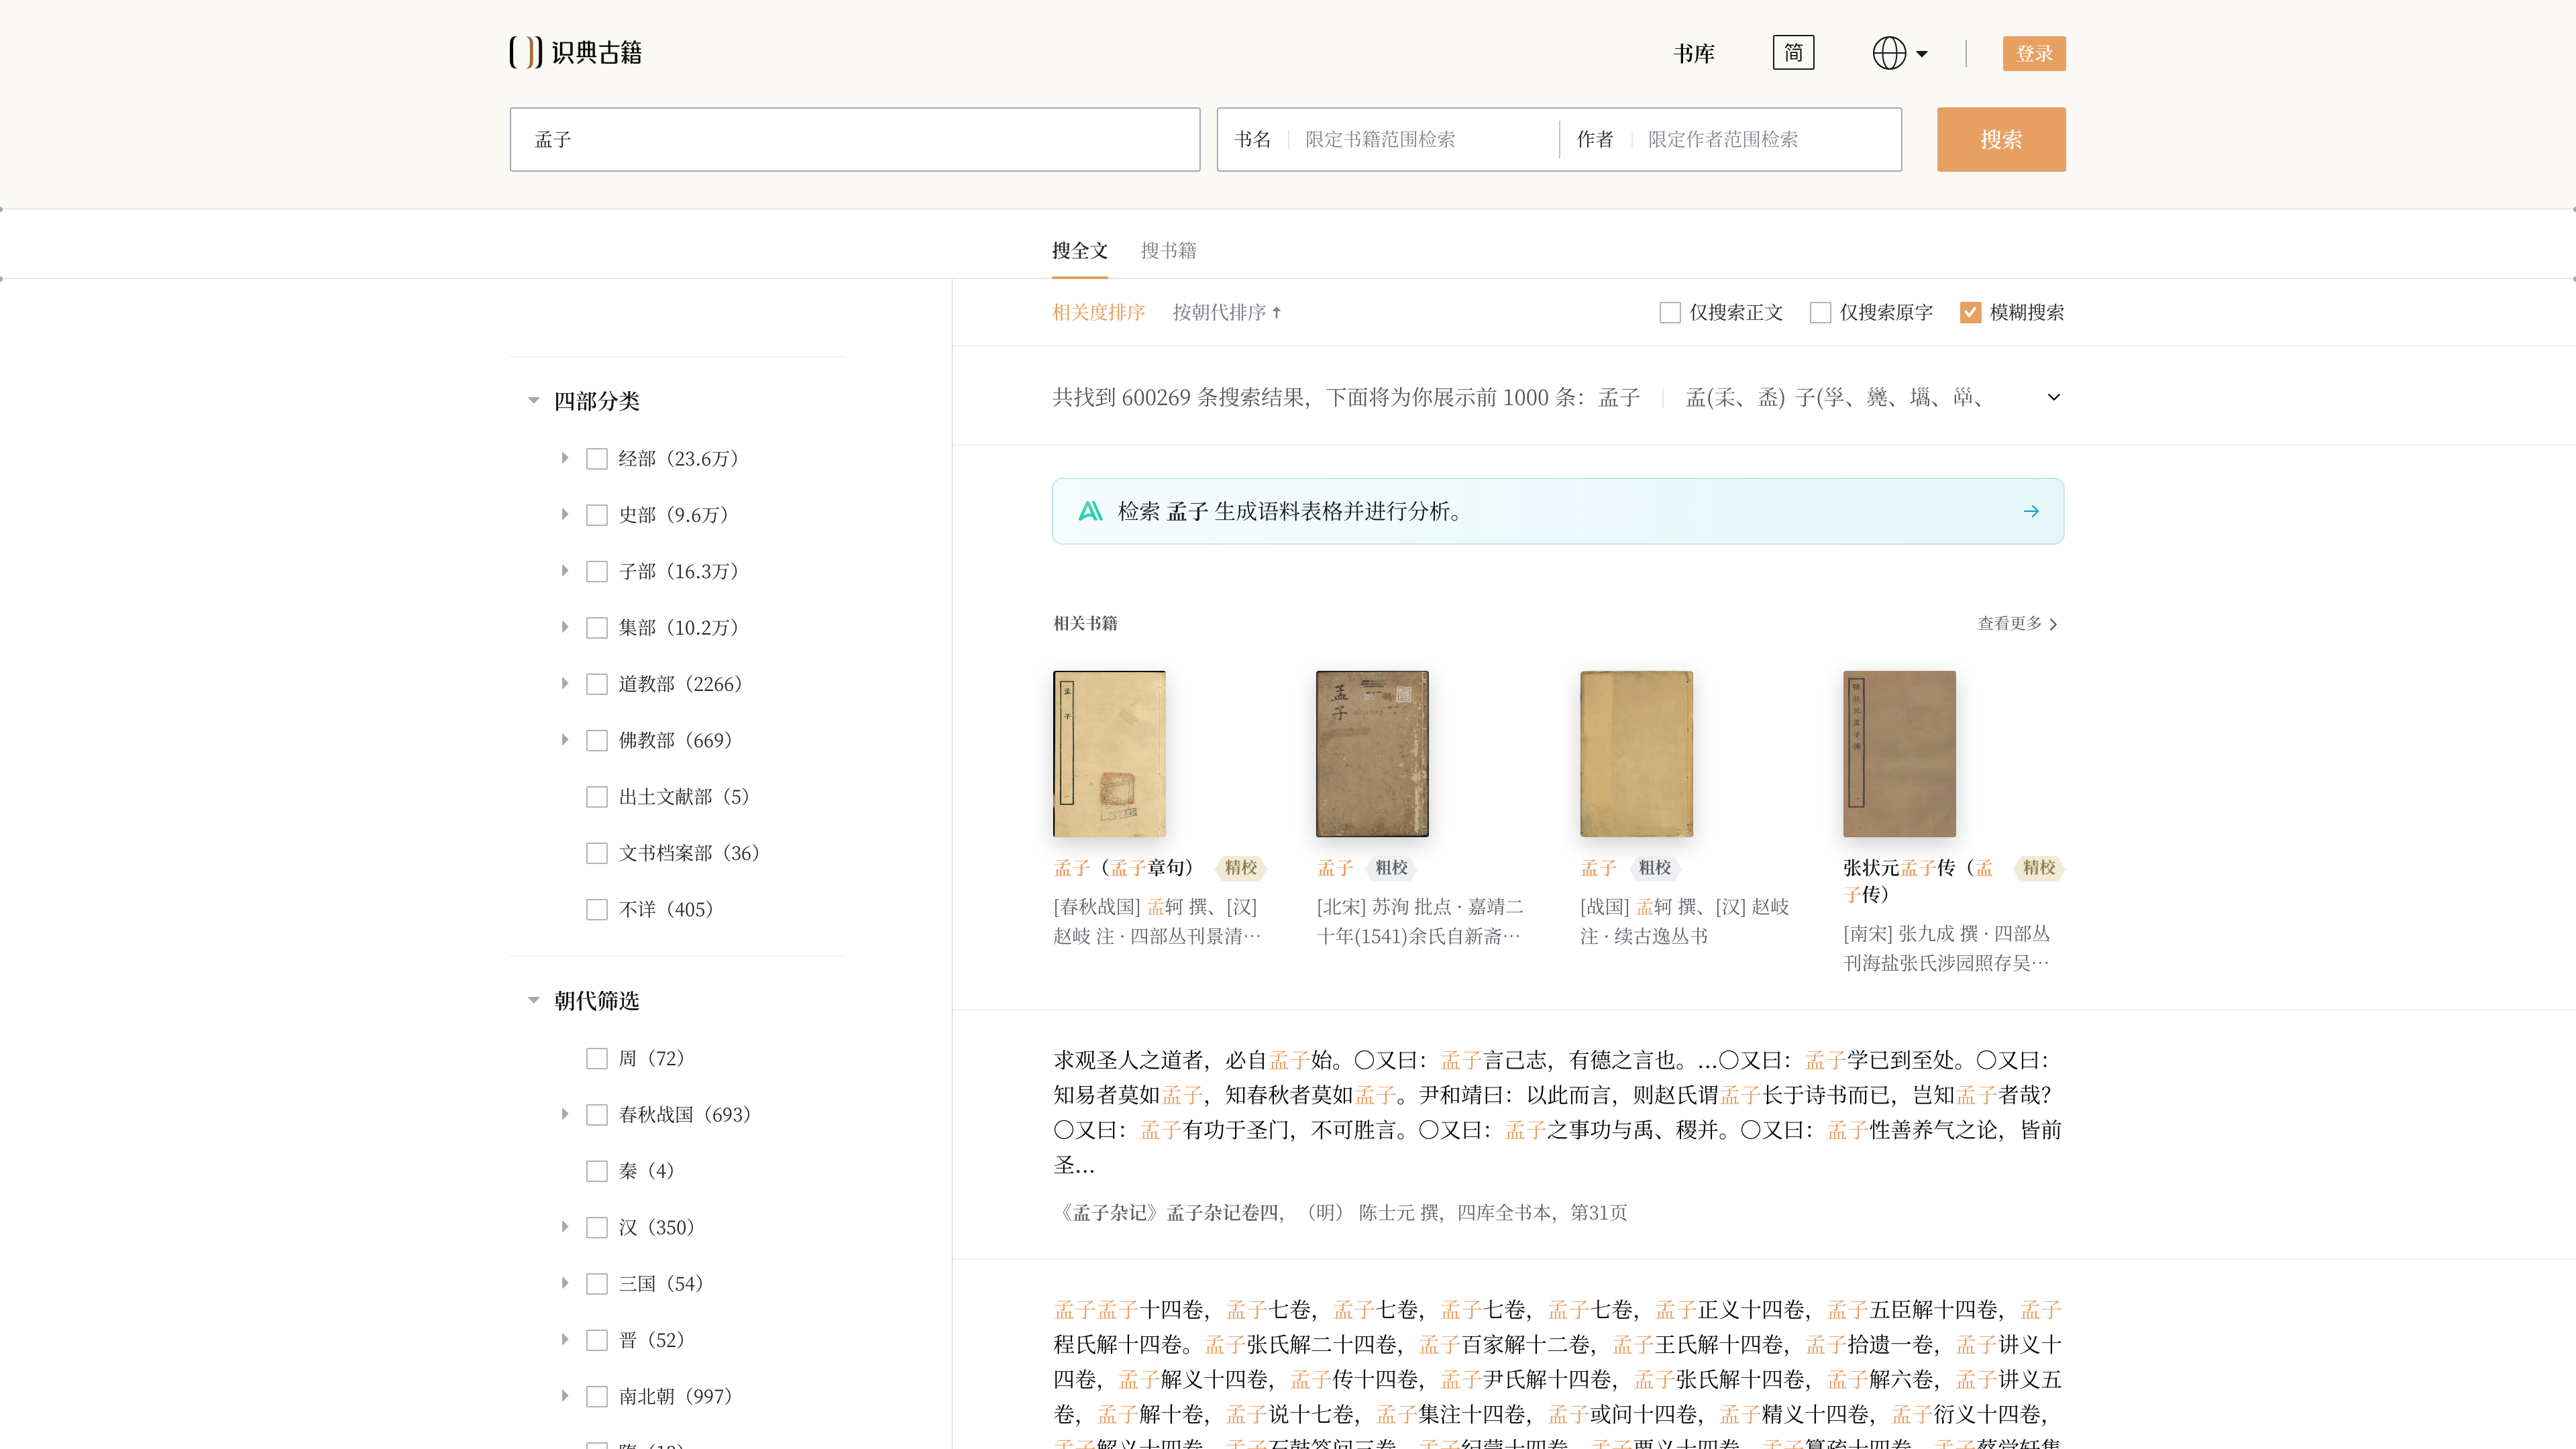
全文检索无需登录即可使用,支持"搜全文"与"搜书籍"两种模式。结果可按四部分类、朝代筛选,按相关度或朝代排序,并提供"仅搜索正文""仅搜索原字""模糊搜索"等选项;异体字会归并展示(例如检索"孟子"时提示"孟(𣏍、𥁪)子(㜽…)")。每条命中附书名、卷次、版本与页码出处,便于回溯原书。检索入口还提供"生成语料表格并进行分析"的语料分析功能。
阅读与辅助工具
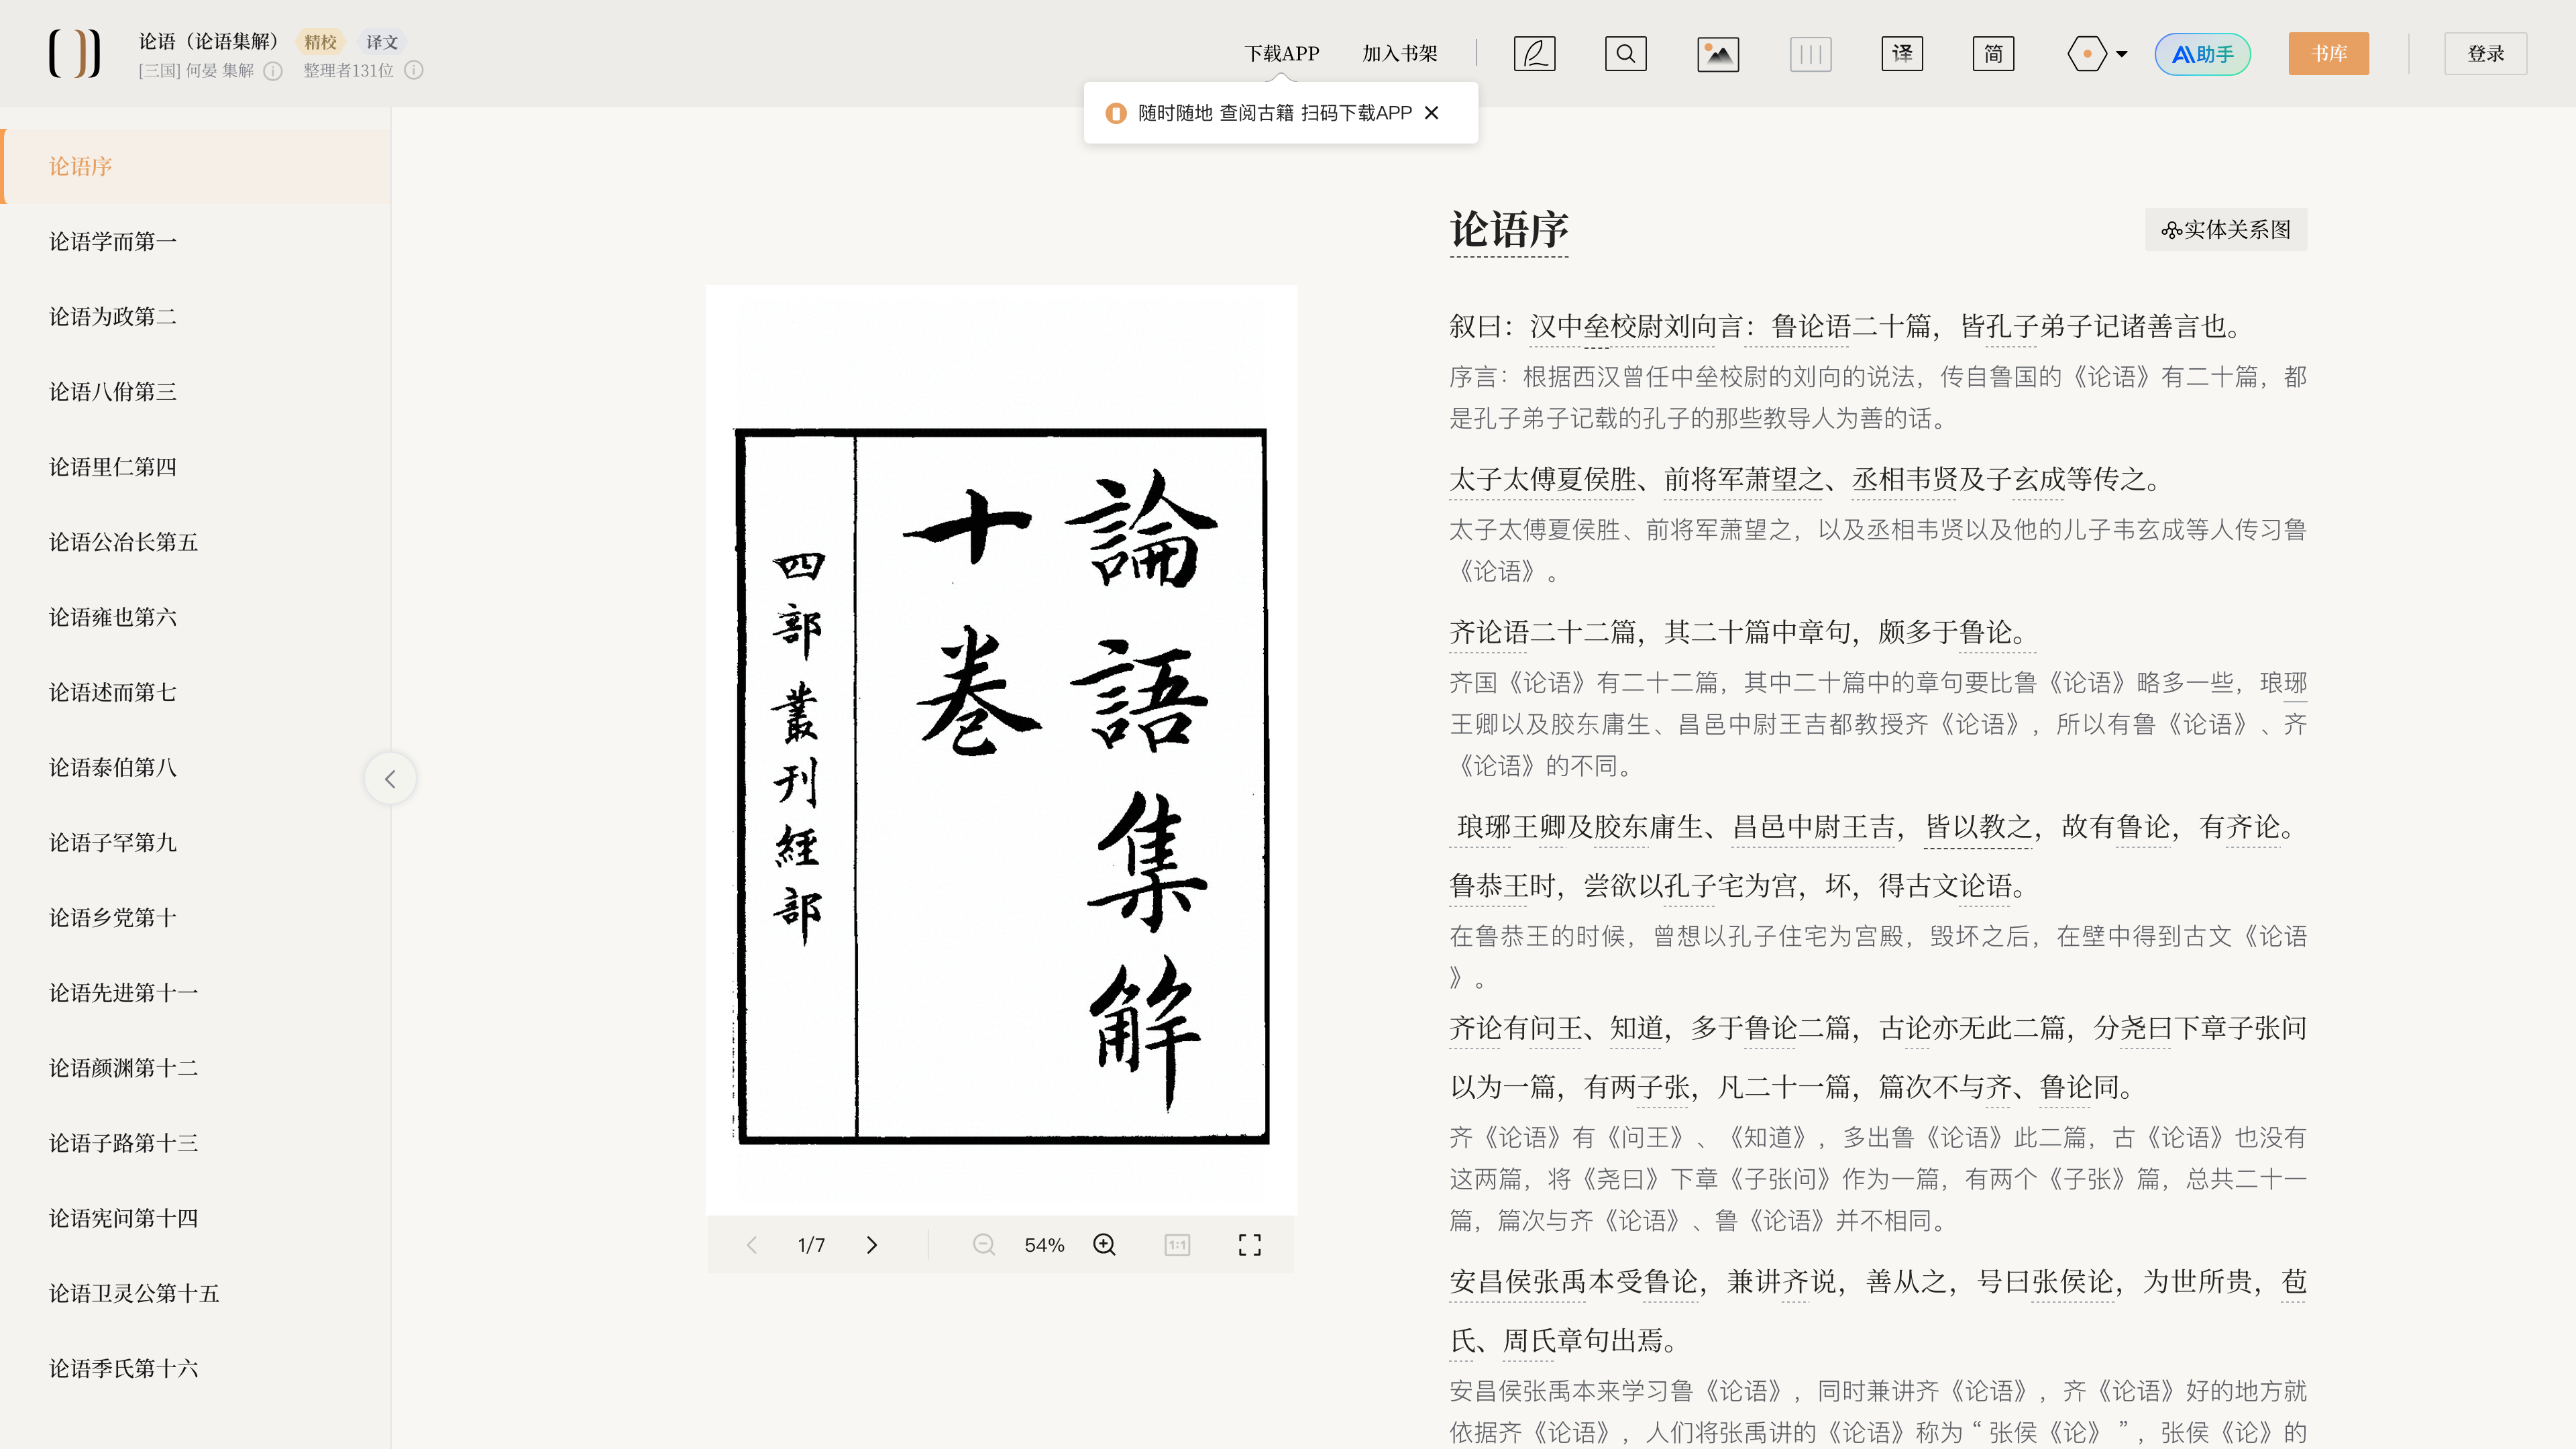
阅读页提供横排文本与现代标点,左侧为章节目录,可打开原本影像与整理文本同屏对照——文本可溯源到底本影像是平台的建设原则。辅助工具包括:注疏内容的显示与隐藏、机器繁简转换(页面标注"机器简体,仅供参考")、生僻词悬浮释义、人名地名专名号标注与可点击的实体百科,以及实体关系图和历史地图(页面声明部分数据由机器自动生成,可能有错误)。
AI 能力方面,北京日报 2026 年 8 月报道称平台已用 AI 将 1 万部古籍翻译成白话文;页面声明"白话翻译为人工检查过的机器翻译,仅供参考"。站内 AI 助手基于豆包大模型,页面提示"内容由AI生成,可能有错误,使用前注意查证",其中"深度研究"功能需登录后使用。
整理平台与众包校对
配套的古籍智能整理平台原为内部系统,2024 年起免费向有公益性古籍整理需求的个人和团队开放。据官方使用手册,平台整合 OCR(可识别 9.8 万字)、自动标点、自动结构整理、自动实体提取与多版本自动校勘,整理成果可发布回阅读平台共享。众包方面,"我是校书官"(2025 年起称"我用AI校古籍")组织公众参与 OCR 粗校与标点精校;北京大学新闻网 2026 年 1 月报道,累计近 3.8 万人参与、完成 2 万余部古籍整理,粗校字数达 15 亿、精校字数 1 亿。《儒藏》编纂工程 2025 年起也使用该平台。平台上的专题数据库还包括永乐大典高清影像数据库(2023 年公开 40 册影像)、科技典籍数据库(2026 年 8 月上线,首批 1982 部)等。
账号体系与开放能力
匿名状态下可浏览书库、阅读正文和全文检索;用户服务协议亦说明"您无需注册也可开始使用识典古籍及相关服务,但部分功能或服务可能会受到影响"。登录后(字节跳动账号体系,支持手机验证码、密码或经今日头条 App 扫码)可使用书架、笔记、专题书单、复制文本与查看引用(页面提示有额度上限)、深度研究、整理平台和领取校对任务。
平台未见公开的官方 API 或批量数据下载渠道;学术界通常以"北京大学-字节跳动古籍开放文本库"的名义引用其文本。内容接口有严格的反爬风控,不利于程序化批量利用。
版权与内容政策
古籍原文本身属公有领域,但《识典古籍用户服务协议》对站内内容的使用设有明确限制:未经书面许可不得将平台内容用于商业用途,不得擅自编辑、整理、编排后在站外渠道展示,并禁止盗链、抓取及用机器人程序复制、下载平台内容(2.4、4.3、4.4、7.5 条);北京大学提供的古籍图文数据版权归北京大学所有。平台公布的侵权投诉与合作联系邮箱为 guji@bytedance.com。
适用场景
- 查证某句话在传世典籍中的出处:全文检索直接给出书名、卷次、版本与页码。
- 阅读常见经典的整理文本,并结合原本影像核对关键字句。
- 数字人文研究的语料初查、实体关系与历史地理信息浏览。
- 有公益性质古籍整理需求的个人或团队,免费使用 OCR 与校勘流水线。
局限
- 机器文本准确率有限:官方 2022 年口径称 OCR 识别准确率 96%–97%,即每百字约有 3–4 字误差;粗校文本的标点与实体识别未经人工校对,正式引用须核对原图。
- 白话翻译、繁简转换与 AI 助手输出均为机器生成,平台自身均标注"仅供参考"或提示查证。
- 复制文本与查看引用需登录且有额度上限;无公开 API 或数据集下载,批量利用受协议与风控双重限制。
- 收录以汉文中国古籍为中心,传世典籍为主,兼及佛藏、道藏、出土文献、方志等;具体某部书是否有影像取决于底本来源。
- 界面以中文为主,英文界面覆盖有限。
同类参考
- 中国哲学书电子化计划:学术向的汉籍全文检索库,原文与影像逐段对照,高级功能需付费订阅。
- 书格:公有领域古籍高清影像下载站,侧重影像本身而非可检索文本。
- 中华经典古籍库:中华书局运营的商业古籍文本库,面向机构订阅。
参考资料
- 识典古籍官网首页(核查日期:2026-09-01)
- 关于我们 - 识典古籍(核查日期:2026-09-01)
- 识典古籍用户服务协议(核查日期:2026-08-30)
- 整理平台简介|"识典古籍"整理平台使用手册(核查日期:2026-08-30)
- 识典古籍阅读与整理平台 - 北京大学数字人文研究中心(核查日期:2026-08-30)
- 北大携字节跳动推出古籍数字化平台 - 新华网(核查日期:2026-08-30)
- 汇集《永乐大典》等2200余部古籍 - 北京大学新闻网(核查日期:2026-08-30)
- 三年,20000部古籍 - 字节跳动公益(核查日期:2026-08-30)
- "我用AI校古籍"(2025年)总结会举行 - 北京大学新闻网(核查日期:2026-08-30)
- 超7万部古籍从"纸"到"网",读者可免费云端阅读 - 北京日报(核查日期:2026-08-30)
- 终于,识典古籍APP来了 - 识典古籍公众号(安庆师范大学图书馆转载)(核查日期:2026-08-30)



