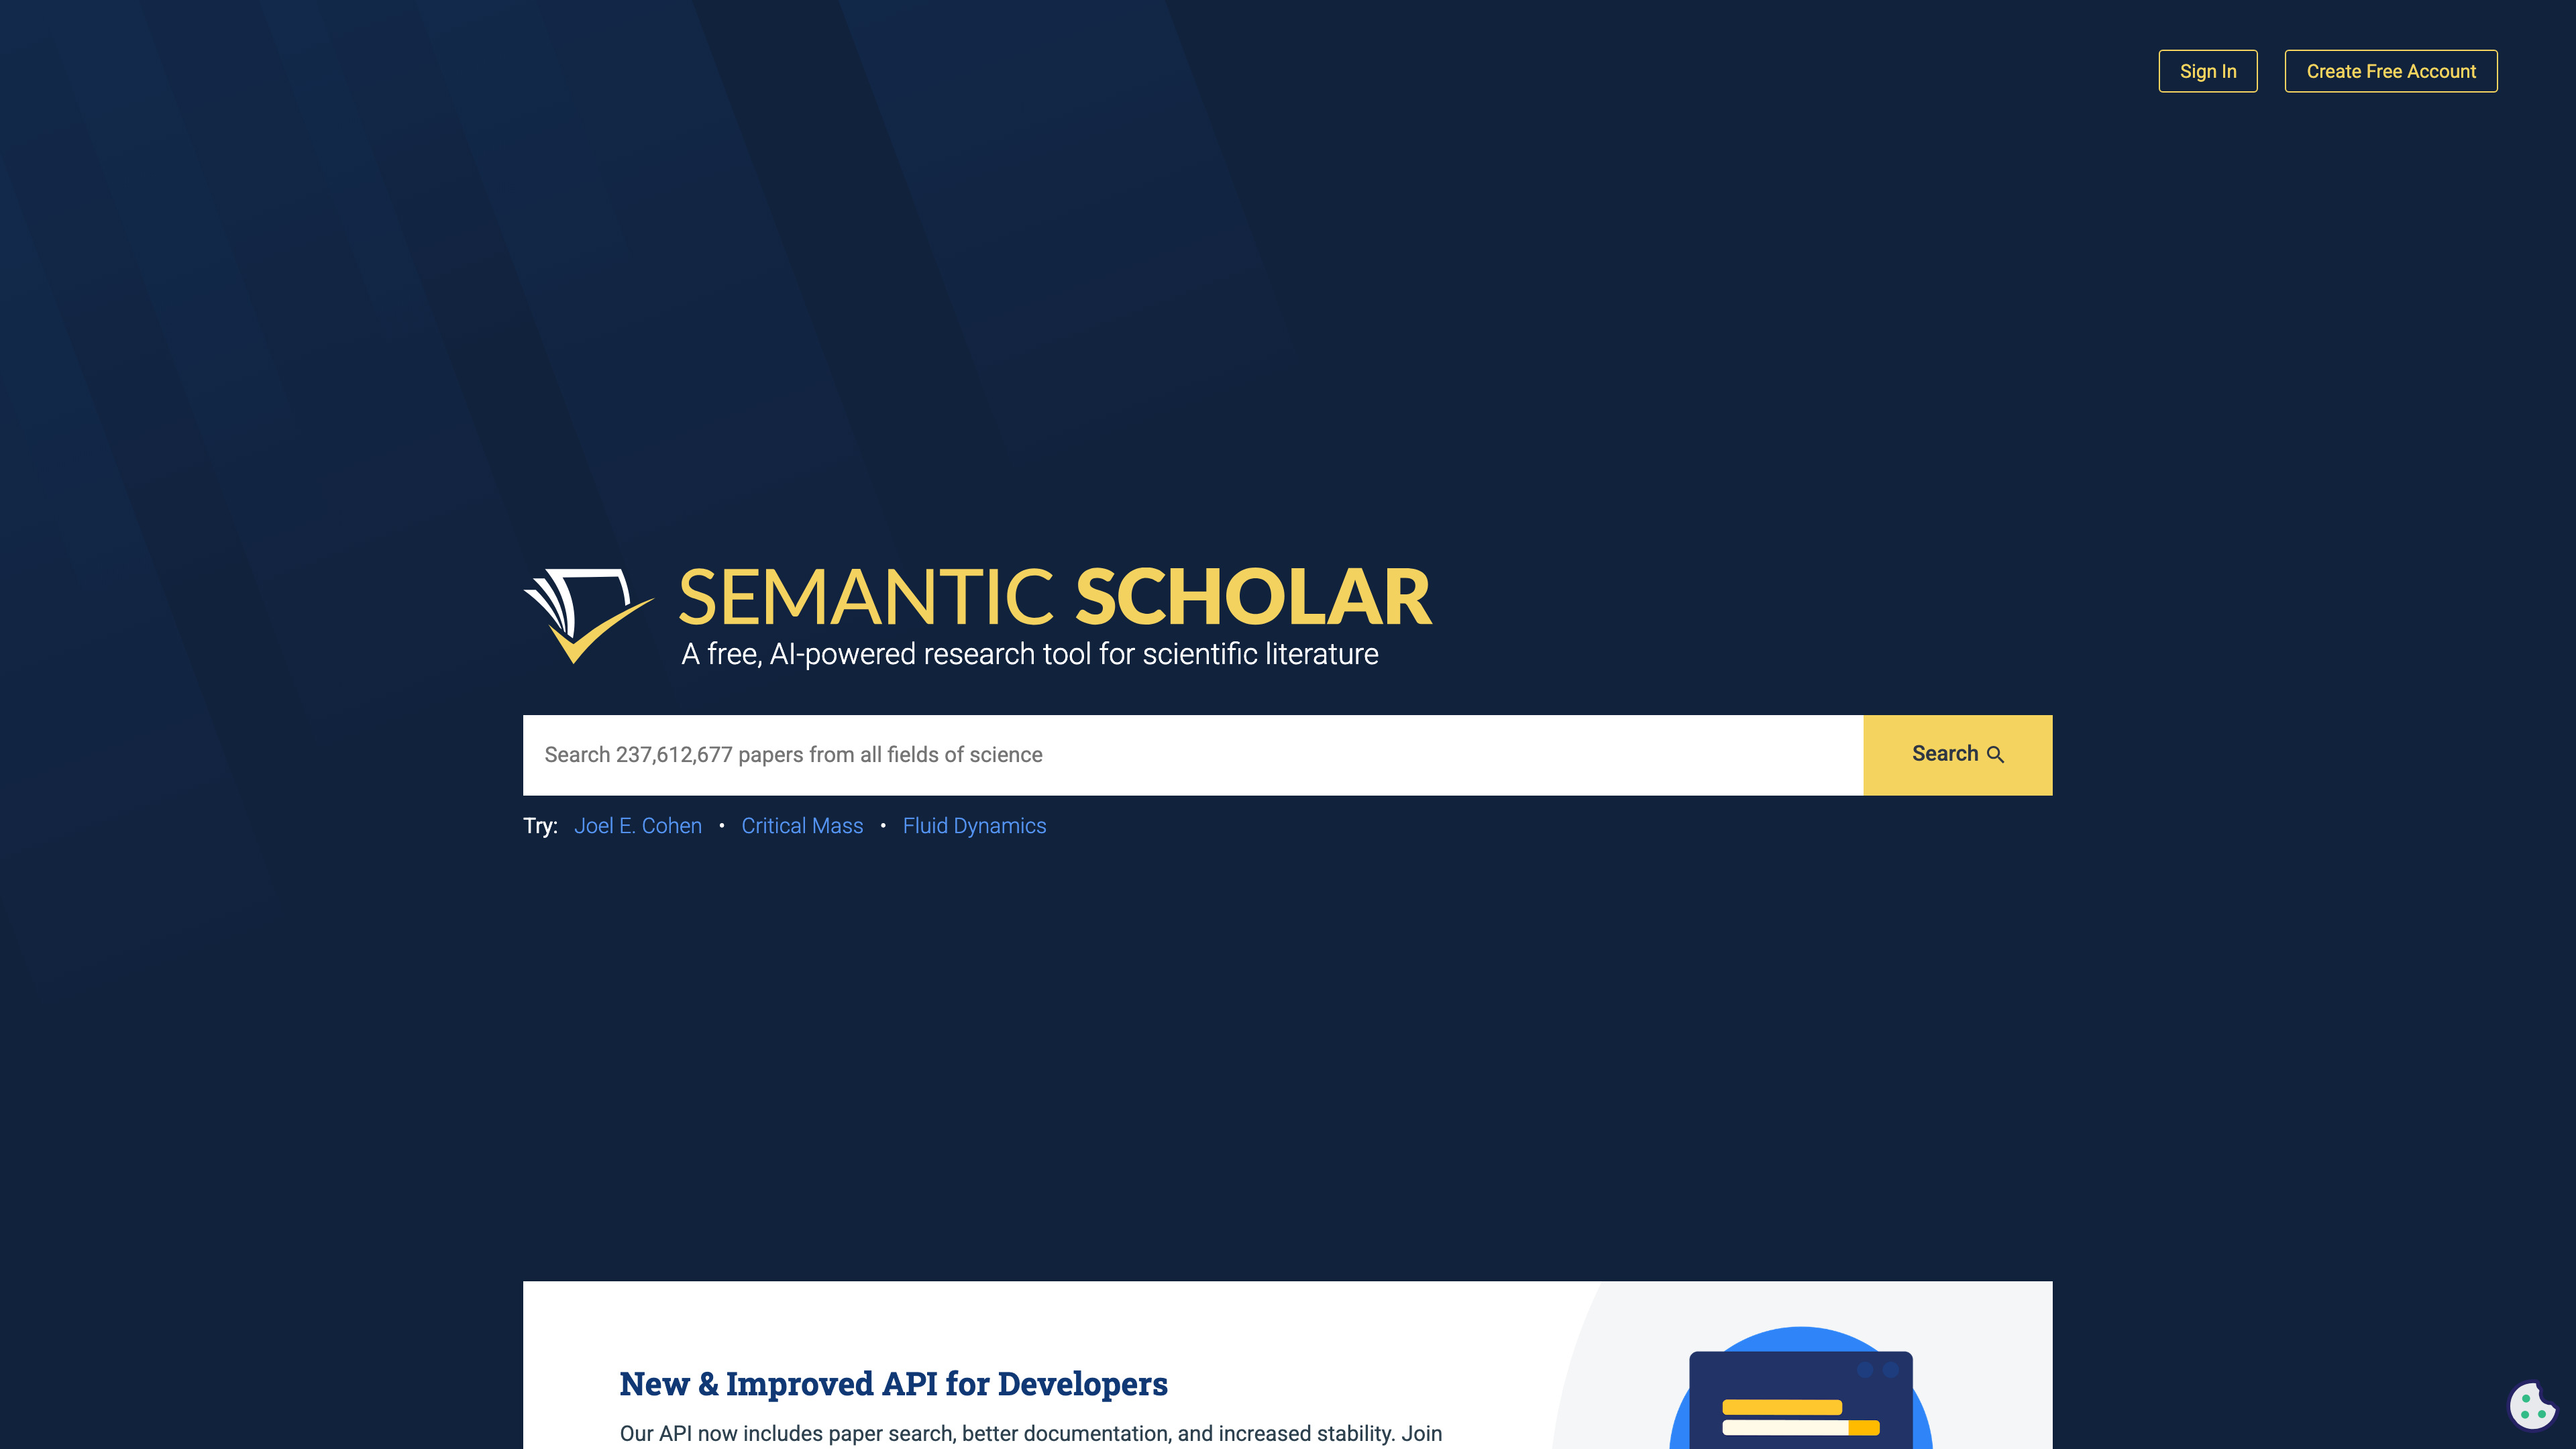
Semantic Scholar(semanticscholar.org)是由非营利研究机构 Allen Institute for AI(Ai2)运营的免费学术搜索引擎,面向需要快速筛选文献和获取引文数据的研究者。它对收录的论文运行自然语言处理模型,在论文页和检索结果中给出单句 TLDR 摘要,把引用按背景、方法、结果扩展三类意图标注,并用机器学习模型识别高影响力引用。与 Google Scholar 等通用学术搜索相比,它可核实的差异在于:公开说明收录规模与数据来源(截至 2026-08-31,首页搜索框显示收录 237,612,676 篇),并提供免费 API 与可下载数据集,Connected Papers、Litmaps 等文献工具建立在这些接口之上(API 概览)。
站点速览
- 网址:https://www.semanticscholar.org/
- 类型:学术搜索引擎与学术图谱数据平台
- 费用:免费;API 密钥通过表单免费申请(API 概览)
- 注册要求:检索、浏览论文页和下载数据集无需账号;文献库、邮件提醒、研究动态与认领作者页需要免费账号(FAQ)
- 界面语言:英文;收录语料也以英文出版为主(FAQ)
站点背景
Ai2 是微软联合创始人 Paul Allen 于 2014 年创立的非营利研究机构,Semantic Scholar 于 2015 年作为其研究工程项目上线(About)。团队在内部研发论文处理与分类模型,同时发布开放代码与数据集,并在自然语言处理、机器学习、人机交互与信息检索方向发表论文;About 页将"促进科学的平等获取"列为机构价值观之一。
内容来源方面,官方说明索引规模超过两亿篇,来自出版商合作、数据提供商与网络抓取(About)。其中直接合作方超过 50 家出版商、数据提供商与聚合平台,内容涉及 500 余种学术期刊、大学出版社与学术团体(Publishers);FAQ 列举的来源包括 PubMed、arXiv、Springer Nature 等(FAQ)。API 页面给出的图谱规模为 2.14 亿篇论文、24.9 亿条引用与 7900 万名作者(截至 2026-08-31,API 概览)。
AI 语义特征
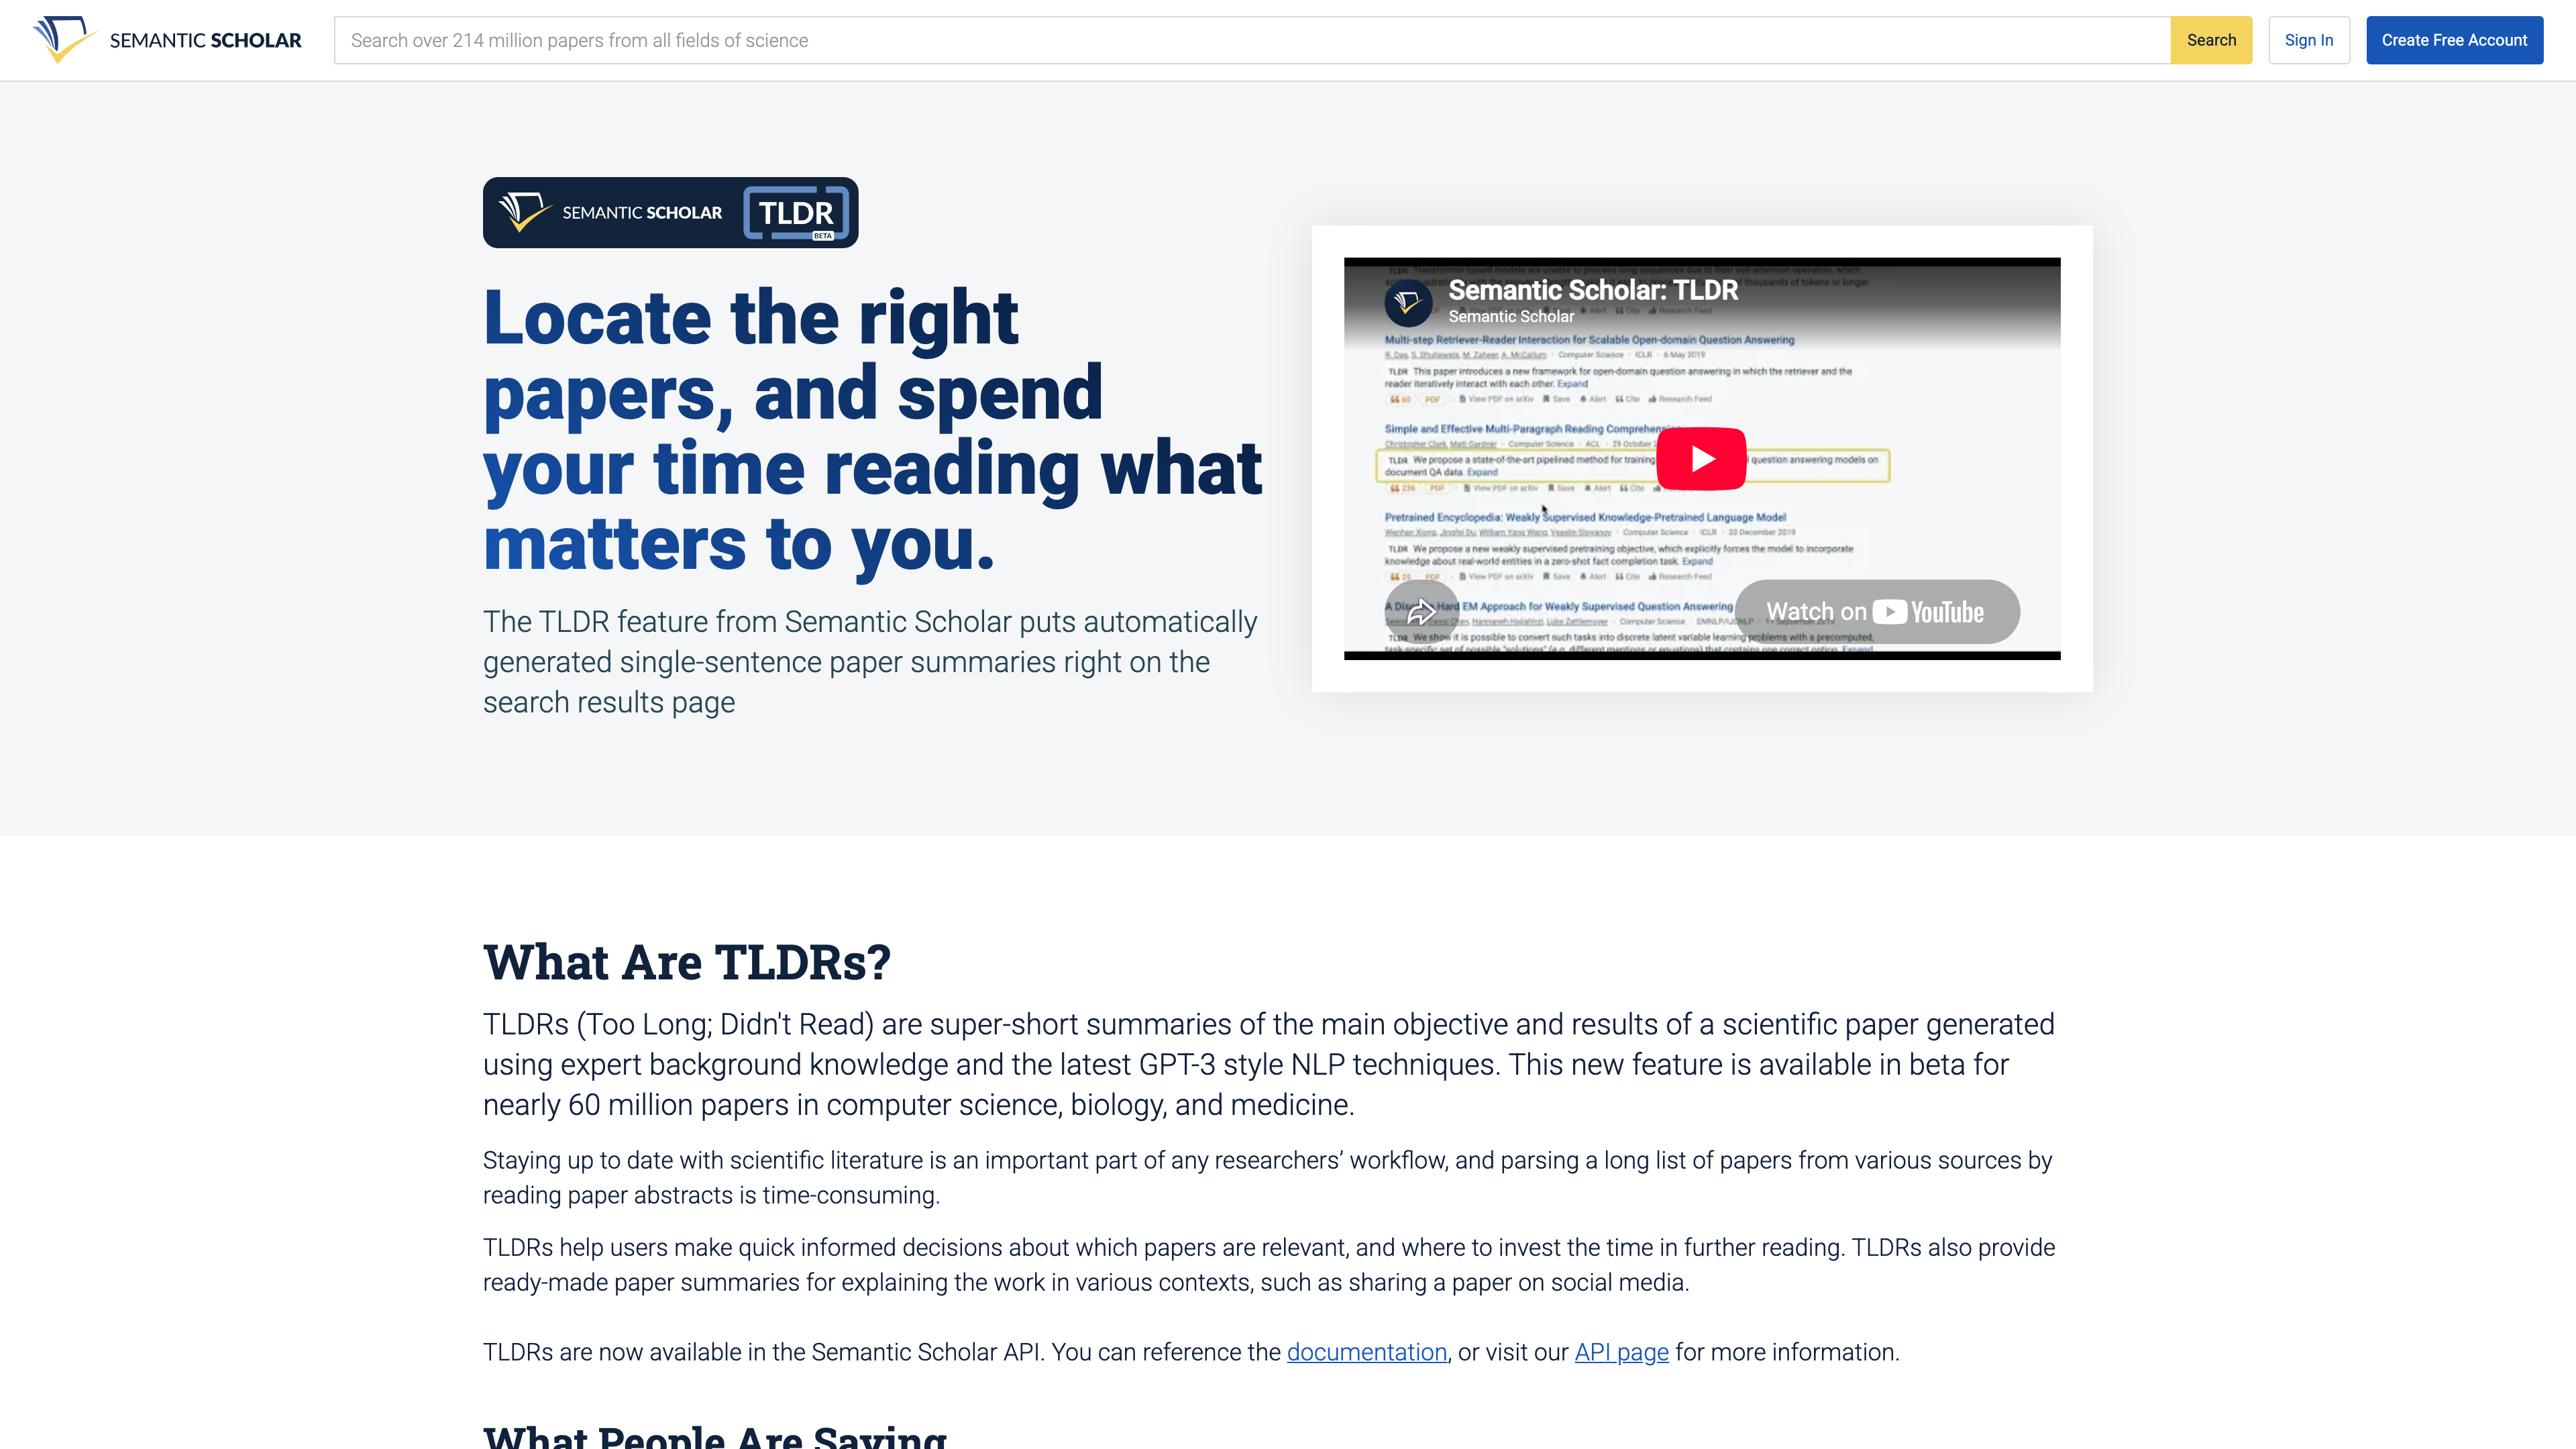
TLDR 摘要。 检索结果和论文页上的 TLDR 是模型生成的单句摘要,概括论文的目标与结果,用于在通读摘要前做初筛。官方说明该功能处于 beta 阶段,覆盖计算机科学、生物学与医学领域的近 6000 万篇论文(TLDR 功能页),对应研究为《TLDR: Extreme Summarization of Scientific Documents》;数据集中的 tldrs 子集现有约 5800 万条记录(截至 2026-08-31,数据集发布接口)。
引用分析。 论文的引用列表会标注引用意图:背景引用提供历史脉络与重要性论证,方法引用沿用已有实验流程,结果引用在先前发现之上扩展(FAQ)。"高影响力引用"由机器学习模型结合引用数量与引用上下文判定,用于识别被引文献对施引文献产生实质影响的情形;官方同时说明该判定依赖对施引论文全文的获取,全文不可得时可能漏判(FAQ)。引用计数方面,官方明确其语料以正式发表的论文与预印本为主,书籍覆盖很少、不包含专利,与其他网站的计数存在差异(FAQ)。
检索与排序。 搜索结果可按相关性、引用数、最有影响力和时间排序;不支持布尔运算符与通配符,引号短语检索可用(FAQ)。搜索重排序模型在 allenai/s2search 仓库开源(GitHub)。学科分类由基于标题与摘要的机器学习分类器完成,每篇论文最多标注三个学科,目前仅支持英文论文(FAQ)。
作者档案与消歧。 作者页面基于公开来源与合作出版商的数据自动生成,同名作者通过 2021 年 6 月上线的 S2AND 消歧模型区分;研究者可认领自己的作者页,增删论文、补充机构与 ORCID 等信息(FAQ)。
生成式 AI 功能与准确性说明。 Ask This Paper 调用 OpenAI 的 gpt-3.5-turbo-16k 结合论文内容回答问题,阅读器中的术语划词解释与 Topic 页同样由大语言模型生成;官方 FAQ 对这类功能设有专门警示,说明生成文本可能包含难以察觉的事实错误、措辞不当或不相关信息,建议用户尽量核实(FAQ)。Topic 页目前仅覆盖计算机科学;用于增强阅读的 Semantic Reader 处于 beta 阶段,目前仅支持 arXiv 来源论文,官方称已覆盖超过 25 万篇(FAQ)。
账号与开放数据
账号体系。 免费账号支持邮箱、Google 或机构身份注册,机构登录通过与 OpenAthens、eduGAIN、InCommon 的合作实现;登录后可经 GetFTR 与 LibKey 直达机构已订阅的付费论文全文(FAQ)。账号功能包括文献库(可建公开分享链接)、作者/论文/主题邮件提醒、研究动态(Research Feeds)推荐与认领作者页;站点另有 Chrome 与 Firefox 浏览器扩展(FAQ)。
API 与数据集。 Academic Graph API 提供论文、作者、引用、期刊与 SPECTER2 向量等数据,另有推荐 API 与数据集 API(API 概览、API 文档)。多数端点无需认证即可访问,未认证请求在全体匿名用户间共享每秒 1000 次的限额,高峰期可能进一步受限;申请个人 API 密钥后的初始限额为每秒 1 次,更高限额经审核后授予(API 概览)。
全量数据以 S2AG 数据集形式定期发布,包含论文、摘要、引用、作者、TLDR、S2ORC 全文与 SPECTER 向量等子集(数据集文档);截至 2026-08-31 最新版本为 2026-08-25,发布序列大致按周滚动(发布列表)。S2ORC 是面向 NLP 与文本挖掘研究设计的语料,以 JSON 形式提供开放获取论文全文的结构化解析(About、GitHub)。官方将这些数据集列为免费开放的资源,请求在发表研究中注明引用,API 使用受专门的许可协议约束(API 概览、API License Agreement)。
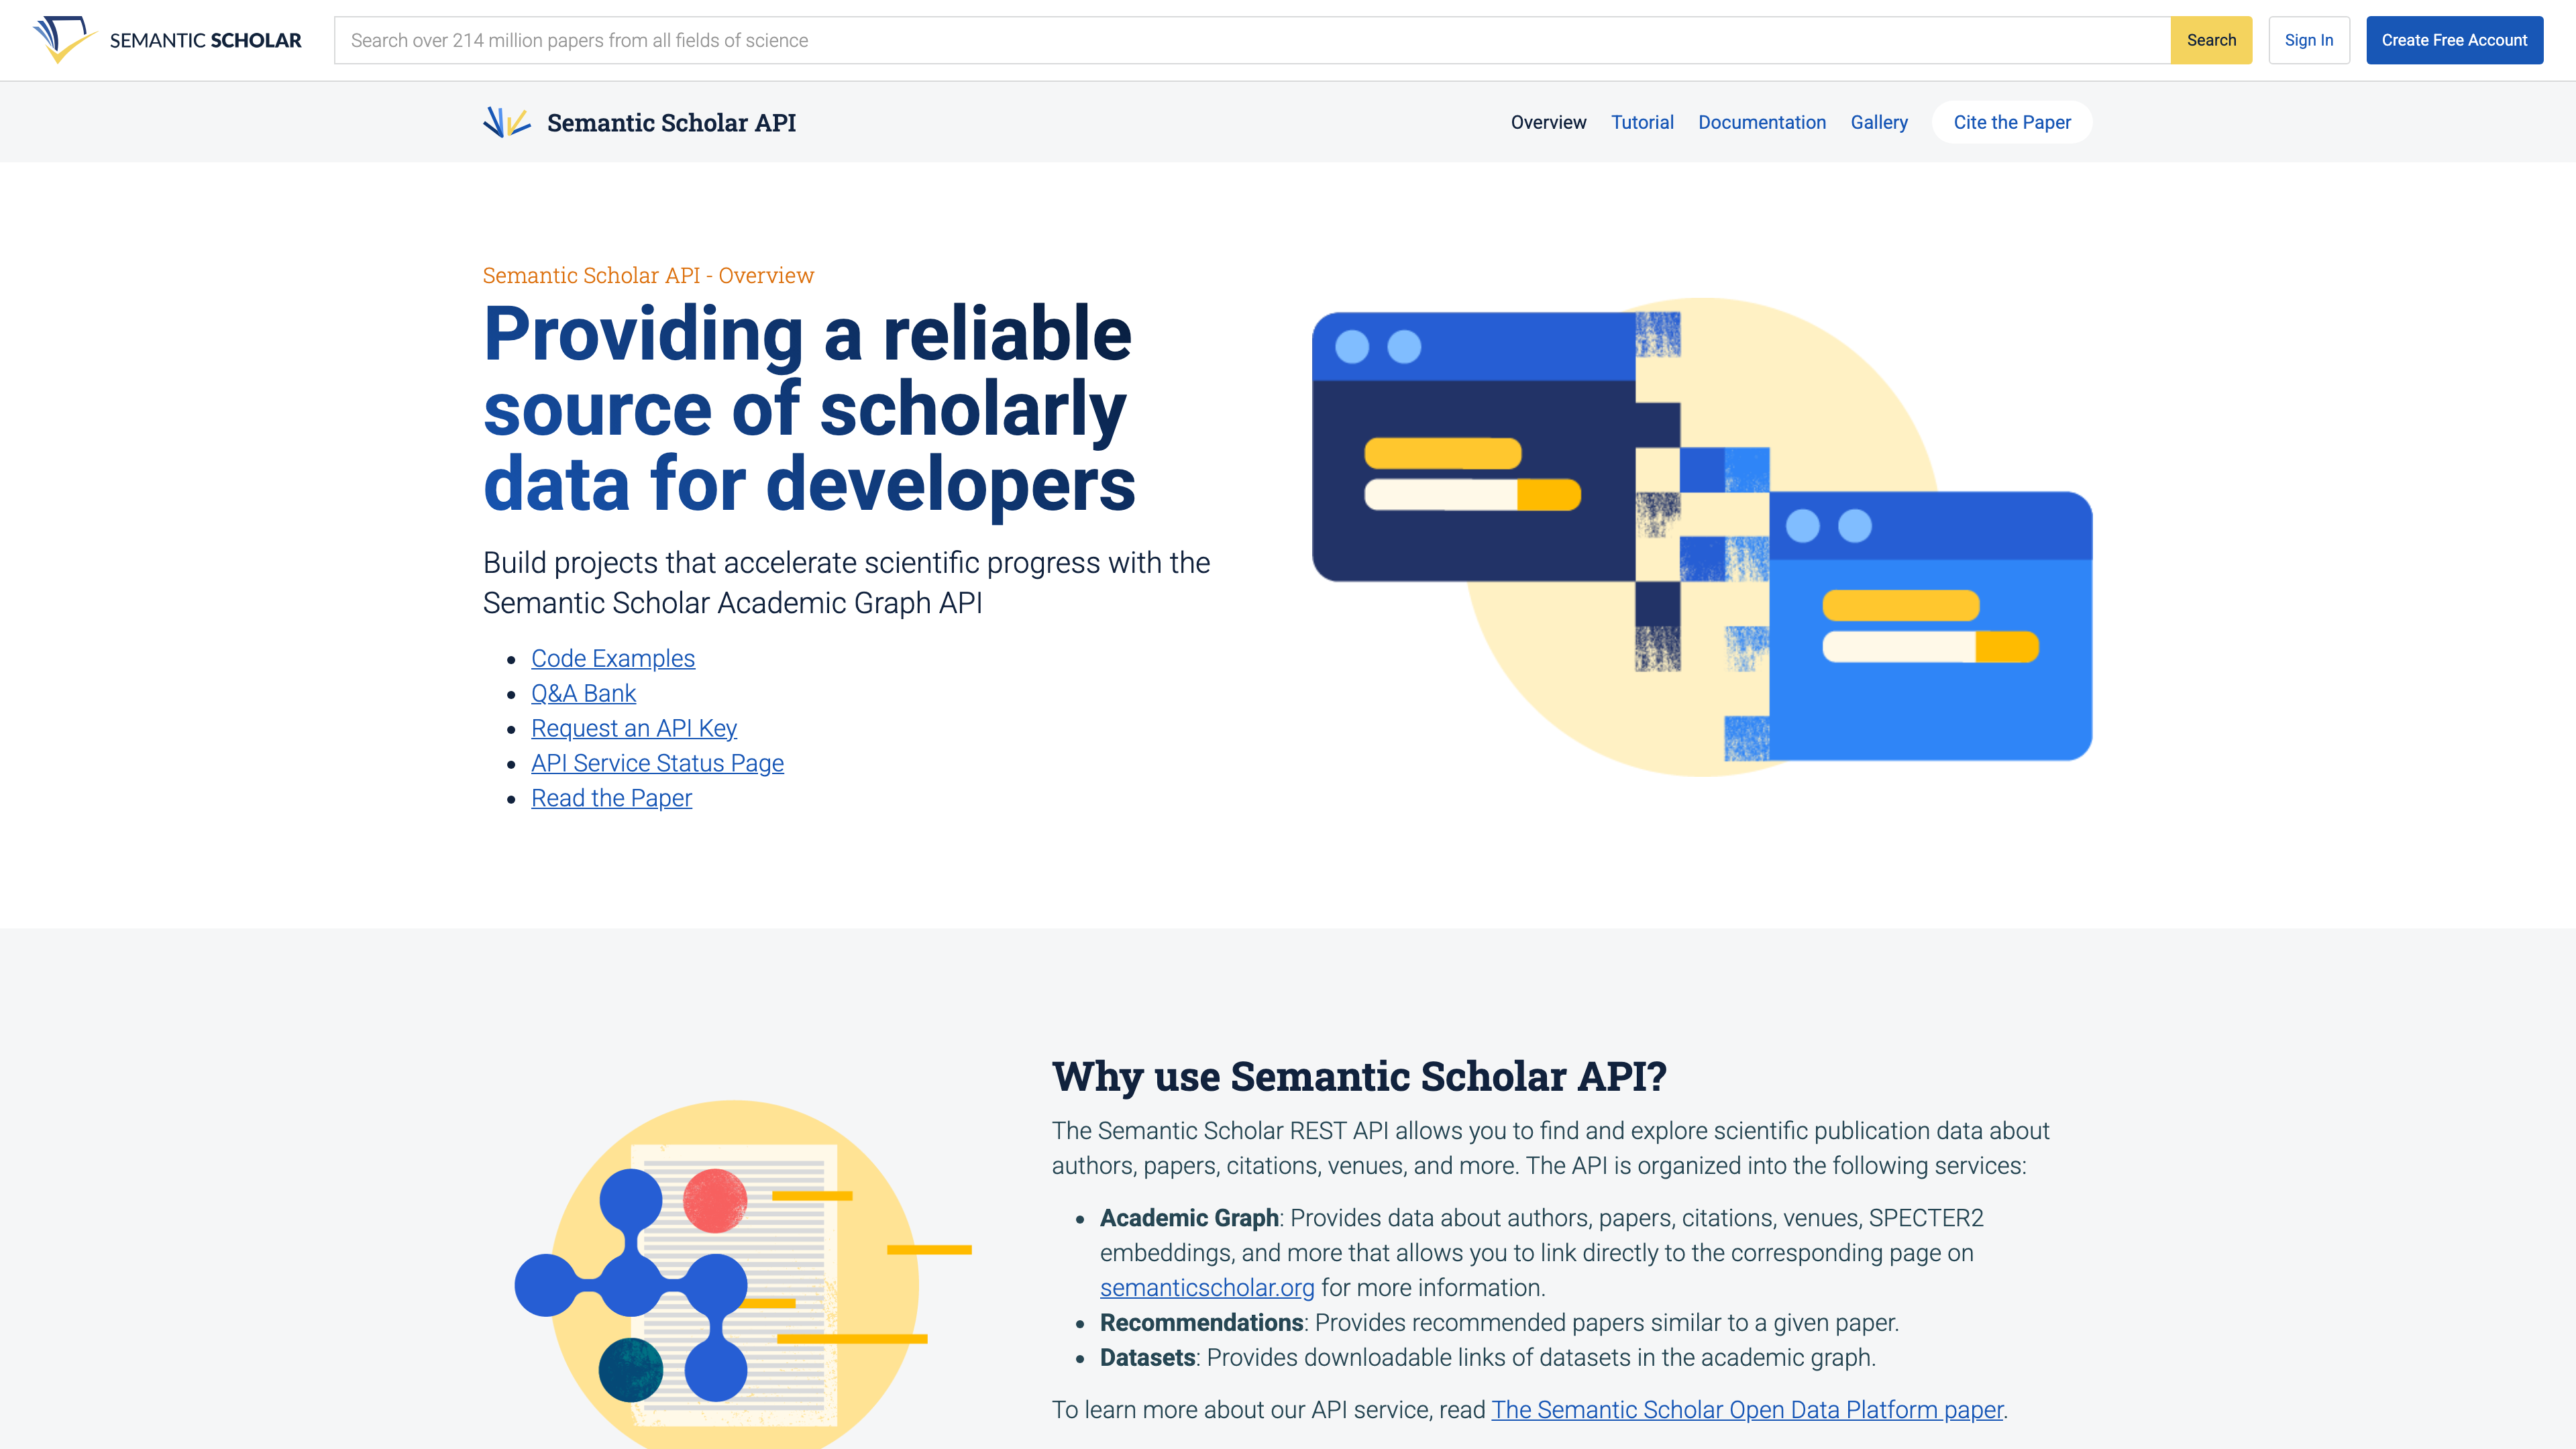
Connected Papers、Litmaps、Sourcely 等第三方文献工具在官方页面上说明其服务建立在该 API 与数据集之上;有开发者在对比中提到,PDF 链接、摘要与自动摘要这类元数据在 Google Scholar 等其他学术引用服务中不易获取(API 概览)。
适用场景
- 快速判断一篇论文是否值得细读:TLDR、引用意图与影响力标注可以在通读摘要前给出线索。
- 追溯方法或结论的传播路径:引用意图分类便于区分"沿用方法"与"扩展结论"的文献。
- 构建文献驱动的应用或研究:免费 API 与可下载数据集覆盖论文、作者、引用与 TLDR 等结构化数据。
- 维护学者个人档案:认领作者页后可修正自动消歧造成的归属错误。
- 通过机构登录直达已订阅的付费全文。
局限
- 学科与语言不均衡:TLDR 仅覆盖计算机科学与生物医学(TLDR 功能页),Topic 页仅覆盖计算机科学,学科分类仅支持英文论文,收录整体以英文文献为主(FAQ)。
- 引文口径差异:书籍覆盖很少、专利不包含,引用数与 h-index 和其他平台可能不一致;官方明确不建议将 h-index 用作比较性的研究评估指标(FAQ)。
- 高影响力引用的识别依赖施引论文全文,全文获取不足时存在漏判(FAQ)。
- 检索能力有限制:不支持布尔运算符与通配符(FAQ)。
- AI 生成内容存在错误风险,官方对生成式 AI 功能给出明确警示,需要用户自行核实(FAQ)。
- 界面只有英文,没有移动应用,仅提供响应式网页与浏览器扩展(FAQ)。
- 付费墙后的全文仍需机构订阅或向出版商购买;Semantic Scholar 只在开放获取版本可用时提供 PDF(FAQ)。
同类参考
- Google Scholar:定位最接近的通用学术搜索;未公开收录规模,也没有对应公开数据接口。
- Scopus / Web of Science:商业引文数据库,需机构订阅,常用于正式的引文统计与评估。
参考资料
- Semantic Scholar 首页(核查日期:2026-08-31)
- About Semantic Scholar(核查日期:2026-08-31)
- Publishers(核查日期:2026-08-31)
- Frequently Asked Questions(核查日期:2026-08-31)
- TLDR 功能页(核查日期:2026-08-31)
- API 概览(核查日期:2026-08-31)
- API License Agreement(核查日期:2026-08-31)
- Academic Graph API 文档(核查日期:2026-08-31)
- S2AG 数据集发布列表(核查日期:2026-08-31)
- allenai/s2search(核查日期:2026-08-31)
- allenai/s2orc(核查日期:2026-08-31)



