Perplexity 是一款把"搜索"和"问答"合在一起的产品:你输入一个问题,它实时检索网页、调用大语言模型,直接生成一段带来源引用的回答,而不是返回十条链接让你自己点。官方把它定位为"答案引擎"(answer engine),口号是 "Where Knowledge Begins",并强调"每个回答都附带来源引用"。它由前 OpenAI 研究员 Aravind Srinivas 等四人于 2022 年创立,是目前 AI 搜索类产品中规模最大、争议也最多的代表之一。收录它的理由很直接:想快速了解一个陌生话题、需要能核对出处的答案时,它是当前最常被提到的选项之一。
站点速览
- 网址:https://www.perplexity.ai/
- 类型:AI 答案引擎 / 对话式搜索
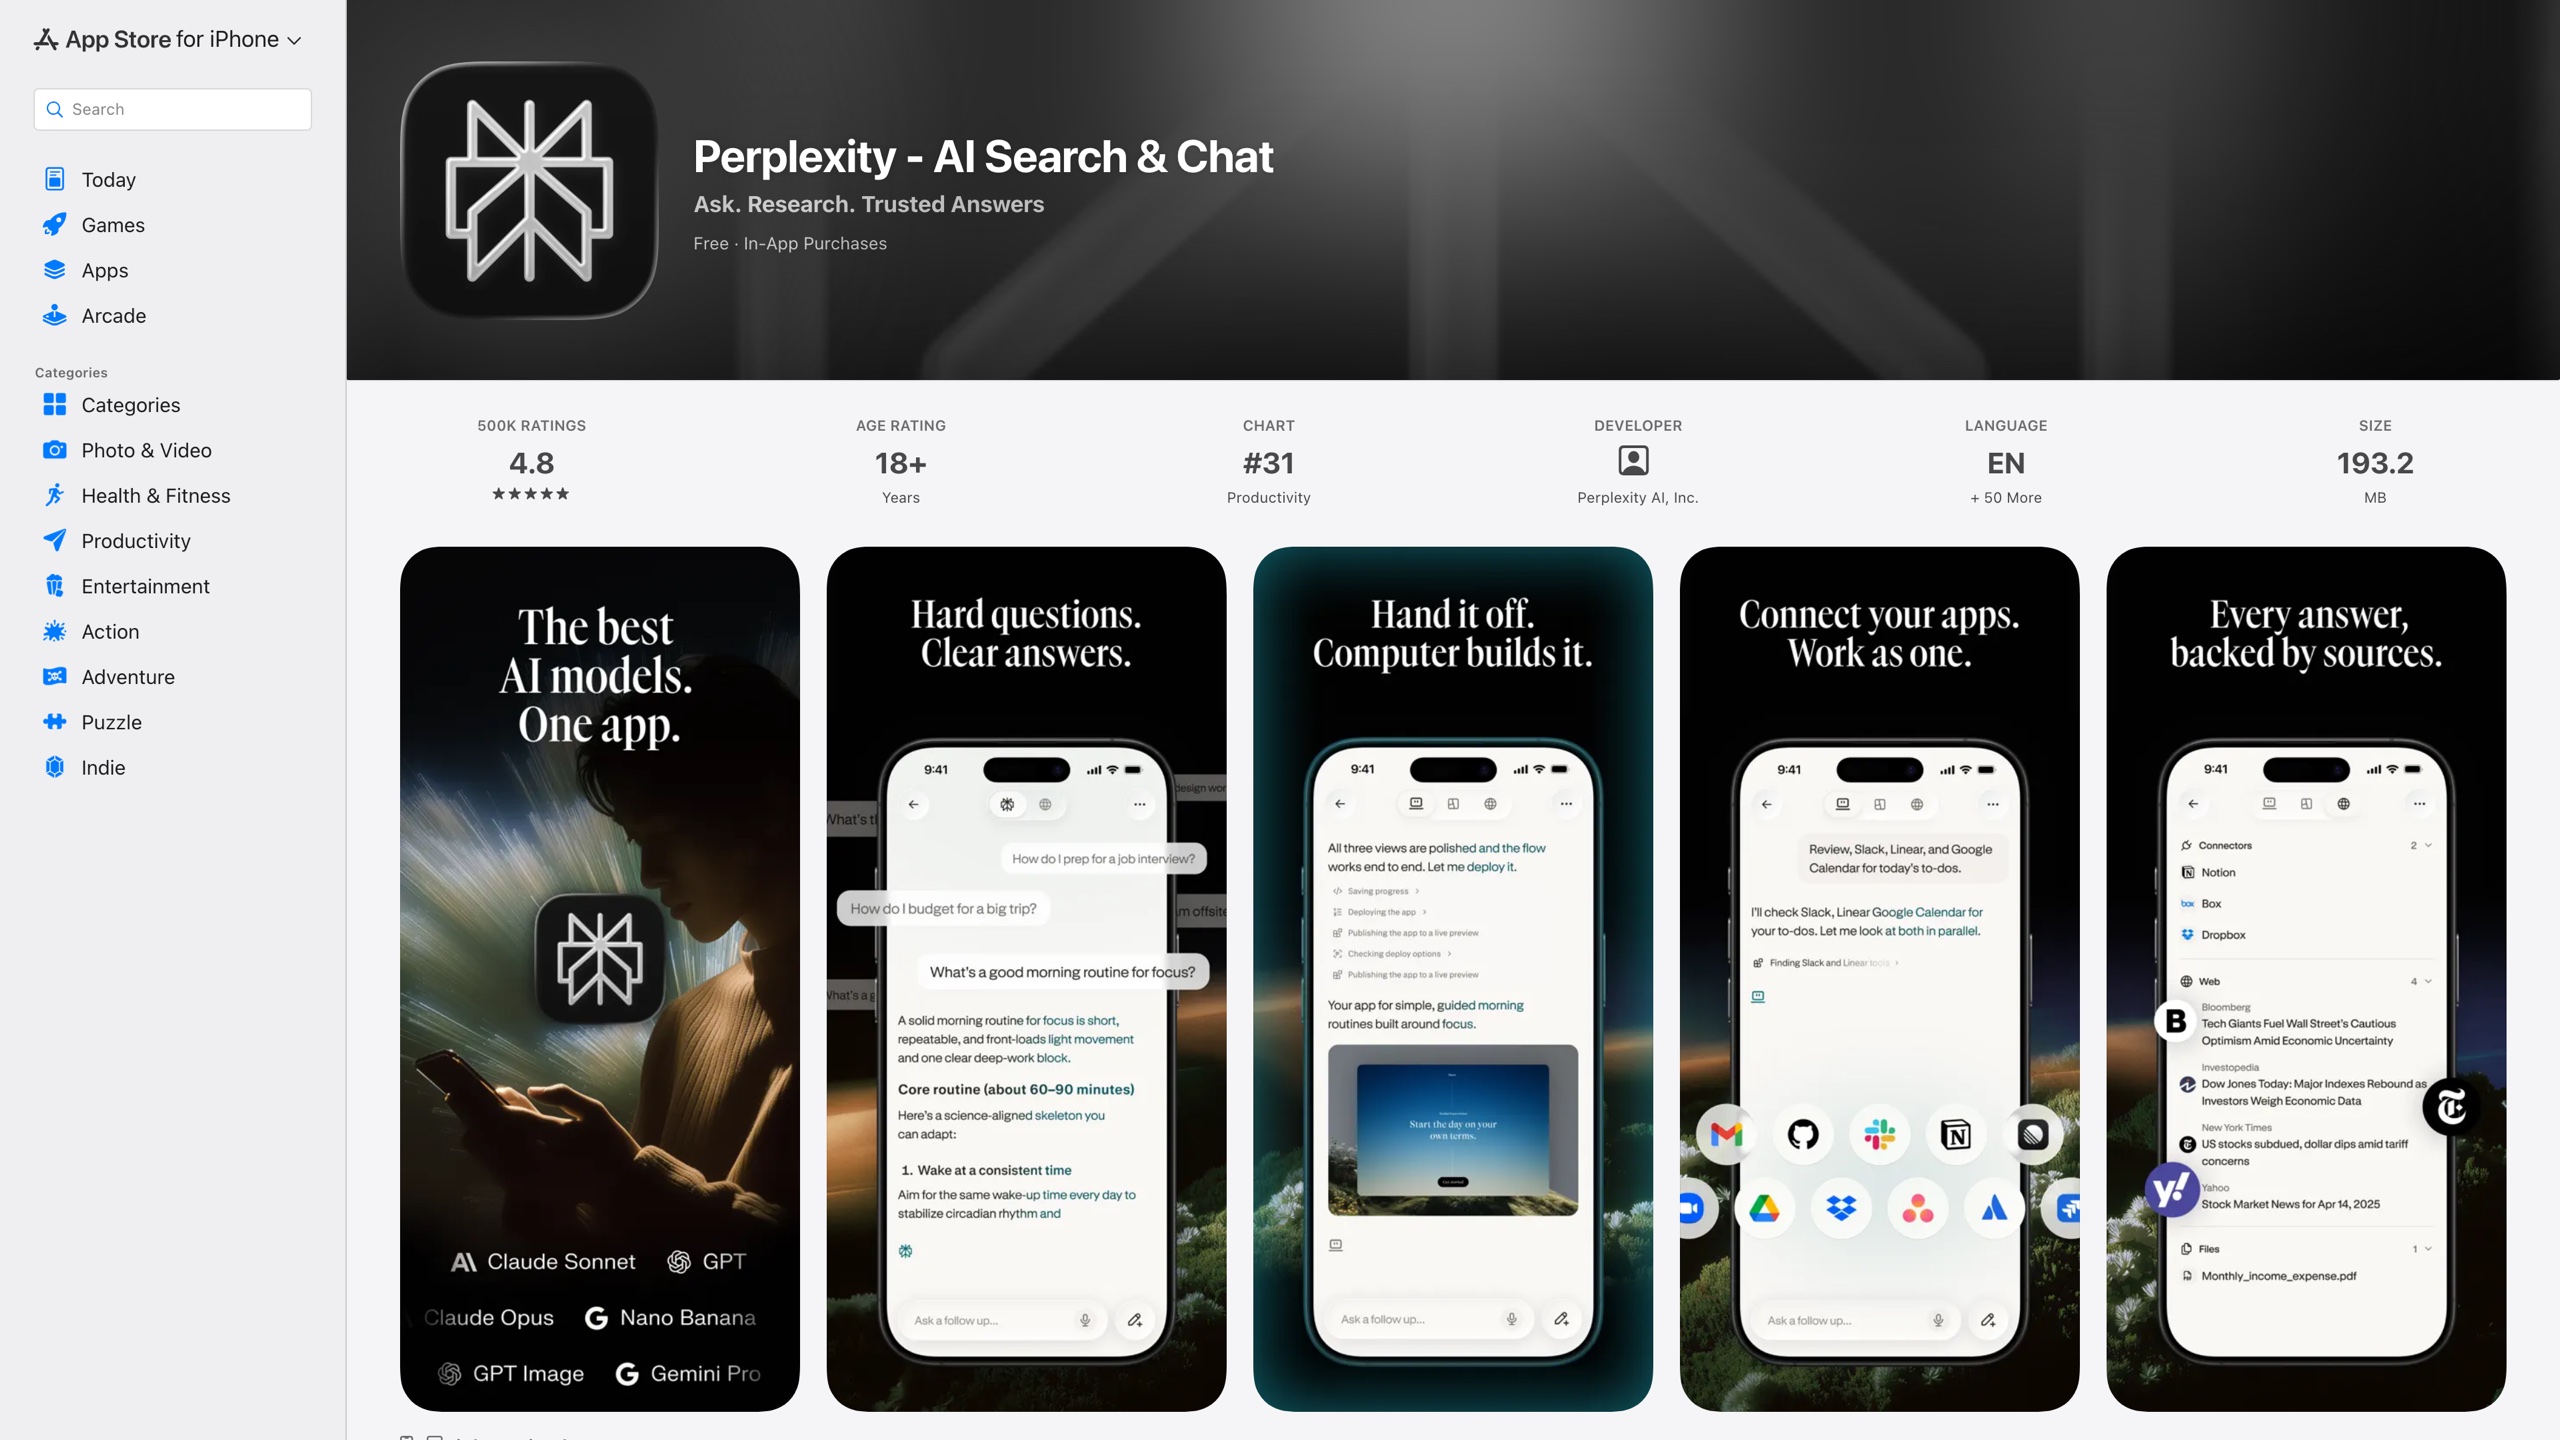
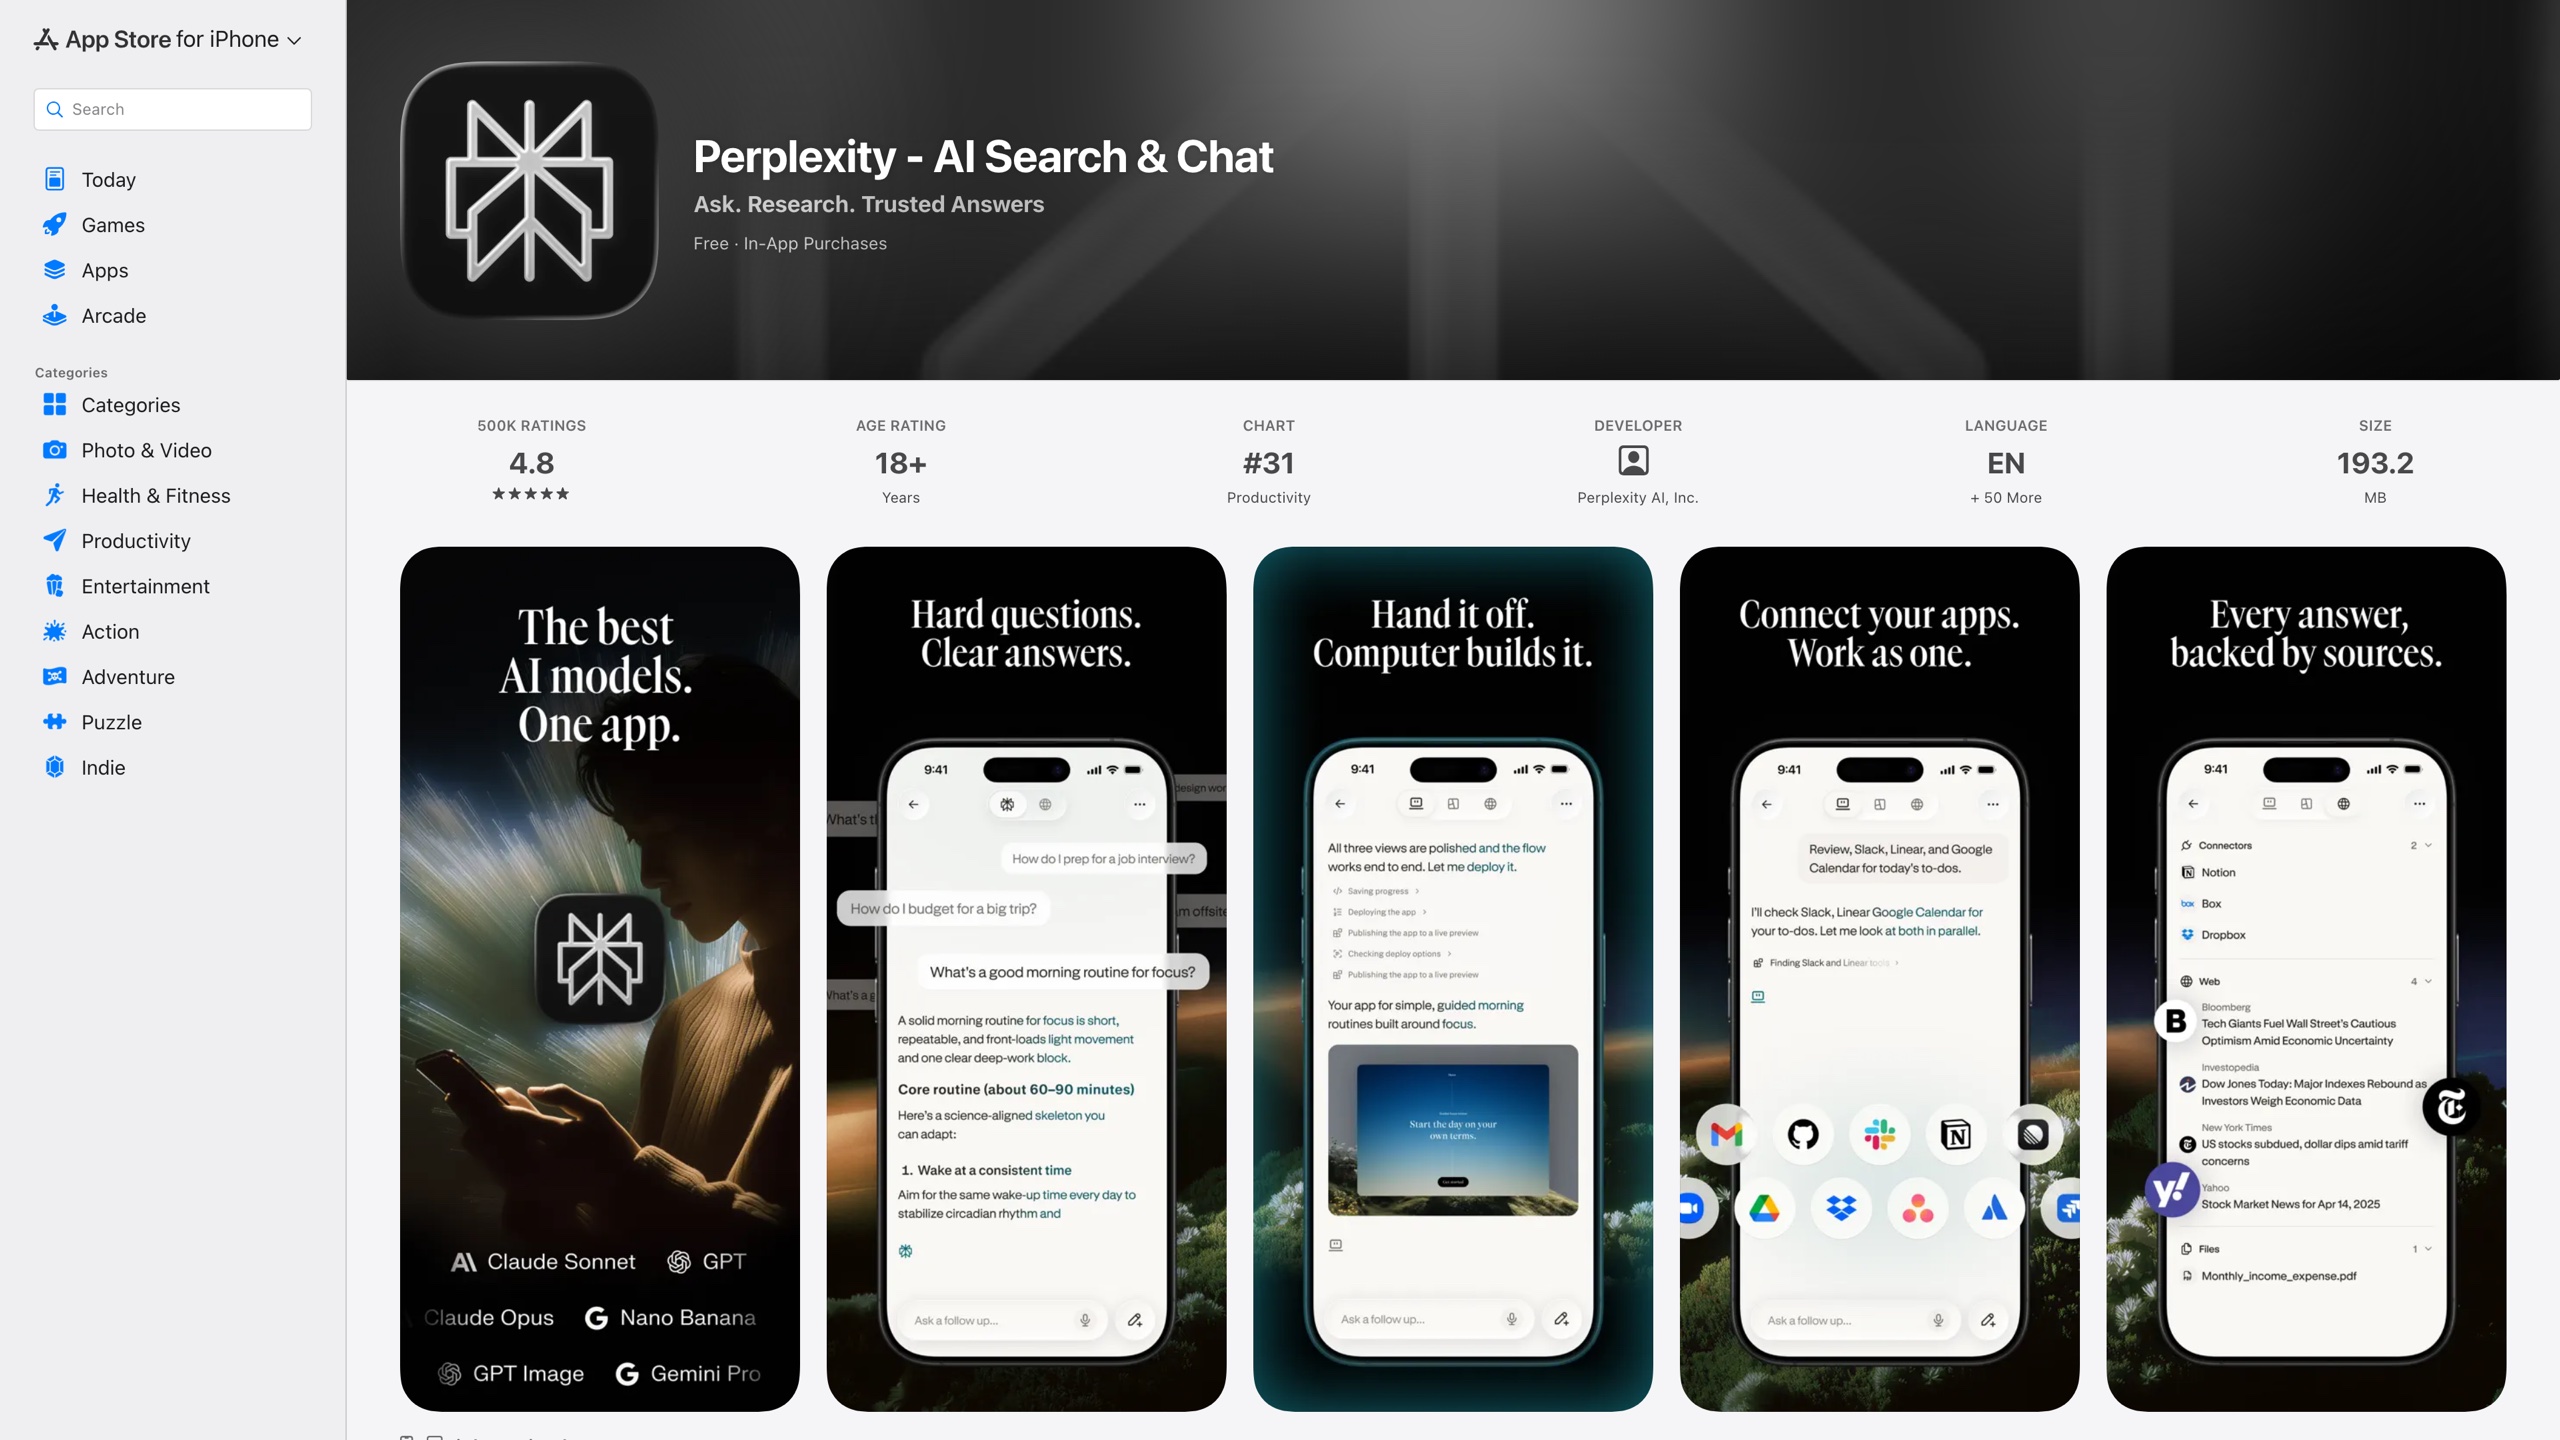
- 费用:基础功能免费;Pro 订阅 20 美元/月或 200 美元/年;Max 订阅 200 美元/月;API 按用量计费(价格截至 2026-08-31,详见下文)
- 注册要求:不注册即可使用基础搜索(据 Bloomberg 报道);注册后才能保存历史、跨设备同步
- 平台:网页版、iOS、Android、Chrome 扩展,另有独立 AI 浏览器 Comet
- 界面语言:iOS 版提供包括简体中文、繁体中文在内的 51 种界面语言(据 App Store 页面,截至 2026-08-31)
站点背景
Perplexity AI, Inc. 于 2022 年 8 月由 Aravind Srinivas、Denis Yarats、Johnny Ho 和 Andy Konwinski 四人创立,总部位于旧金山。创始团队成员曾有 OpenAI、Google DeepMind 等机构的研究背景。其核心产品于 2022 年 12 月 7 日公开发布,随后陆续推出 iOS(2023 年 4 月)和 Android 应用。以上沿革见 Wikipedia 条目及其引用的 TechCrunch、Forbes 报道。
增长方面有两个可参考的数据点:CEO Aravind Srinivas 在 2025 年 6 月的 Bloomberg 科技峰会上称,公司 2025 年 5 月处理了 7.8 亿次查询(公司自述口径,未经独立审计);2025 年 9 月,公司完成估值 200 亿美元的融资(Reuters 报道)。2025 年 7 月,公司还发布了基于 Chromium 的 AI 浏览器 Comet,同年 10 月起免费开放下载。
核心能力:直接给出带引用的答案
Perplexity 的主流程是"提问—检索—生成—引用":问题提交后,系统实时搜索网页,用大语言模型把多个来源整理成一段连贯回答,并在句末标注编号引用,点击可跳转到原始网页。回答之后可以继续追问,对话上下文会保留在同一个 Thread 中。
在此之上,它按能力分了几个层次(功能名称以官方为准):
- Pro Search 与 Deep Research:针对复杂问题的引导式深度检索,Deep Research 会进行多轮搜索后生成更长的研究报告。
- 文件与空间:支持上传 PDF、表格等文件与网页内容一起检索;Spaces / Library 用于组织历史研究。
- 模型选择:付费用户可在 OpenAI、Anthropic、Google 等厂商的模型之间切换,也可使用 Perplexity 自研的 Sonar 系列模型。
- 语音与助手:移动端支持语音提问;Android 版提供能跨应用执行操作的 Assistant。
- Discover:按主题浏览资讯的公共内容流。
需要说明的是,上述功能边界随版本调整频繁,免费账户各能力的具体额度官方并未长期固定,本文不作列举。
订阅档位与开发者 API
截至 2026-08-31,个人用户的价格体系是:基础功能免费;Pro 20 美元/月(年付 200 美元),包含更强的模型选择、更多 Deep Research 额度和文件上传等;Max 200 美元/月,面向高频用户,提供 Labs 不限量、最新模型优先使用权等(Max 档位于 2025 年 7 月推出)。上述价格与 App Store 应用内购买列表一致。此外还有面向团队的 Enterprise 档位。
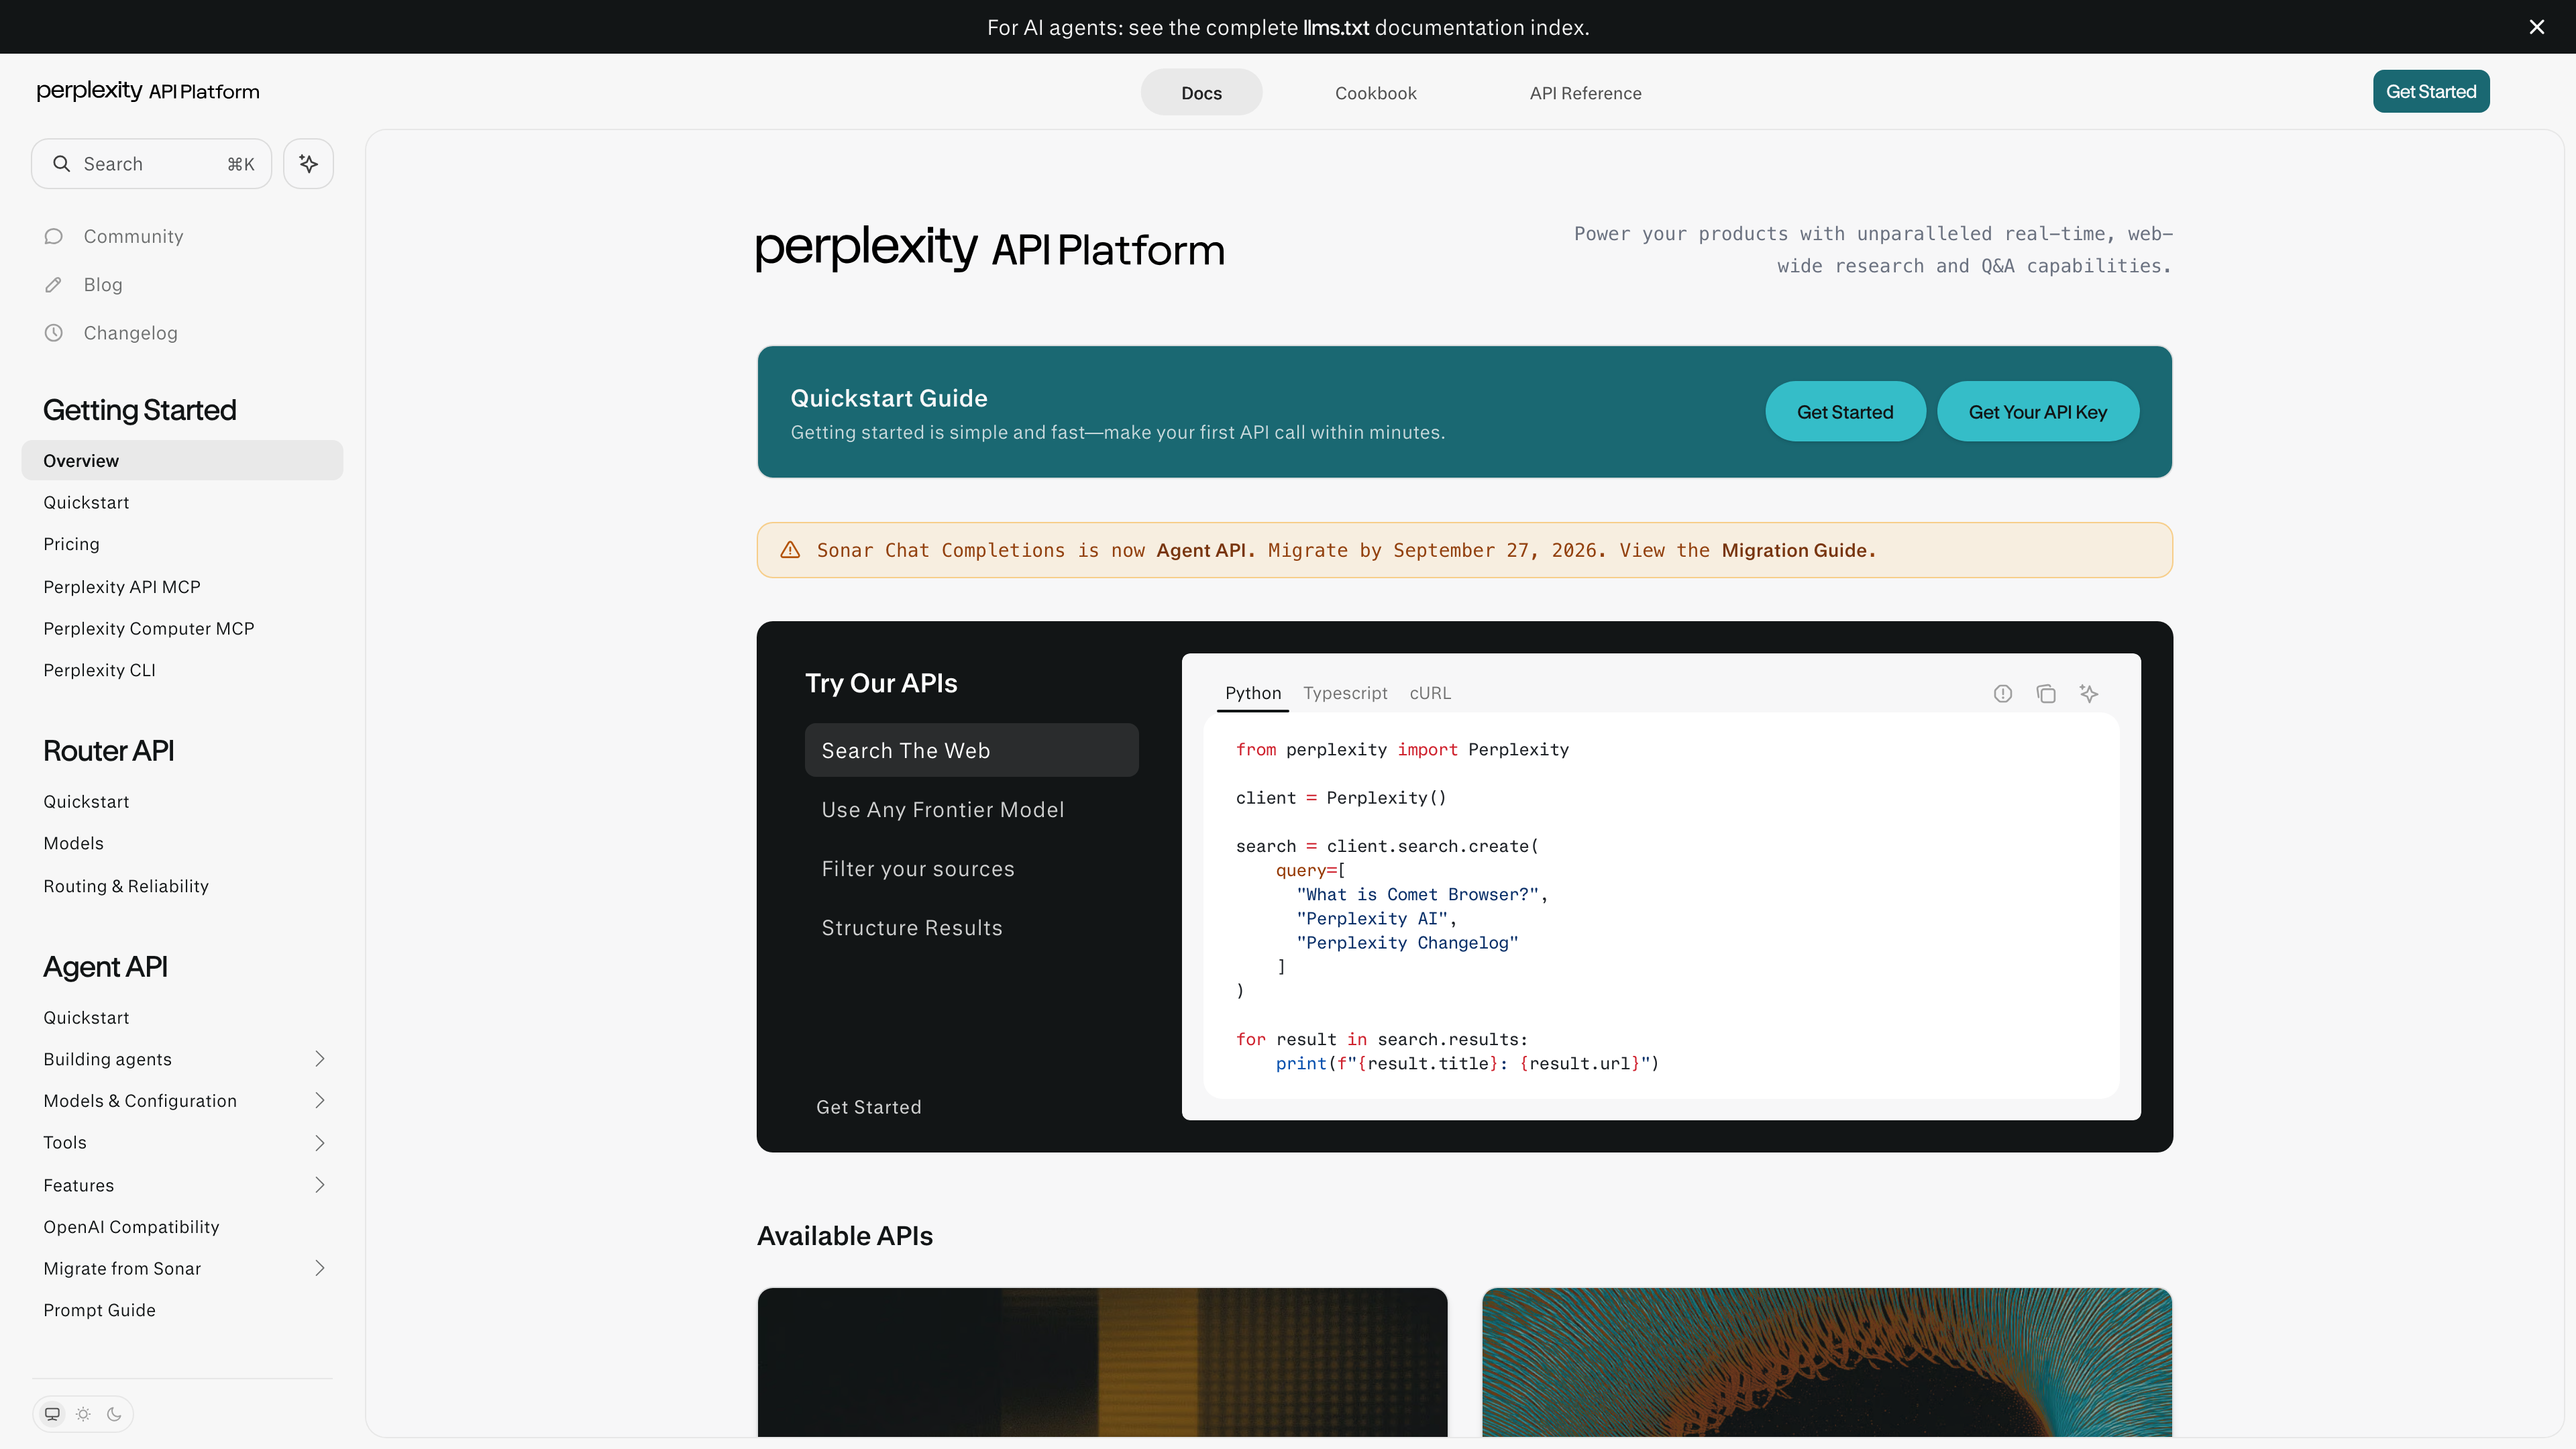
面向开发者,Perplexity 提供独立的 API 平台(docs.perplexity.ai),包括直接返回答案的 Agent API、返回原始搜索结果的 Search API(5 美元/千次请求)、托管开源模型的 Router API 和 Embeddings API;其 Sonar 模型按 token 计费(如 sonar 模型输入 1 美元/百万 token,详见官方定价页)。API 与网页版订阅是两套独立计费体系。
隐私与数据收集
Perplexity 的隐私声明(最近更新于 2026 年 7 月 2 日)列明:注册账户、提交的查询、上传的文档、付费信息都会被收集,此外还有通过 Cookie、设备与服务器日志自动收集的数据。App Store 隐私标签显示,购买记录、位置、标识符、使用数据和诊断信息会关联到用户身份。隐私声明同时说明,企业与 API 产品的数据处理由单独条款覆盖。如果你会把敏感问题或内部文档交给搜索工具,这一点值得留意。
版权争议与爬虫行为
选择使用 Perplexity 之前,有必要知道它是当前与内容出版方冲突最多的 AI 公司之一。据 Wikipedia 条目汇总:2024 年 6 月,Forbes 公开指责其改写付费报道而未充分署名;同月 Wired 的调查称其使用未公开的 IP 和伪装的 User-Agent 抓取声明禁止抓取的网站;此后《纽约时报》发出停止侵权通知,道琼斯与《纽约邮报》提起诉讼,BBC、读卖新闻、朝日新闻、日经新闻和 Reddit 也先后在 2025 年采取法律行动。
2025 年 8 月,Cloudflare 发布调查报告,称在屏蔽其公开声明的爬虫后,观察到 Perplexity 改用伪装成普通浏览器的未声明爬虫继续抓取,并据此将其移出"已验证机器人"名单;Perplexity 否认了这些指控。作为回应争议的一部分,公司于 2024 年 7 月推出出版商分成计划,与 Time、Fortune、Der Spiegel 等媒体分享广告收入。这些争议不影响你作为普通用户使用产品,但关系到其内容来源的长期可持续性。
适用场景
- 快速建立对陌生话题的整体认知:它会直接给出结构化概述和出处,省去逐条点开搜索结果的时间。
- 需要核对来源的事实性查询:每个论断附引用,方便回溯原文验证——这一点比纯聊天机器人更适合研究型问题。
- 时效性强的问题:它实时检索网页,比分训练截止日期的离线模型更适合查新闻、价格、赛程等信息。
- 多语言提问:界面覆盖包括中文在内的数十种语言,适合跨语言检索。
局限
- 答案仍可能出错。引用存在不等于结论正确,它可能误读来源、过度概括或引用不相关的网页;关键信息应点开引用原文核实。
- 免费版的边界不清晰且经常调整。Pro Search、Deep Research、文件上传、模型选择等能力都向付费档倾斜,免费额度以官方当时说明为准。
- 深度依赖付费墙内容时能力受限:它无法绕过各网站的付费墙,答案质量受公开可抓取内容的限制。
- 隐私代价:查询内容会被收集并可能用于改进服务,不适合输入敏感或机密信息。
- 版权争议未决:多起诉讼和爬虫争议仍在进行中,其内容获取方式未来可能被迫调整。
- 中文支持以界面语言为主:界面提供简/繁中文,但中文回答质量和中文来源覆盖深度未经验证,不应默认等同于英文体验。
同类参考
- ChatGPT / Gemini:通用聊天机器人,同样提供联网搜索,但产品重心在对话与生成而非检索引用。
- Google AI Mode:搜索引擎原生的 AI 答案,覆盖面和来源生态更完整。
- Kagi:付费无广告搜索引擎,AI 摘要只是附加能力,定位更接近传统搜索。
参考资料
- Perplexity - App Store(功能描述、订阅价格、界面语言、隐私标签,核查于 2026-08-31)
- Perplexity AI - Wikipedia(公司沿革、融资、争议事件汇总,核查于 2026-08-31)
- Perplexity API Platform 文档 与 API 定价(核查于 2026-08-31)
- Perplexity 隐私声明(2026-07-02 版,核查于 2026-08-31)
- Cloudflare:Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives(2025-08-04)
- Wired:Perplexity Is a Bullshit Machine(2024-06)
- The Verge:Perplexity 出版商分成计划(2024-07-30)



