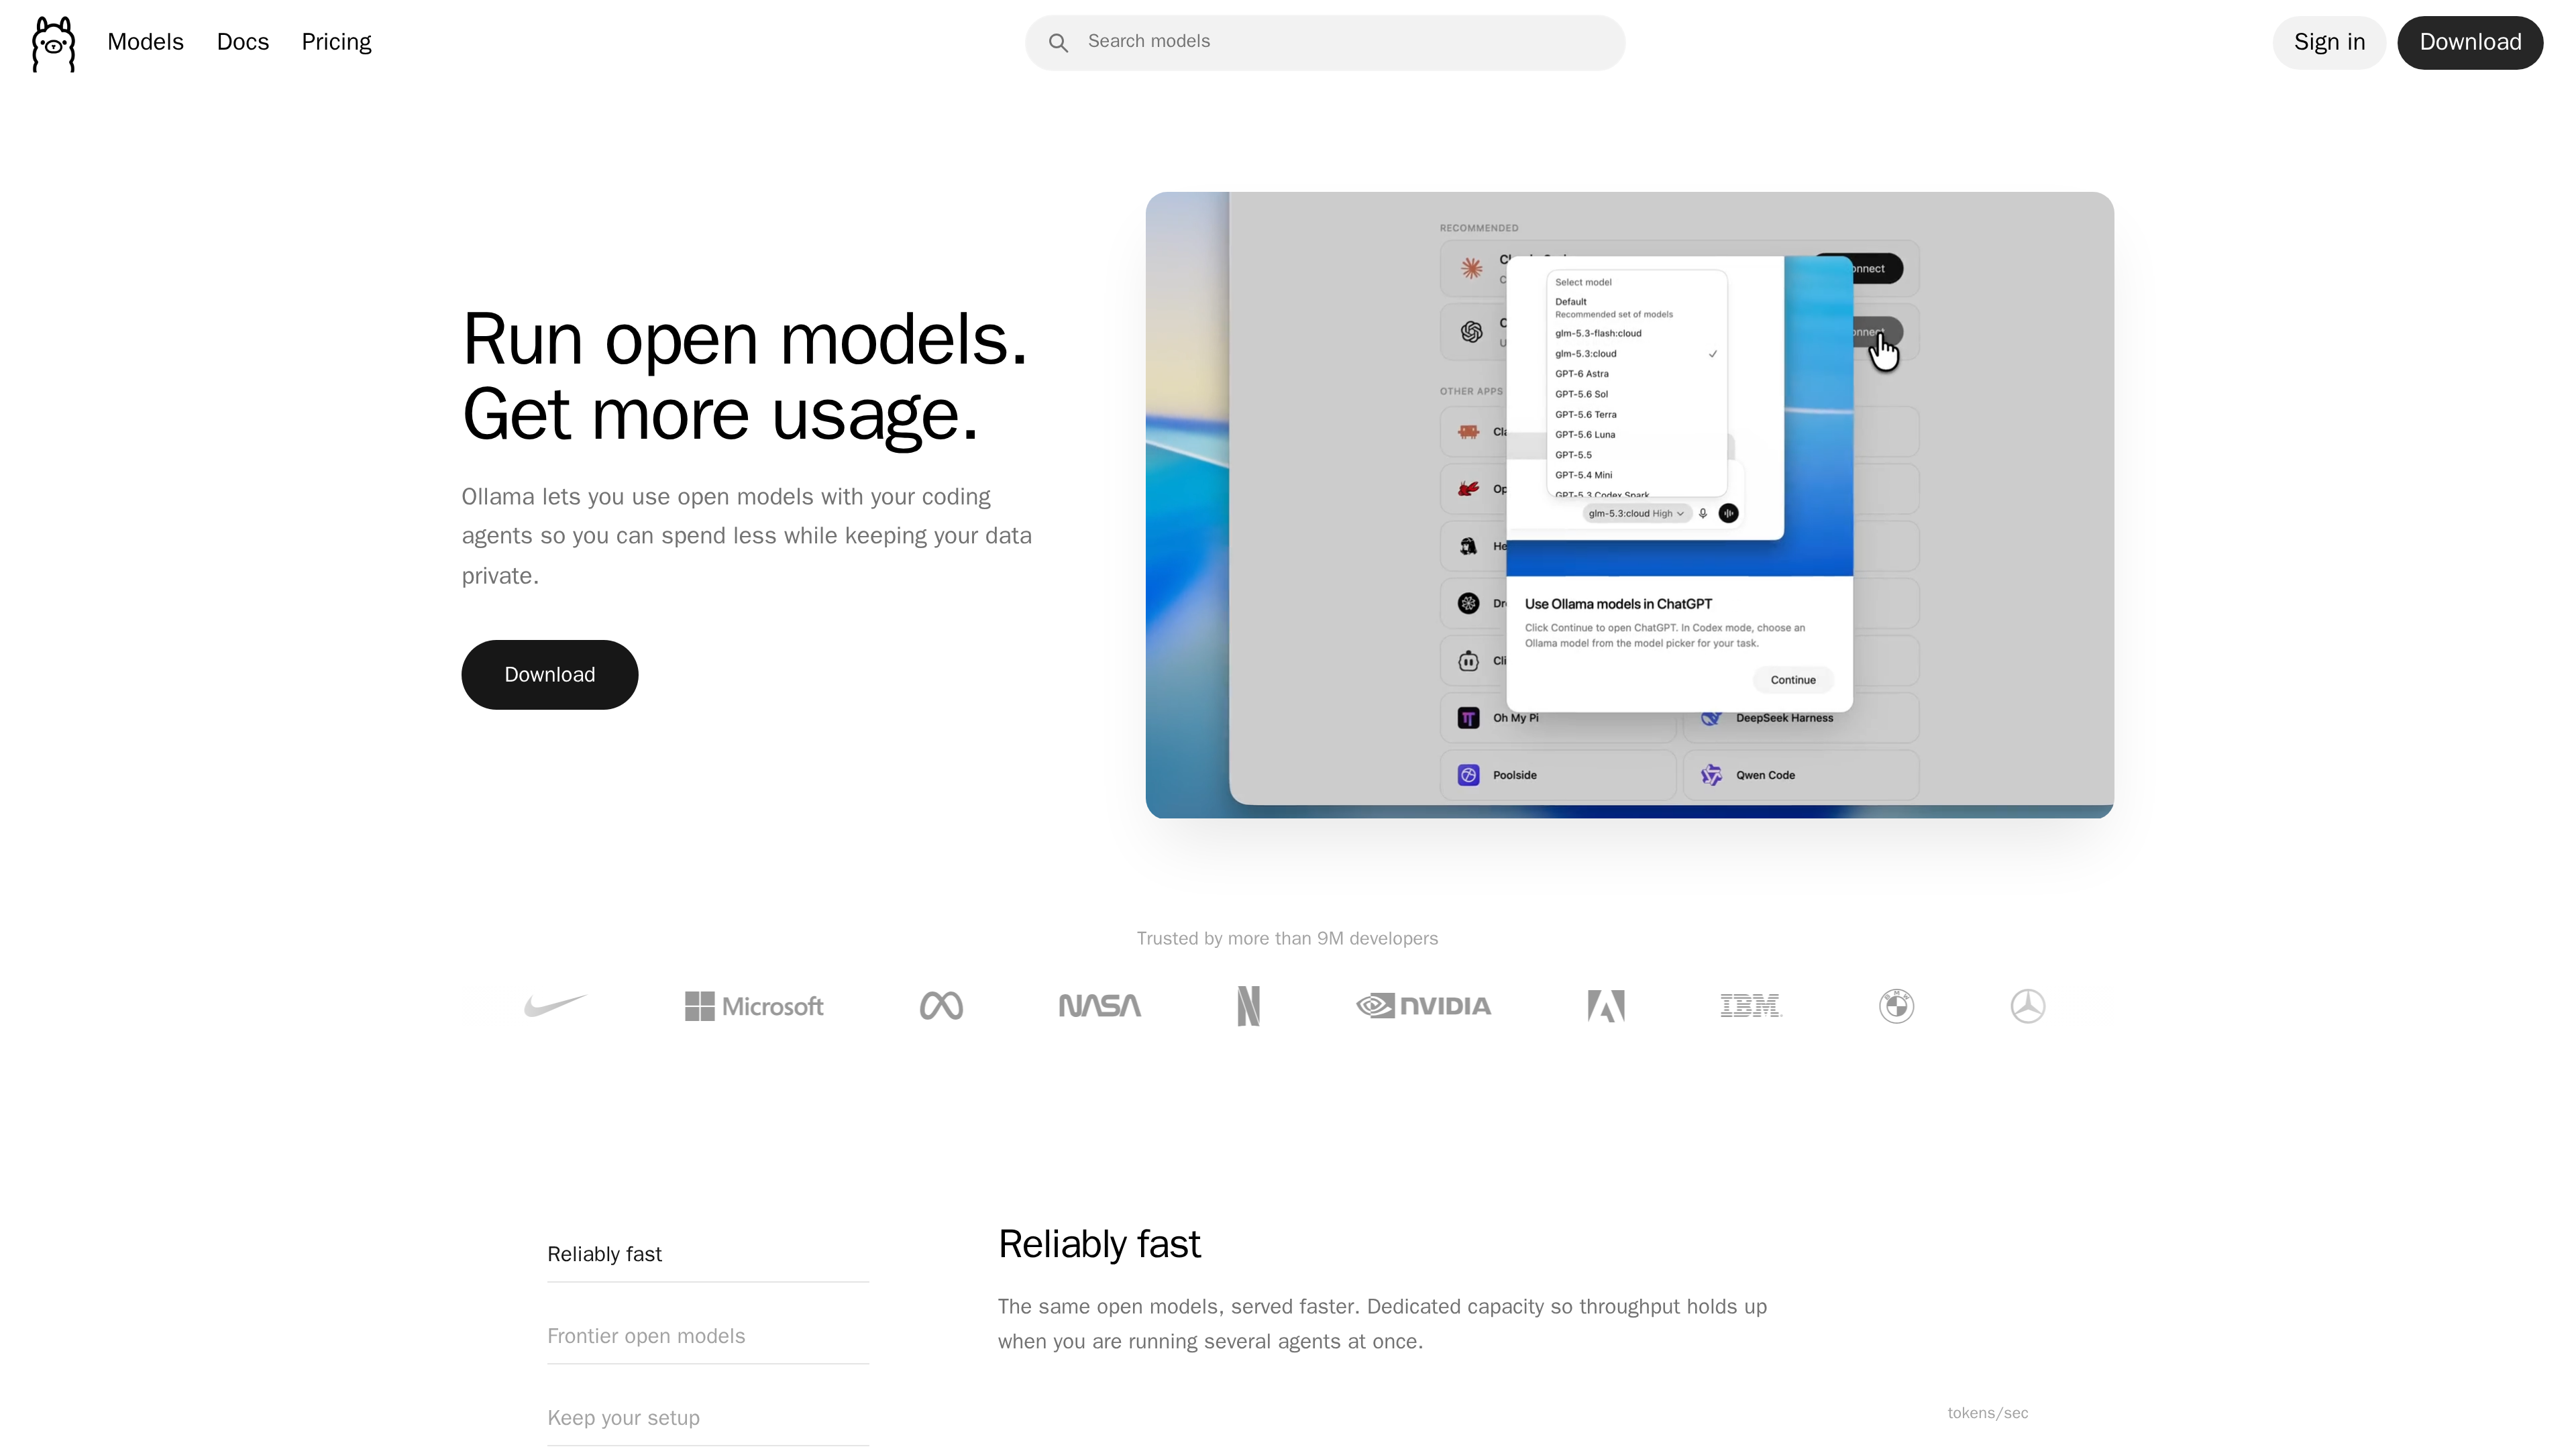
Ollama 是一款用于在个人电脑或服务器上下载并运行开源大语言模型的工具。它把模型获取、量化推理和 API 服务封装成一条命令(如 ollama run qwen3.6),让 Qwen、DeepSeek、GLM、Gemma、Kimi 等开放权重模型可以像安装普通软件一样在本机跑起来,并通过本地端口对任何应用提供 OpenAI 兼容接口。本机运行完全免费且无需注册;官方同时运营按 token 计费的云端模型服务,账号和云端功能均为可选。项目代码以 MIT 协议开源,截至 2026-10-02 在 GitHub 上获得约 18.2 万 stars,是目前本地大模型工具中使用最广的项目之一。
站点速览
- 网址:https://ollama.com
- 类型:本地大模型运行工具 / 开源开发者工具(MIT 协议)
- 费用:本地运行免费不限量;云端模型按 token 计费,含 Free/Pro/Max/Team/Enterprise 档
- 注册要求:本地使用无需注册;仅云端模型需要账号与 API Key
- 界面形态:官方桌面应用(macOS/Windows)+ 命令行 + 本地 REST API;网站与文档为英文
- 平台:macOS 14+、Windows 10 22H2+、Linux、Docker
站点背景
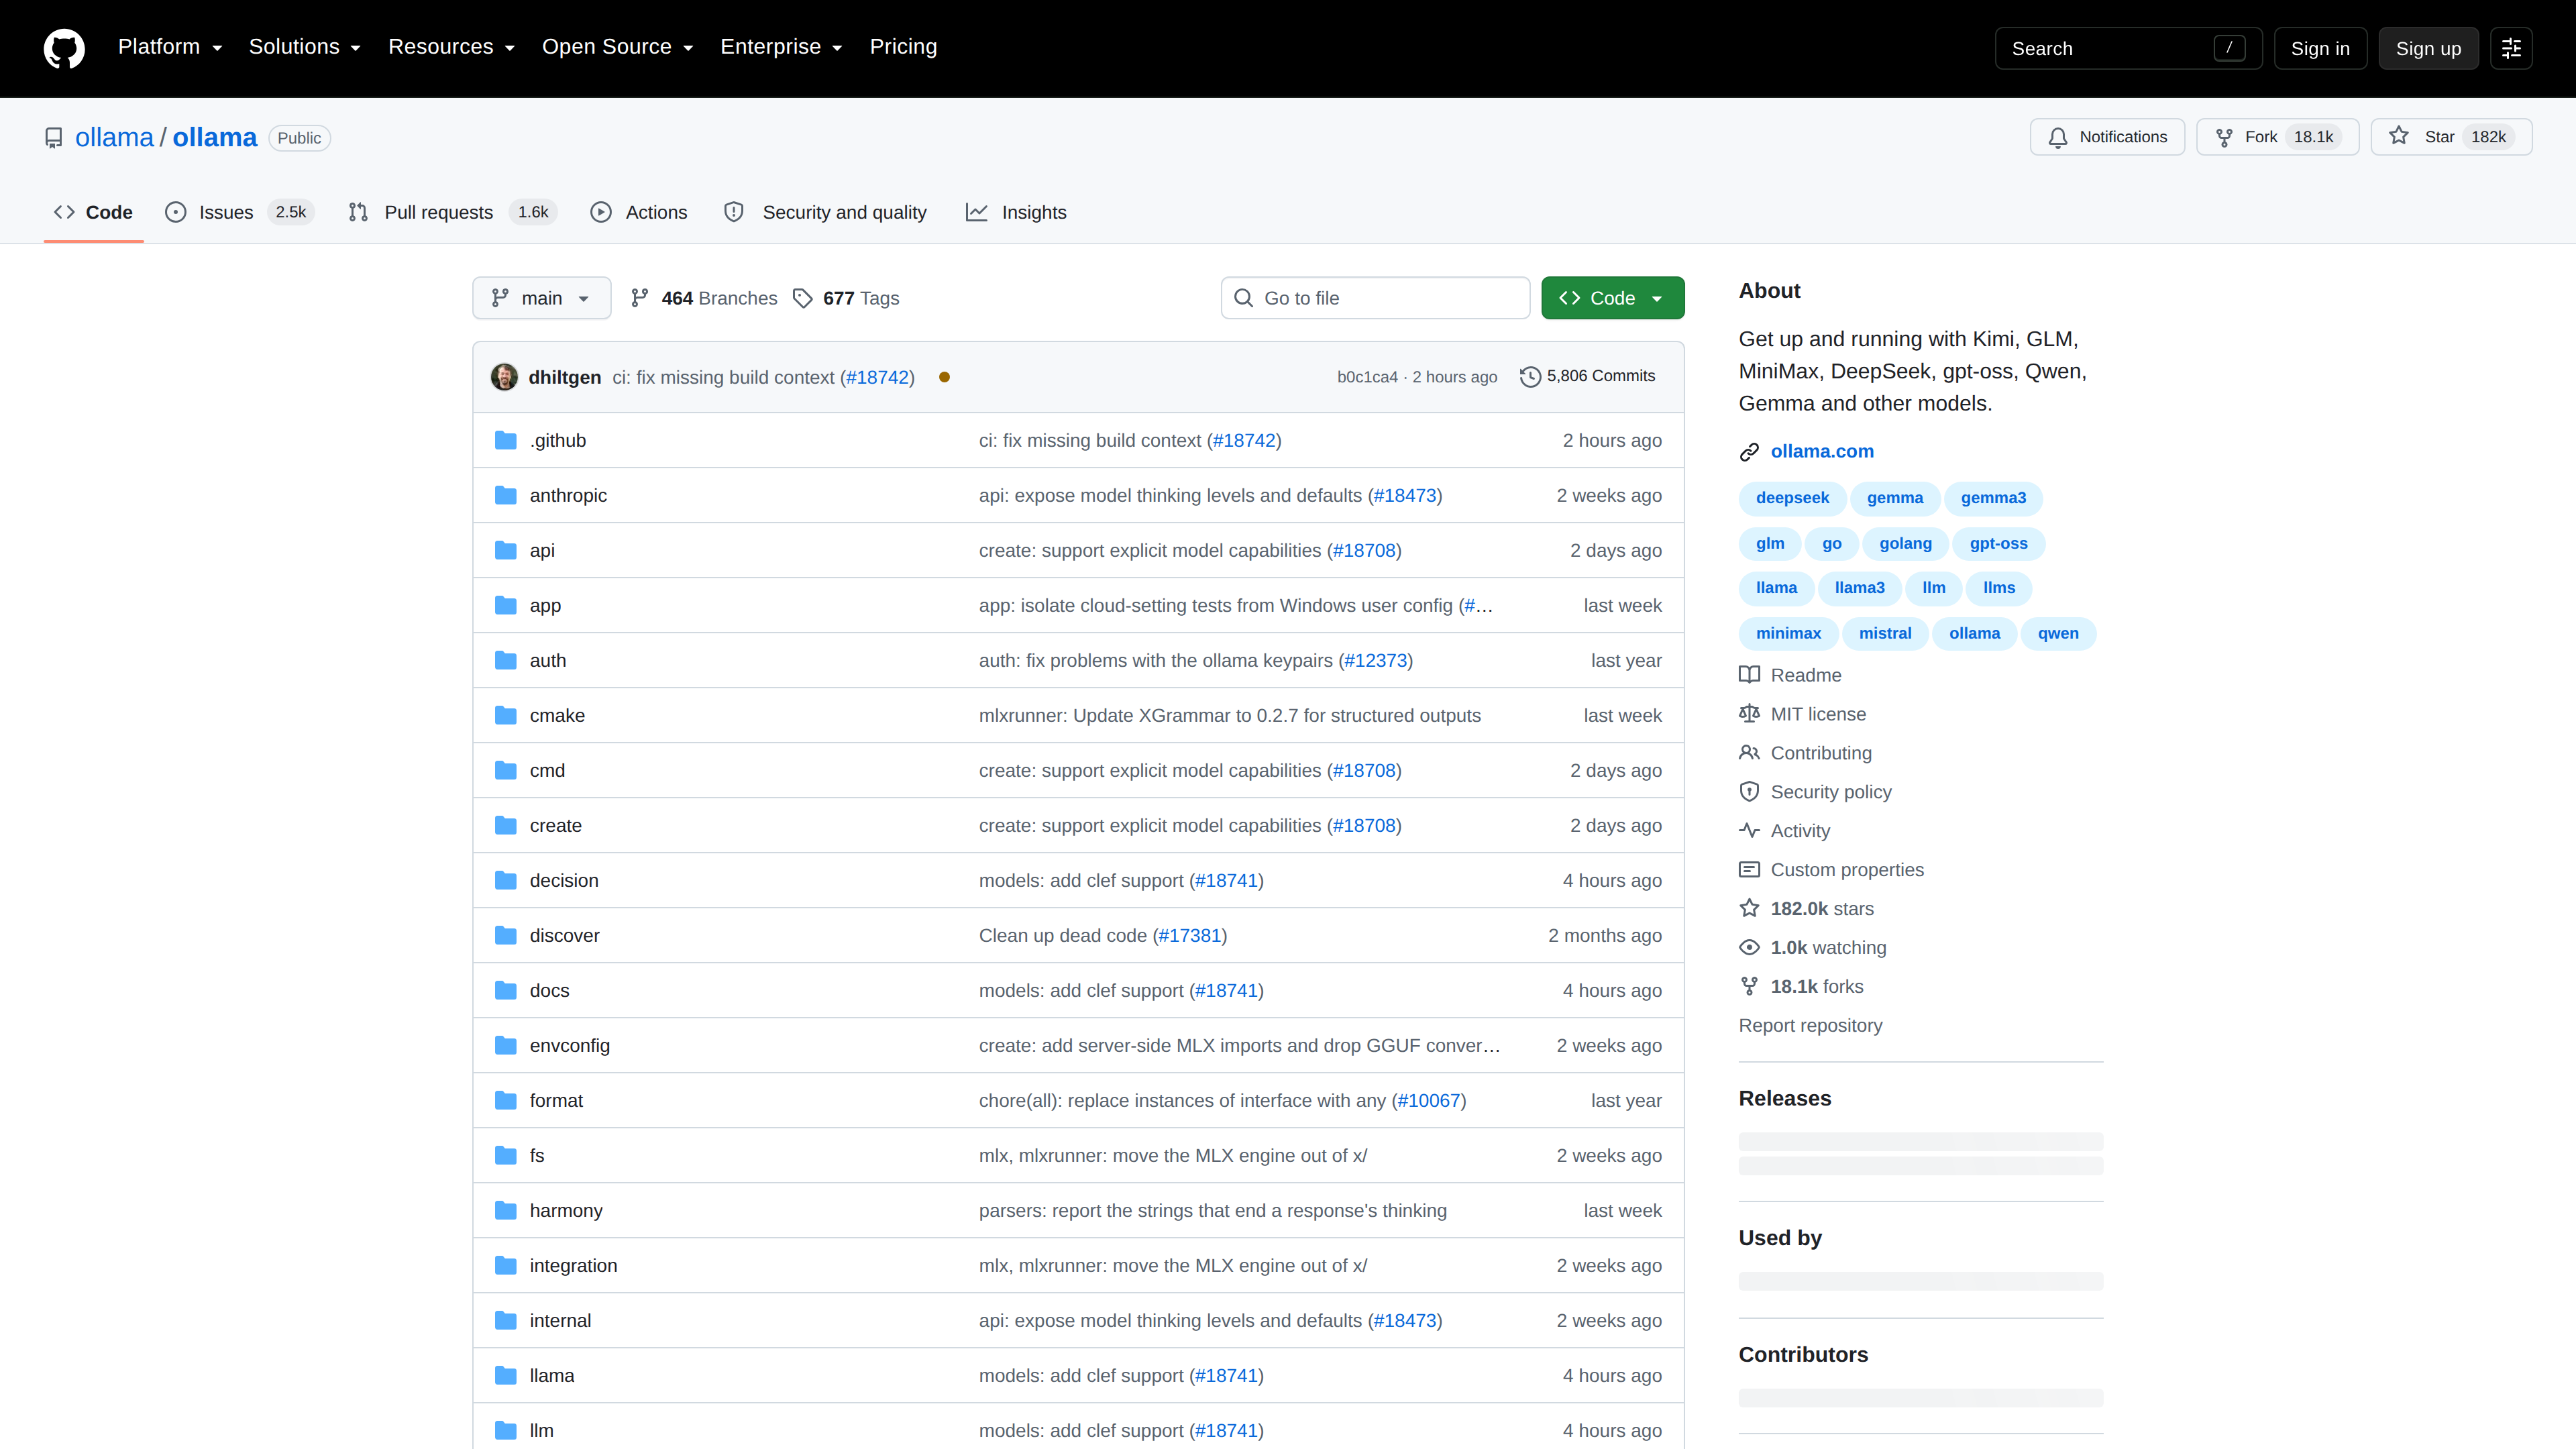
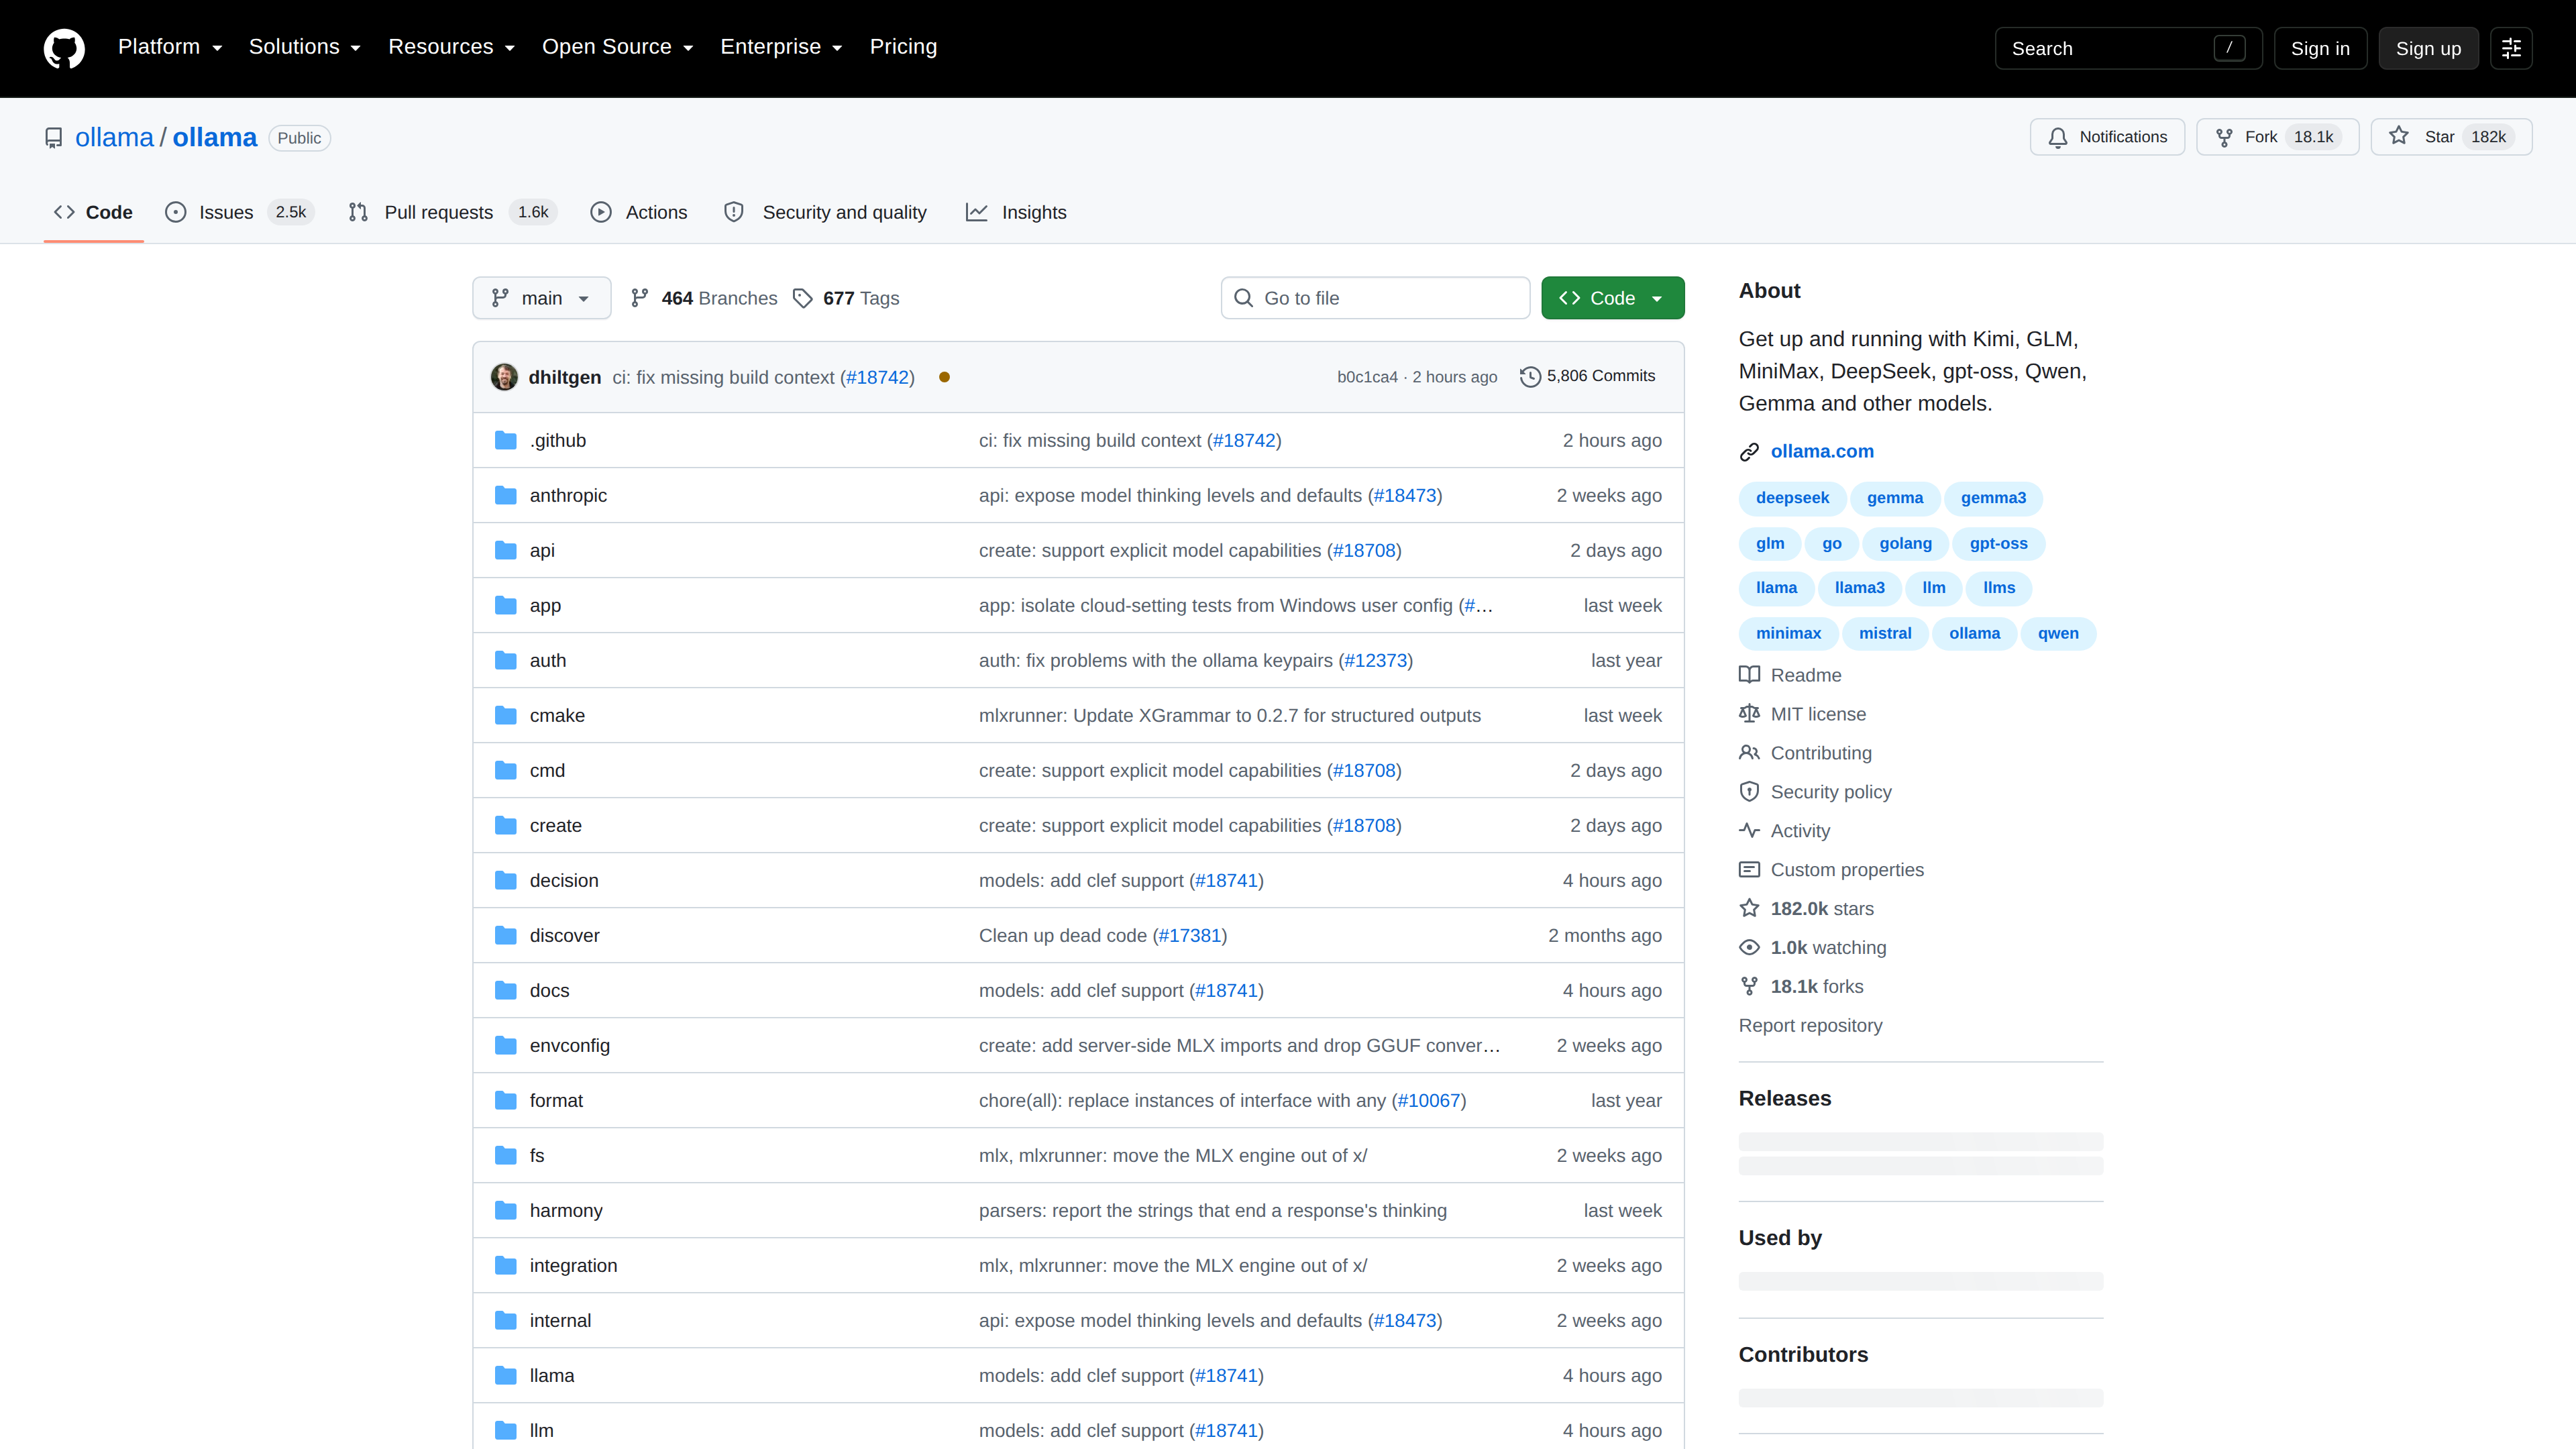
Ollama 的 GitHub 仓库创建于 2023 年 6 月,由 Ollama Inc. 维护,以 MIT 协议开源。截至 2026-10-02,仓库约 18.2 万 stars、1.8 万 forks,最新版本为 2026-09-28 发布的 v0.35.0,当日仍有提交记录,处于活跃维护状态。
根据官方博客 2026 年 7 月的公告,Ollama 当时服务约 890 万开发者,并完成 8,800 万美元融资,投资方包括 Benchmark、Theory Ventures、8VC、Y Combinator 等。其推理后端早期基于 llama.cpp,2026 年中起在 Apple Silicon 设备上增加了 MLX 引擎,官方称在编码代理场景下配合多 token 预测可将 Gemma 4 的速度提升最高约 90%(官方博客,2026-06)。
核心能力
一条命令运行模型。安装后执行 ollama run <模型名> 即可自动拉取并进入对话;ollama pull、ollama ps、ollama rm 分别负责下载、查看载入状态(含 GPU/CPU 占比)和删除模型。
本地 OpenAI 兼容 API。Ollama 在 http://localhost:11434 提供 REST API,并实现了 OpenAI 的 Chat Completions 与 Responses 接口以及 Anthropic Messages 兼容层,现有的 OpenAI SDK 应用只需改 base_url 即可切换到本地模型;官方另提供 Python(ollama)和 JavaScript(ollama)SDK。
Modelfile 自定义。通过 Modelfile 可以基于已有模型定义系统提示词、采样参数、对话模板等,再用 ollama create 构建为自己的模型版本,也可以导入 GGUF 等格式的权重。
对接编码代理与桌面应用。ollama launch claude、ollama launch codex、ollama launch opencode 等命令可把 Claude Code、Codex CLI、OpenCode、OpenClaw 等编码代理直接接到 Ollama 模型上;macOS/Windows 桌面应用内可将 Claude Desktop、ChatGPT Desktop(Codex 模式)配置为使用 Ollama 模型。README 中维护了庞大的社区集成列表,涵盖 Open WebUI、Continue、LangChain、LlamaIndex、Dify 等常见框架与界面。
安装与平台要求
- macOS:需 macOS Sonoma(14)或更新;Apple M 系列芯片支持 CPU+GPU 加速,Intel 机型仅支持 CPU 推理。
- Windows:需 Windows 10 22H2 或更新(Home/Pro);NVIDIA 显卡需 551.61 或更新驱动;可通过
irm https://ollama.com/install.ps1 | iex或安装包安装。 - Linux:执行
curl -fsSL https://ollama.com/install.sh | sh,以 systemd 服务运行,无官方图形界面。 - Docker:官方镜像
ollama/ollama发布于 Docker Hub。
需要注意模型文件的磁盘占用:官方文档提示模型体积可达数十至数百 GB,家目录空间不足时需要调整存储位置。
模型生态与云端服务
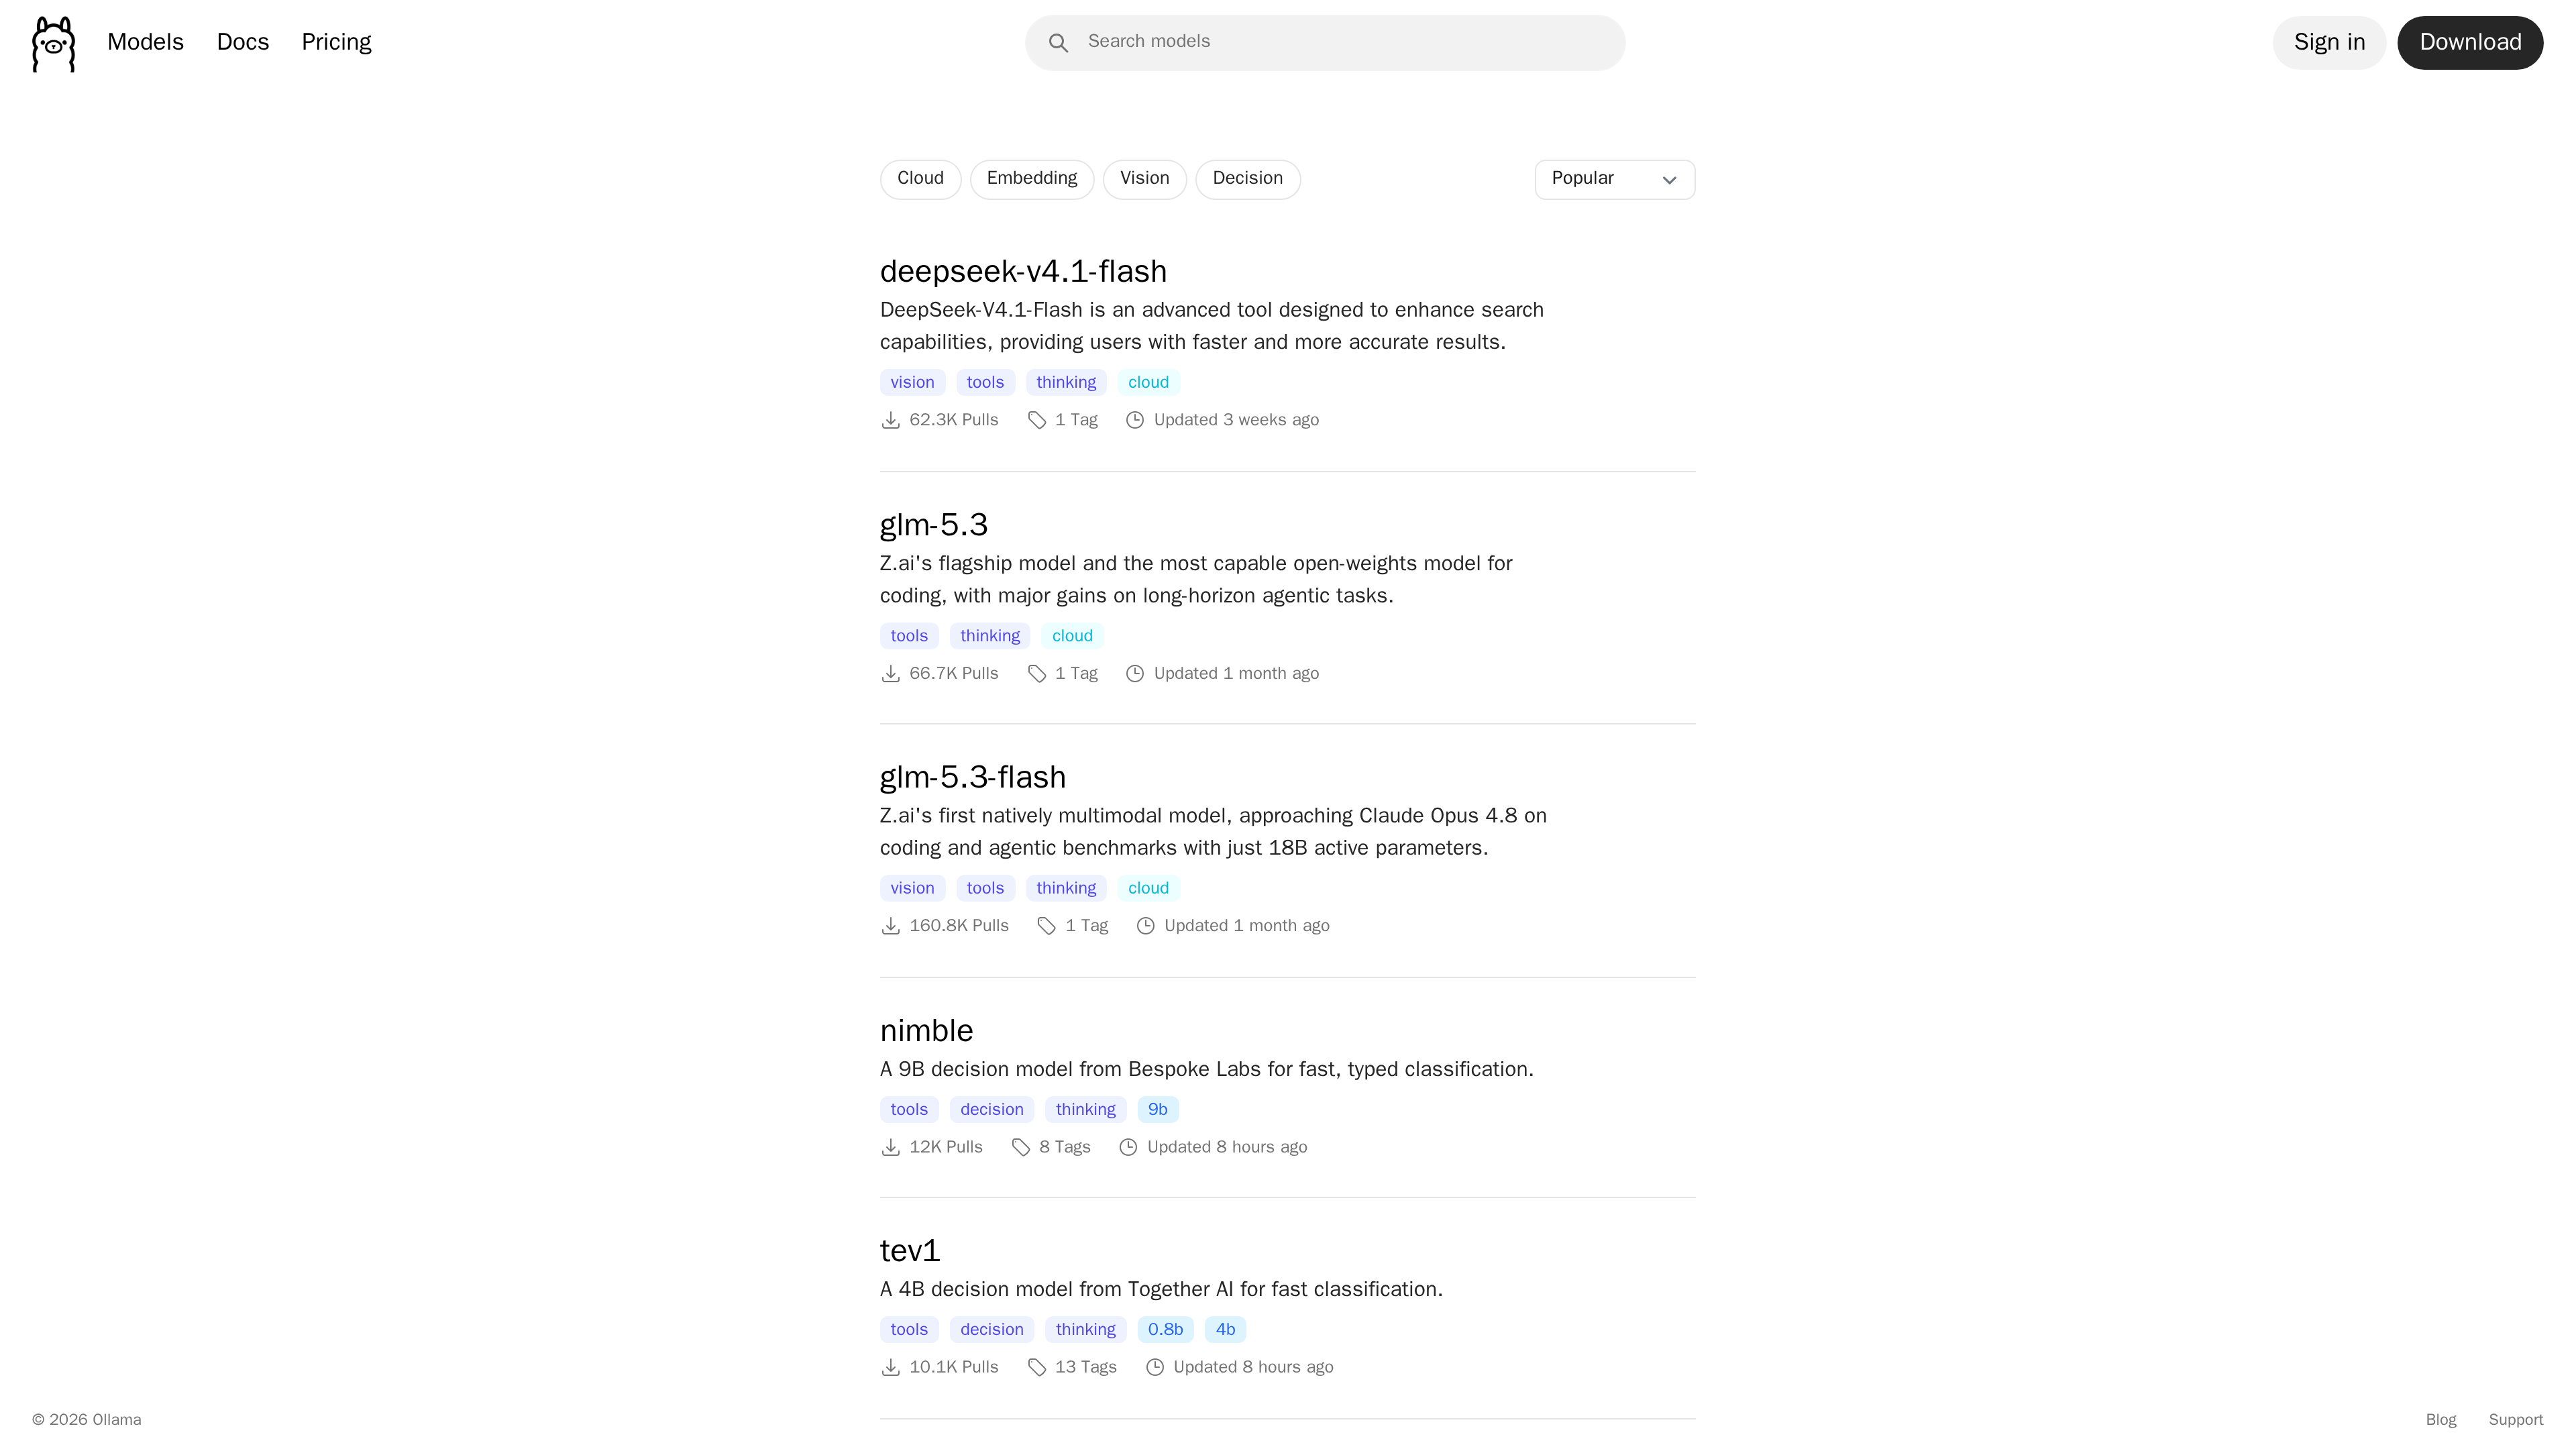
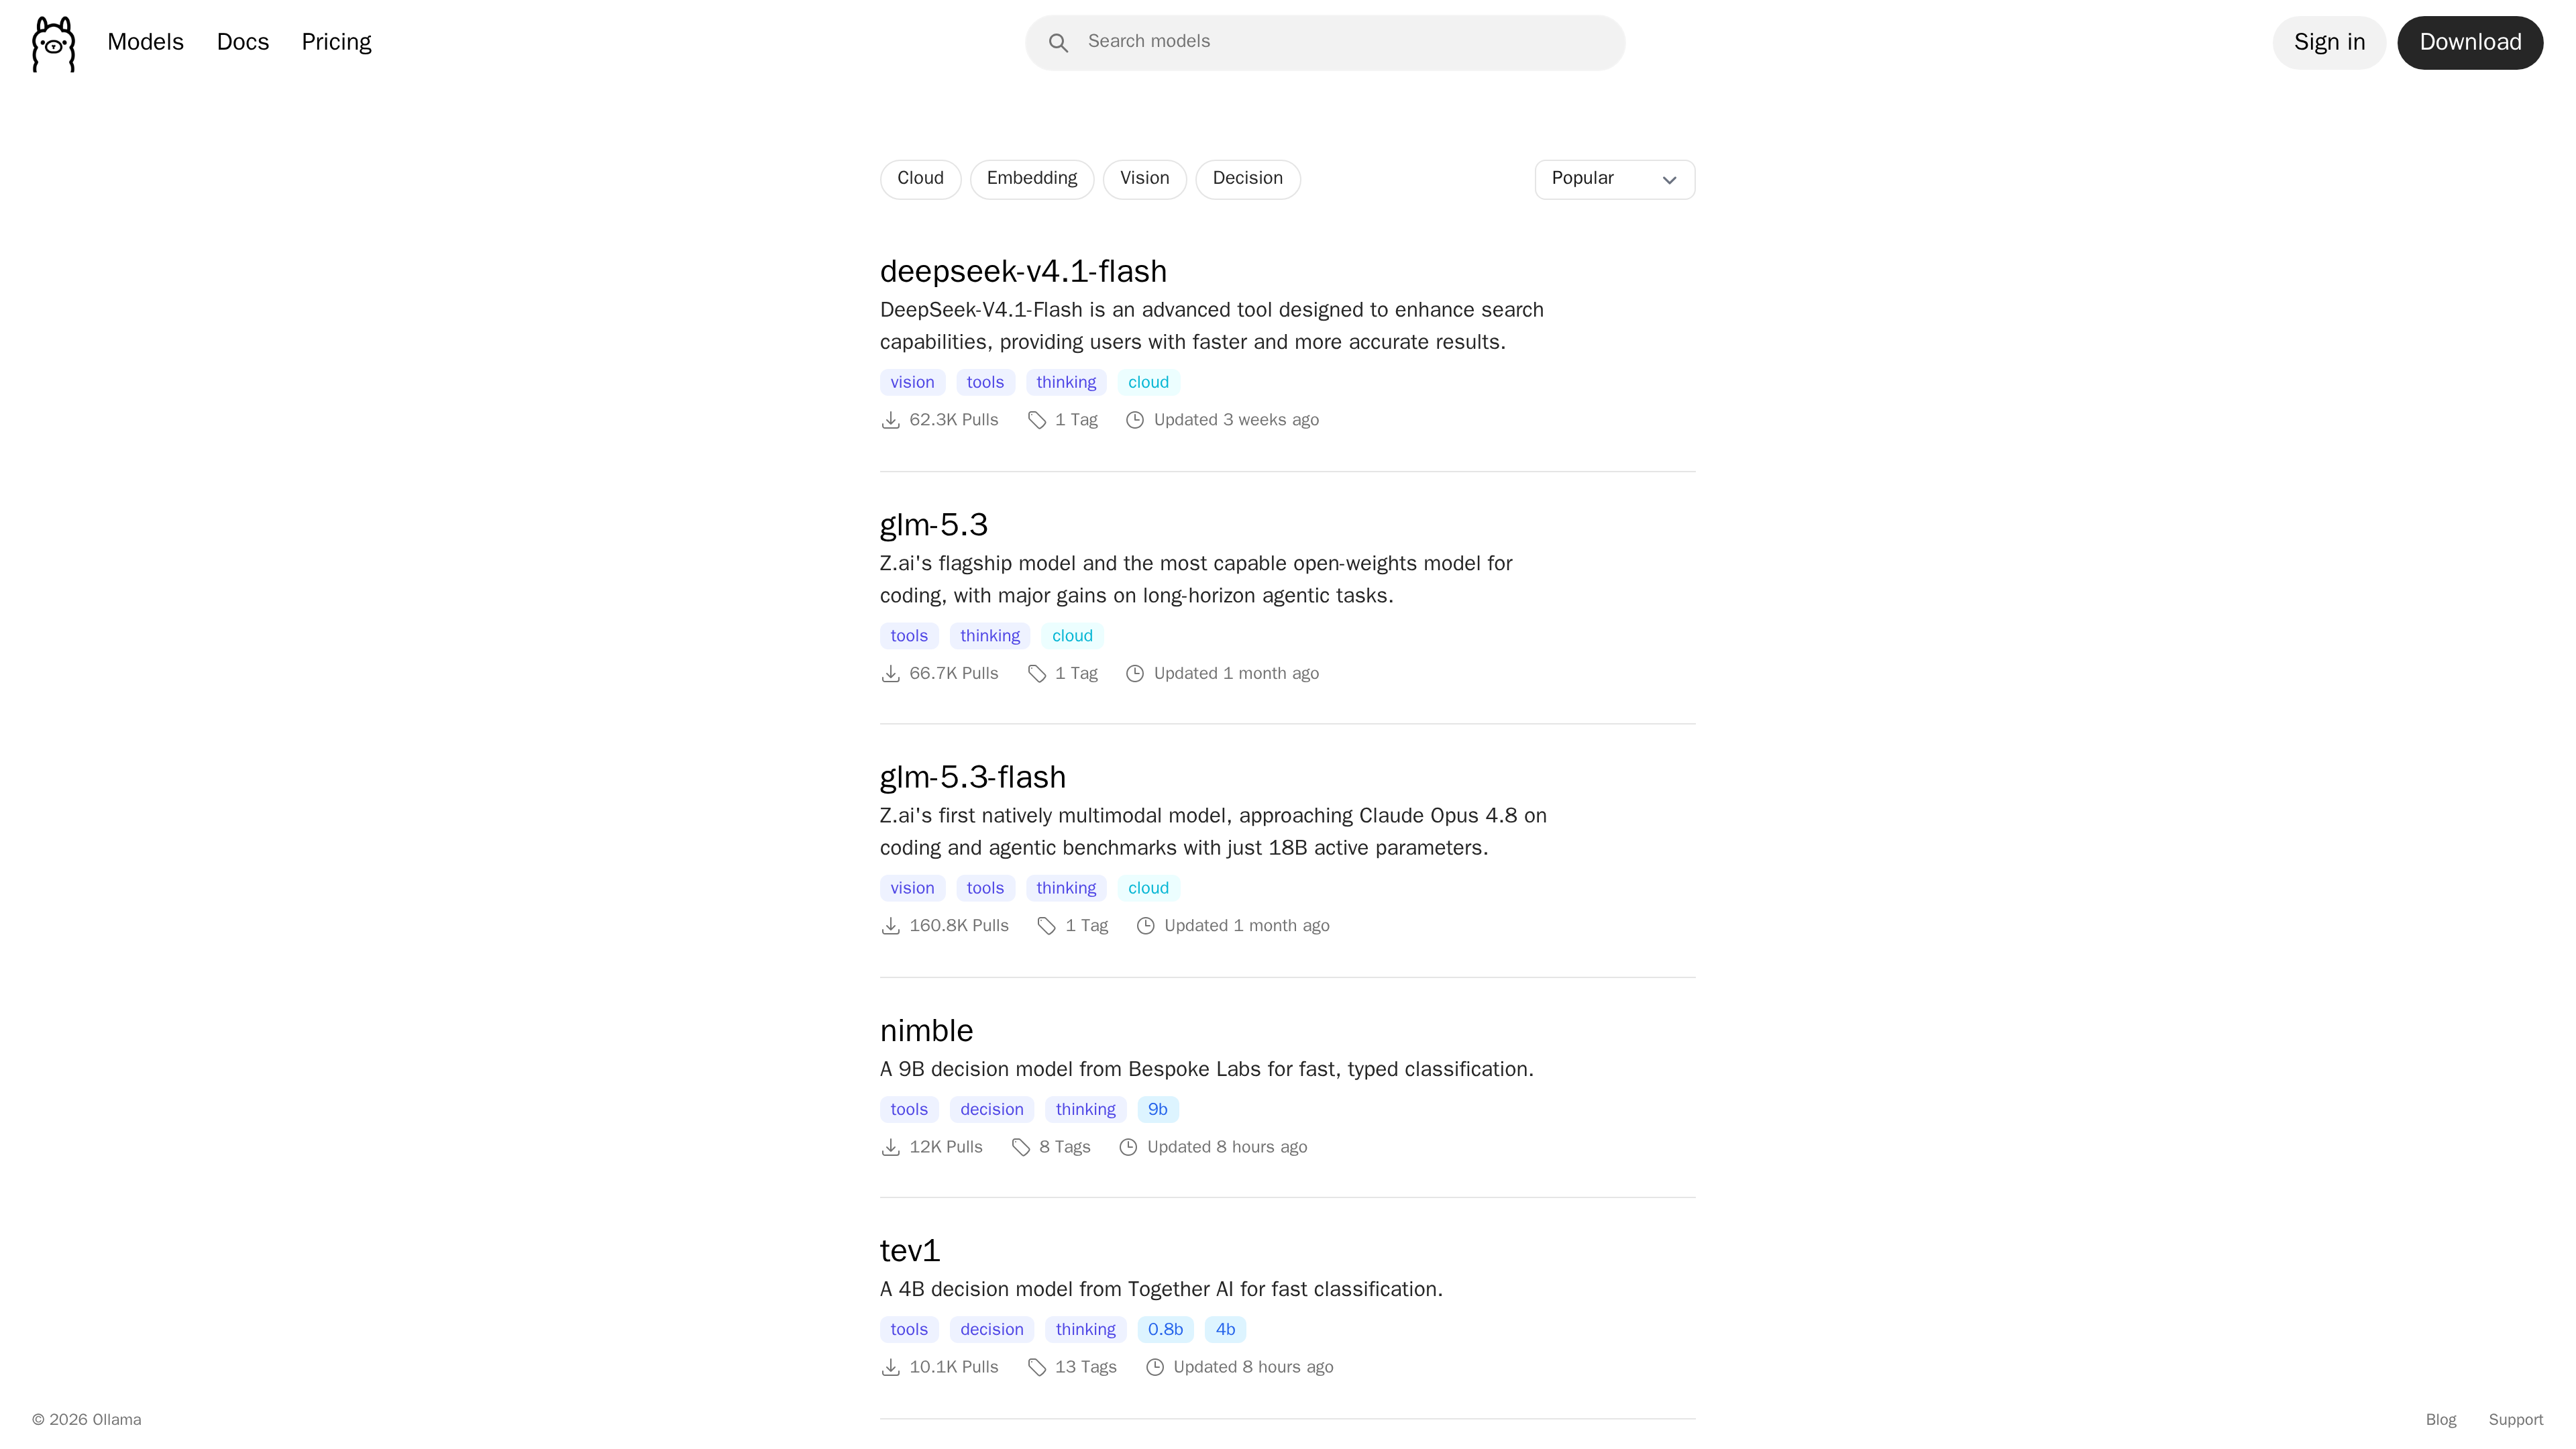
Ollama 的模型库按热度与更新时间排序,条目带有 vision(视觉)、tools(工具调用)、thinking(推理)、embedding、decision、cloud 等能力标签,并标注参数规模、上下文长度和累计拉取次数。截至 2026-10-02,热门模型包括 qwen3.6(约 690 万次拉取)、qwen3.8(约 300 万次)、glm-5.3-flash、deepseek-v4.1-flash 等。
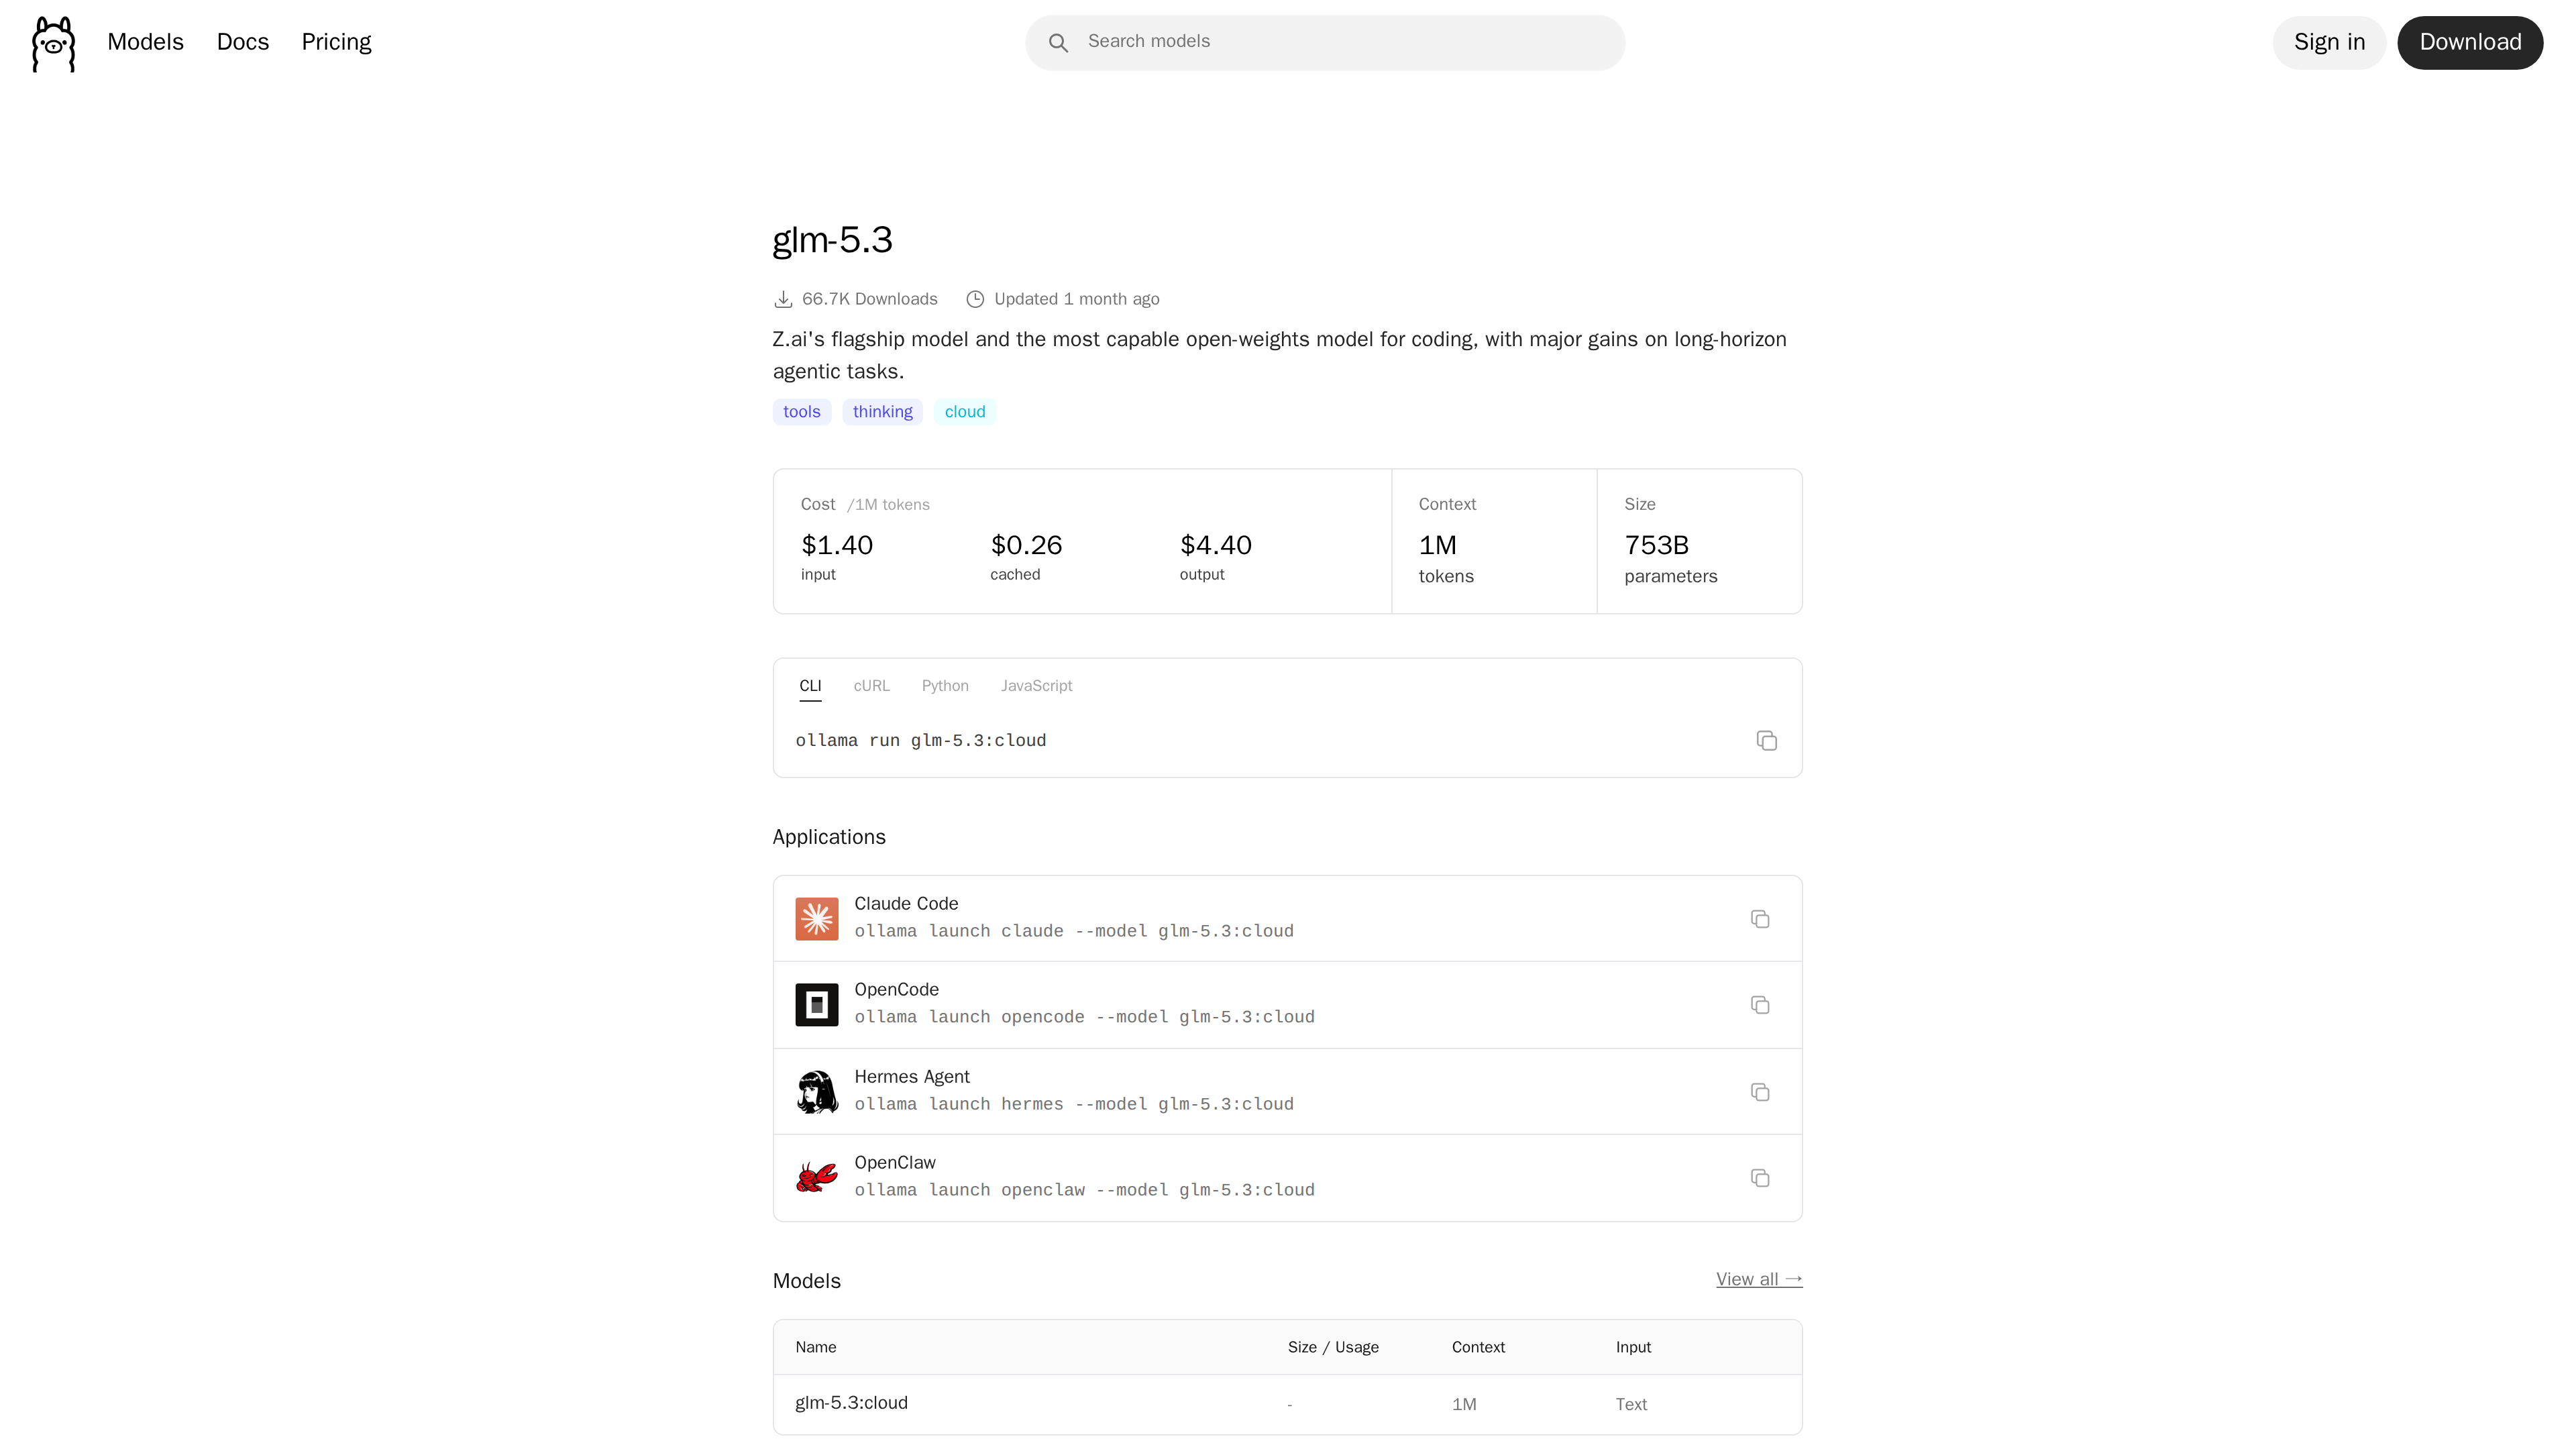
2025 年起官方开始提供云端模型:带 :cloud 后缀的模型(如 glm-5.3:cloud)由 Ollama 托管在自有算力上运行,本地装量不足的设备也能调用 753B 参数、1M 上下文级别的大模型。云端调用走 https://ollama.com/v1 或本地服务转发,需注册账号并创建 API Key。
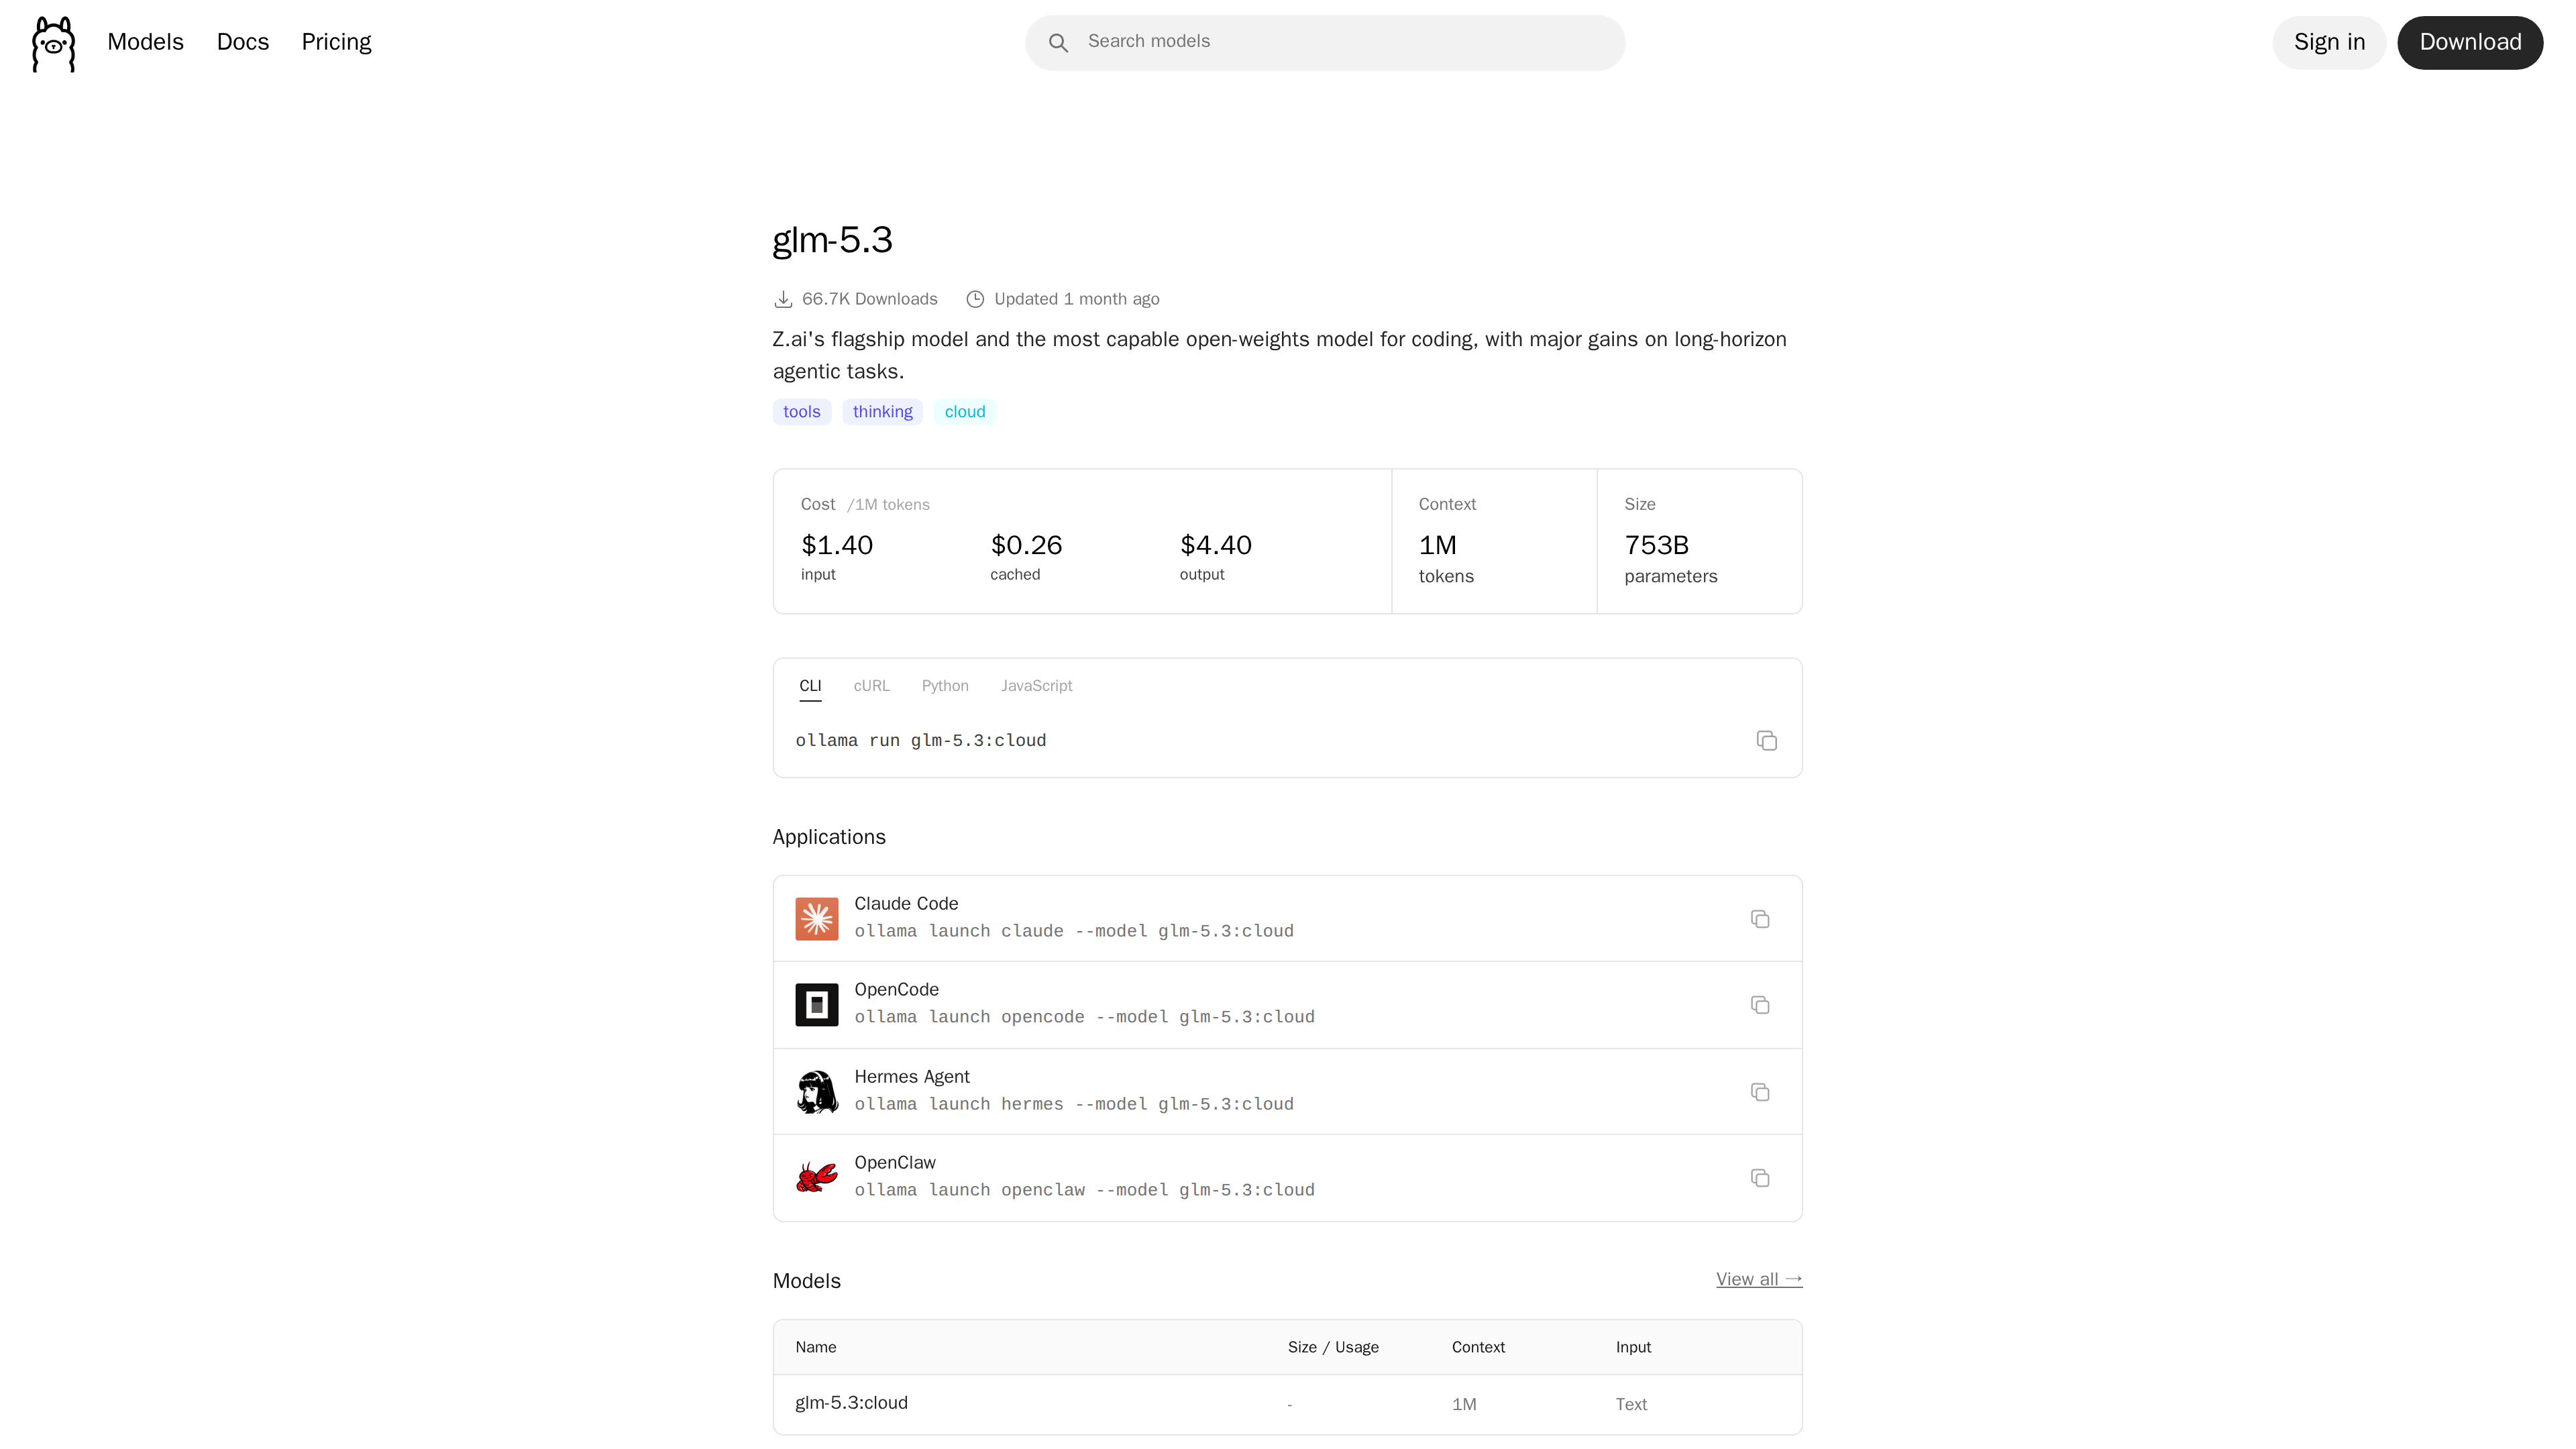
收费结构(以定价页为准,截至 2026-10-02):
- 本地运行:永远免费、不限量(官方原文 "Running models on your own hardware is always unlimited")。
- Free $0:含少量入门用量,可付费购买 credits 解锁全部云端模型,按 token 结算。
- Pro 200/年):含每月 $60 用量额度,可使用更大的 Pro 级模型。
- Max $100/月:含每月 $300 额度、10 并发。
- Team $500/月(early access):不限成员数,共享每月 $1,000 额度与集中管理。
- Enterprise:定制报价,含模型访问控制与预算管理。
隐私与数据
按官方 FAQ 的表述:本地运行的提示词与数据不离开本机;云端模型会处理提示词与响应以提供服务,但官方称不存储、不记录内容、不用于训练,仅收集基础账号信息与有限用量元数据,且不出售数据。云模型托管于美国、欧洲和新加坡的设施。对数据敏感的场景可以完全禁用云端功能、仅以本地模式运行。以上隐私承诺为官方自述,云端场景建议结合其隐私政策自行评估。
适用场景
- 开发者在本机搭建不依赖外部 API 的大模型环境,为现有应用提供 OpenAI 兼容端点。
- 对数据隐私有要求的个人或团队,在内网或离线环境运行开源模型。
- 用编码代理(Claude Code、Codex、OpenCode 等)驱动开放权重模型,控制 token 成本。
- 需要通过 Modelfile 固化系统提示与参数、向他人分发定制模型的场景。
- 本地算力不足但想调用开放权重旗舰模型的用户,可按量使用云端
:cloud模型。
局限
- 本地运行大模型对显存/内存和磁盘要求高,模型文件动辄数十至数百 GB;小内存设备只能运行小参数模型。
- 默认上下文窗口为 4096 tokens,长文本场景需手动调大
OLLAMA_CONTEXT_LENGTH或num_ctx,且会显著增加内存占用。 - Intel Mac 仅支持 CPU 推理,速度慢;Linux 无官方图形界面,需习惯命令行。
- 云端模型按 token 计费且需要注册账号,内容需经 Ollama 服务器处理(官方称不存储、不训练,属单方承诺)。
- 模型质量取决于所选开源模型本身,Ollama 只负责运行与分发,不提供模型能力担保。
参考资料
- Ollama 官网 与 定价页(核查于 2026-10-02)
- GitHub 仓库 ollama/ollama(stars、release 数据经 GitHub API 核查于 2026-10-02)
- 官方文档:Quickstart、OpenAI 兼容、FAQ、macOS、Windows
- 官方博客:《Ollama: all aboard open models》《Ollama's transparent pricing》