中国哲学书电子化计划(Chinese Text Project,简称 CTP)是一个开放获取的中国古籍数字图书馆:打开网页即可全文检索、阅读从先秦到近代的传世文献,无需注册。它由英国杜伦大学计算机科学系助理教授德龙(Donald Sturgeon)于 2006 年创立并维护至今,官方首页自述收录"超过三万部著作、超过五十亿字",是现存规模最大的中国古籍全文数据库(截至 2026-09-02)。与以扫描影像为主的古籍平台不同,CTP 的核心是结构化、可检索的全文,并围绕全文构建了段落级中英平行文本、与语料库打通的字典、相似段落数据库和原典影像对照等研究工具。
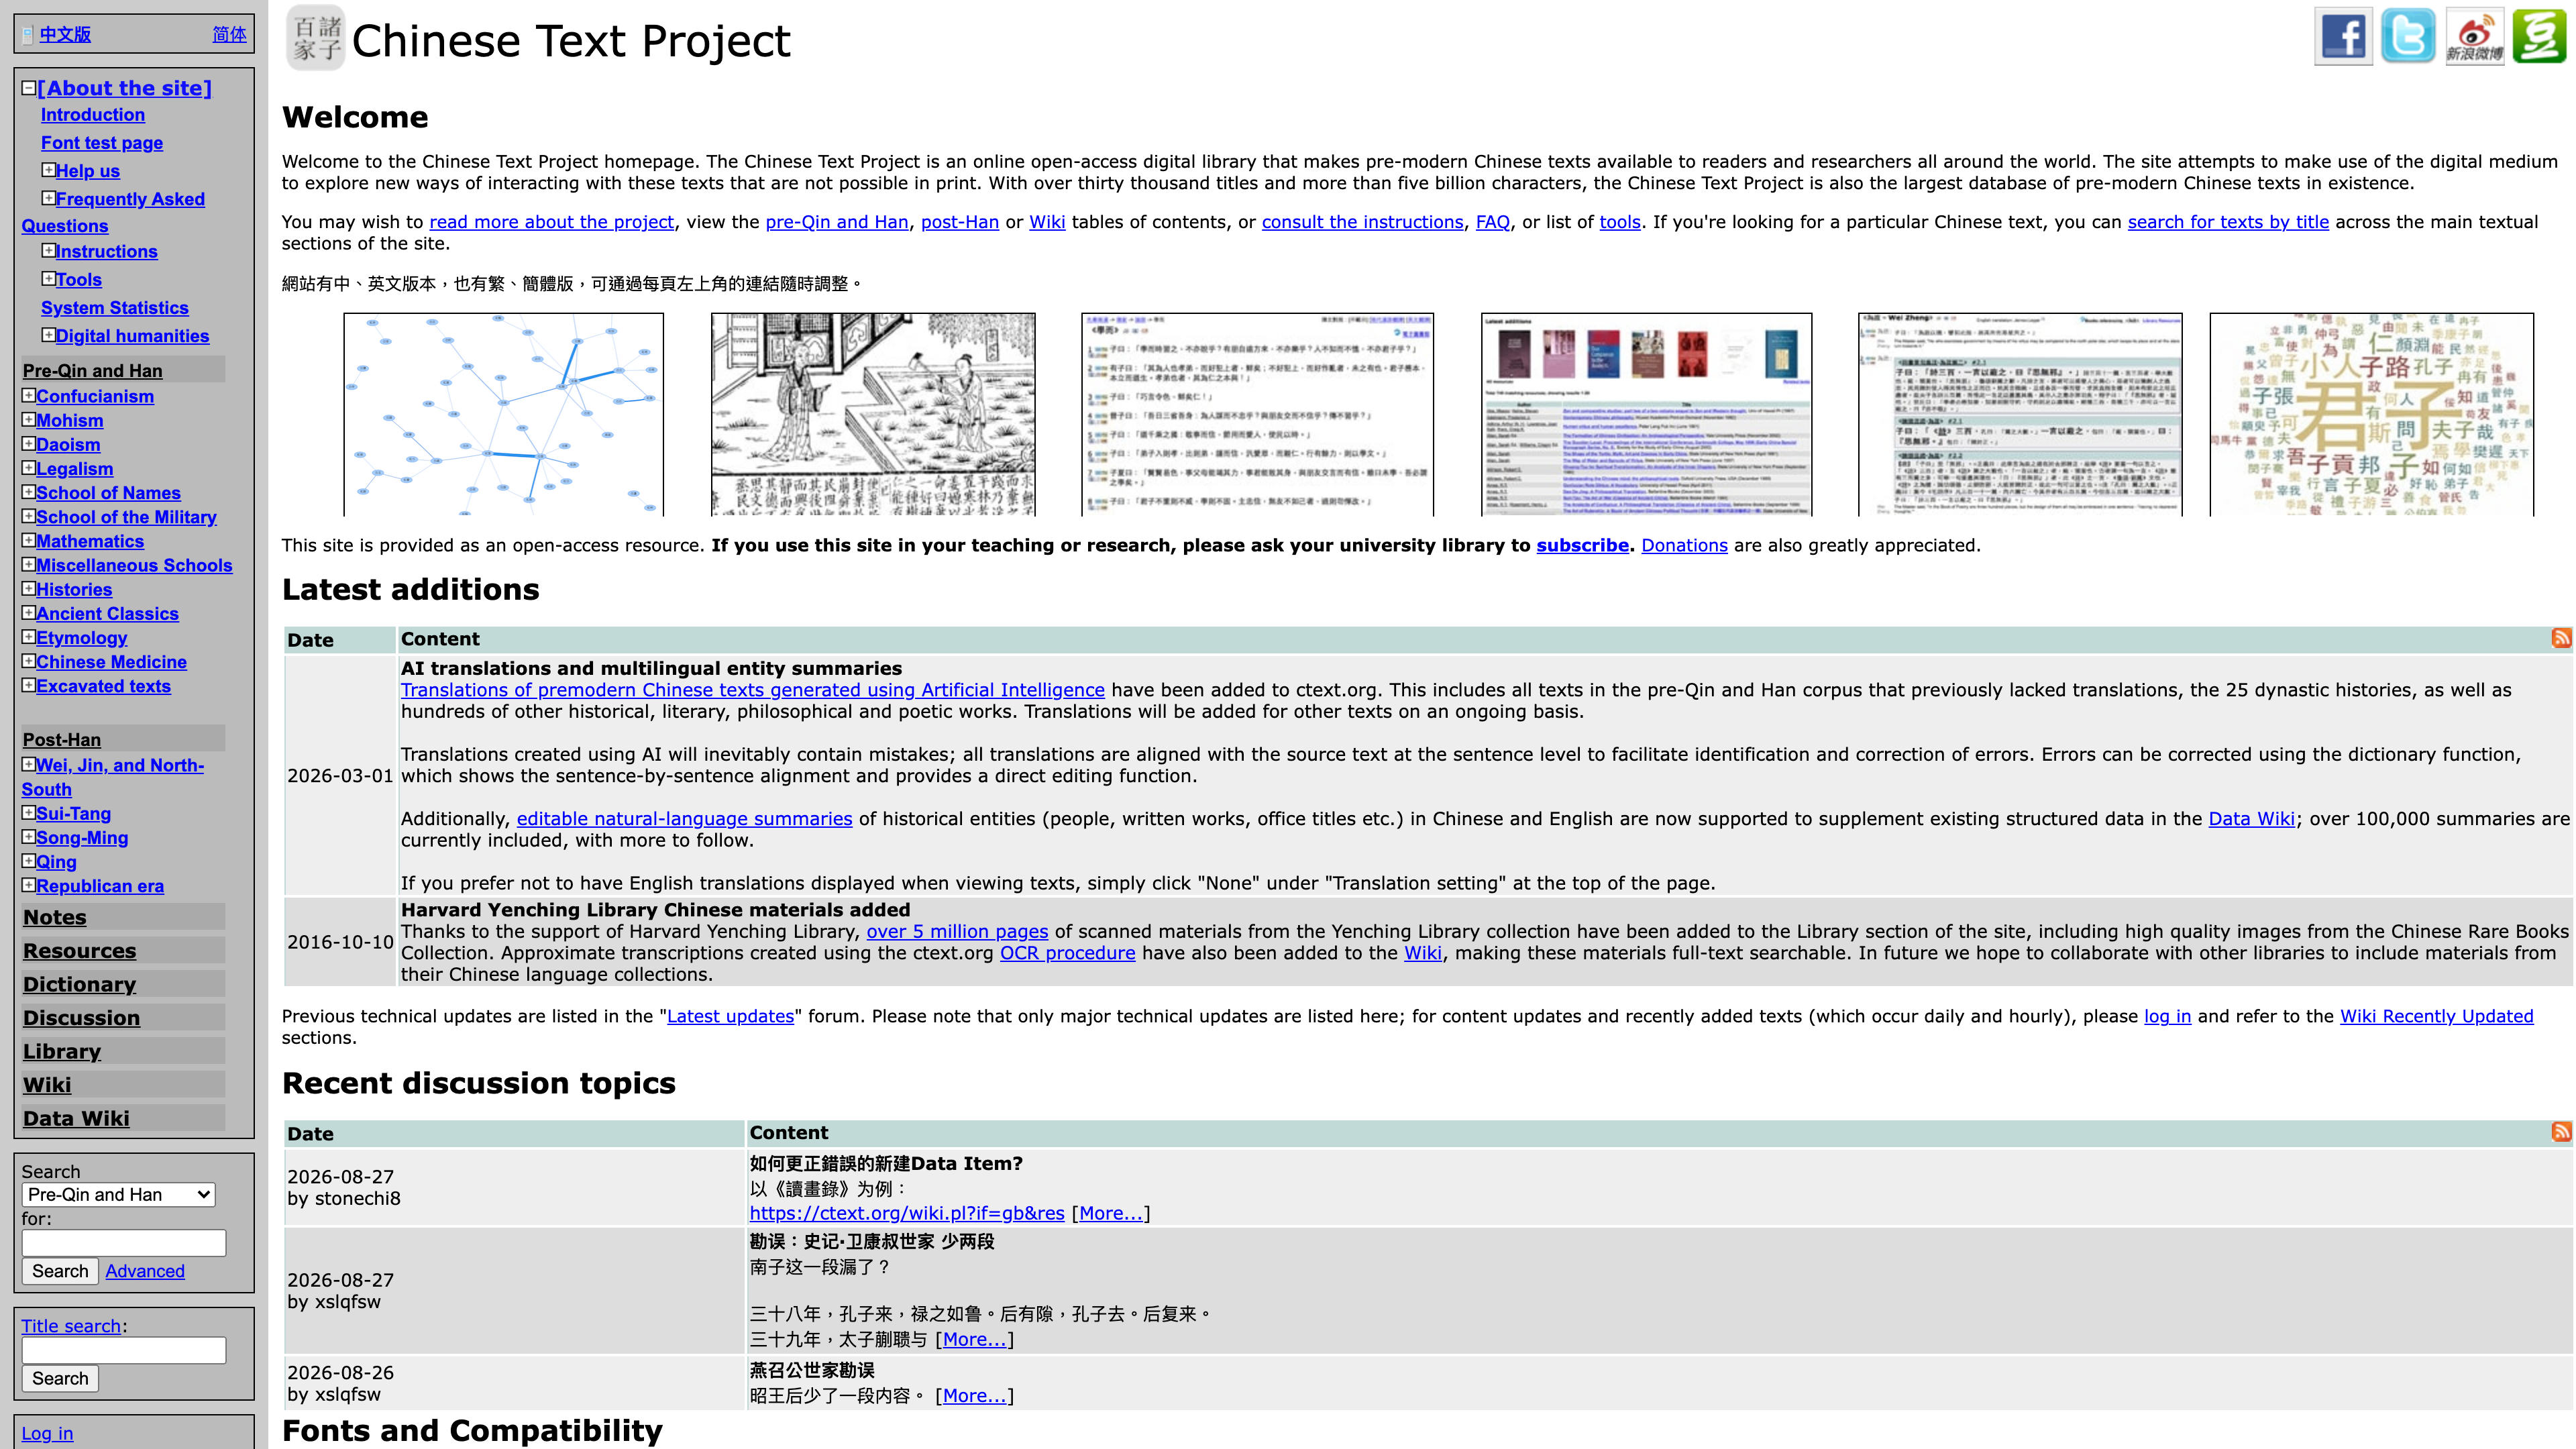
上图是 ctext.org 首页(英文界面):左栏目录把"先秦两汉"文献按儒家、墨家、道家、法家、名家、兵家、算书、杂家、史书、经典文献、字书、医学、出土文献分类,"两汉以后"按朝代排列,下方另有字典、讨论区、Library、Wiki 和 Data Wiki 入口;正文公告栏显示 2026 年 3 月起站内批量加入 AI 生成的英文翻译。
站点速览
- 网址:https://ctext.org/(如遇域名解析问题,官方提供备用域名 ctext.cn)
- 类型:中国古籍数字图书馆 / 全文数据库
- 费用:免费开放获取;大学图书馆等机构可订阅以解锁批量下载、API Key 等扩展功能;接受捐款
- 注册要求:阅读和检索无需注册;注册免费账号可安装插件、编辑 Wiki 文本、参与讨论
- 界面语言:英文与中文,中文可随时切换繁体、简体(站内数据以繁体存储,简体由程序自动转换)
- 上线时间:2006 年(来源:英文维基百科)
- 维护者:德龙(Donald Sturgeon),杜伦大学计算机科学系助理教授
站点背景
CTP 由德龙于 2006 年创立。他兼具中国古典哲学与计算科学背景,曾在哈佛大学从事博士后与研究工作,现任杜伦大学计算机科学系助理教授,研究方向包括古代汉语自然语言处理与数字图书馆(来源:Fairbank Center 个人简介、第九届汉学大会参会介绍)。据官方 FAQ,网站的设计、编辑与维护均由他一人负责。
2016 年 10 月,哈佛燕京图书馆向 CTP 提供超过 500 万页中文馆藏扫描件(含中文善本书特藏),CTP 用自研 OCR 流程生成转录文本并纳入 Wiki 区,使这批影像可以全文检索(首页公告)。
学术写作中引用该站时,官方建议引用其 2019 年发表于 Digital Scholarship in the Humanities 的论文 "Chinese Text Project: a dynamic digital library of premodern Chinese",并注明编辑者为德龙(FAQ 引用说明)。
核心能力
结构化全文与平行文本
文献按"书—篇—段"三级结构组织,每段有固定编号,可直接链接到具体段落。大量先秦两汉核心文献配有英译——如理雅各(James Legge)的版权过期译文——逐段与原文对照显示,部分文献另有现代汉语翻译。
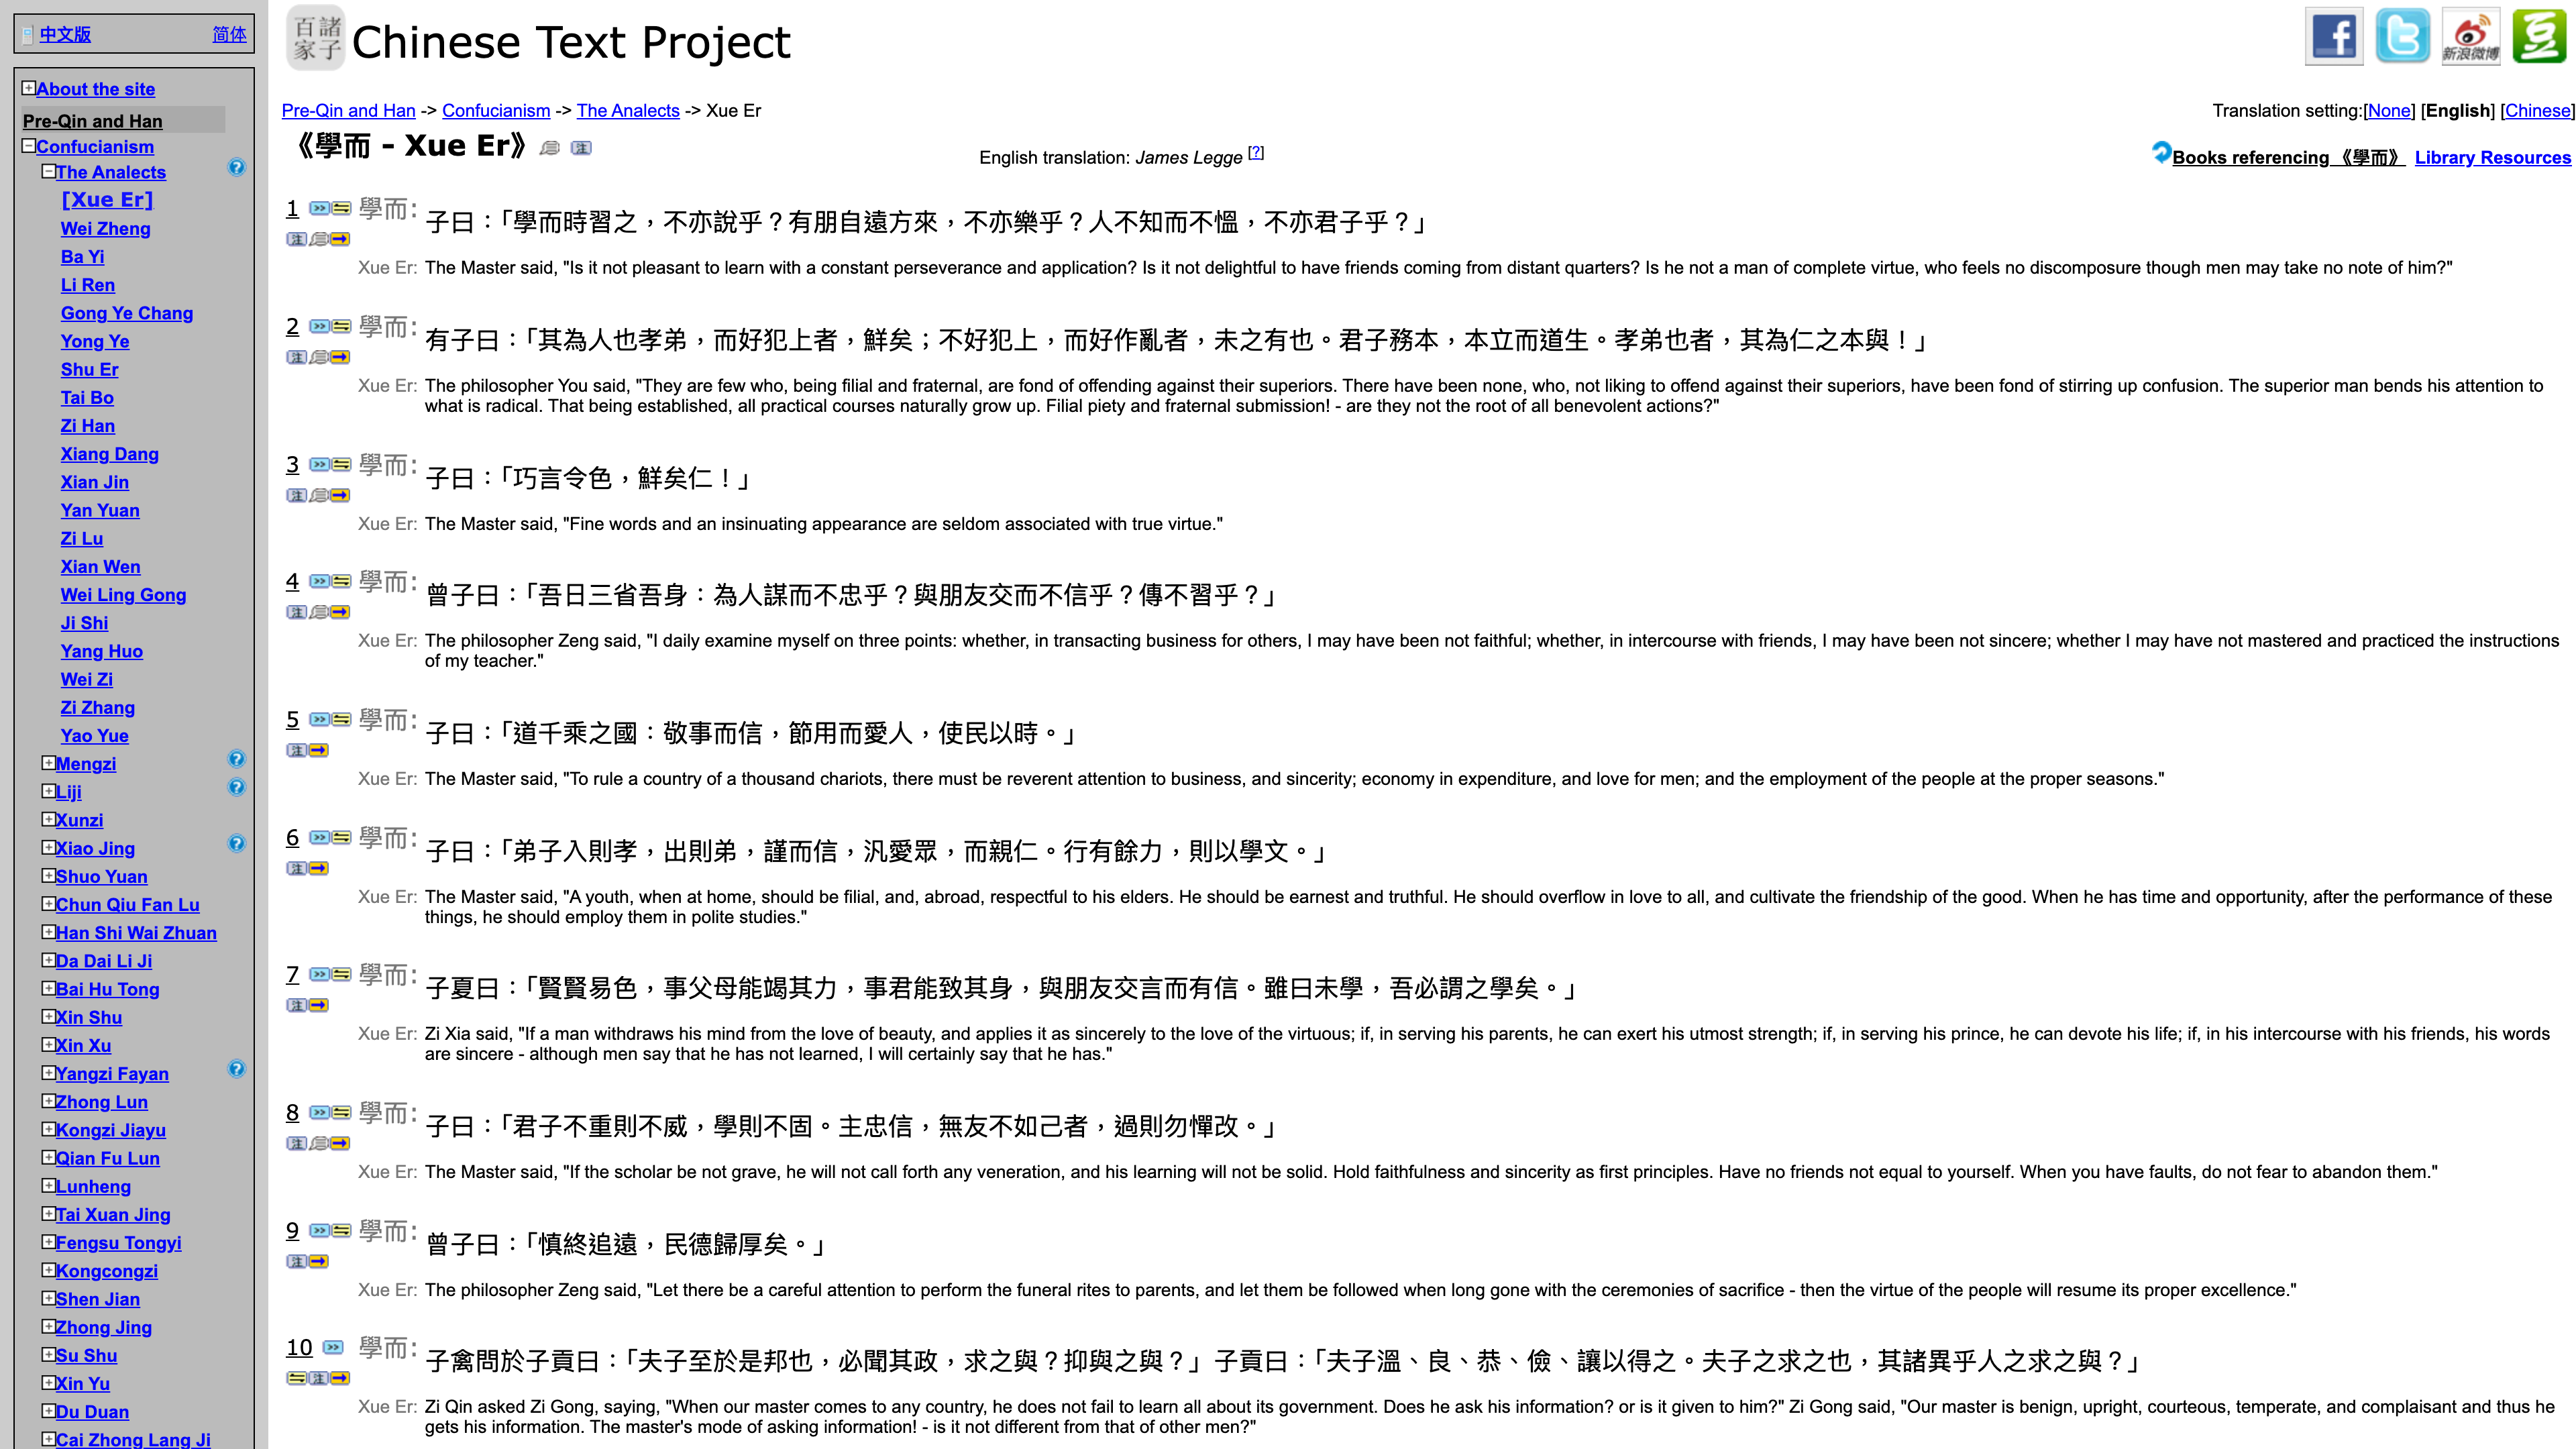
上图是《论语·学而》页面:每段原文下方紧跟理雅各英译,段落左侧编号可展开"跳转到字典""显示相似段落""显示注释"等操作,左栏列出《论语》全书篇目及站内其他儒家文献;页面顶部注明译者信息,并可切换是否显示译文。
2026 年 3 月起,CTP 为此前没有译文的先秦两汉文献、二十五史以及数百种历史、文学、哲学作品批量加入 AI 生成的英译;所有 AI 译文逐句与原文对齐,可通过字典功能直接提交纠错,也可以在页面顶部选择不显示译文。同期上线的还有 Data Wiki 中历史实体(人物、著作、官职等)的可编辑中英文摘要,已超过 10 万条(首页公告)。
与语料库打通的字典
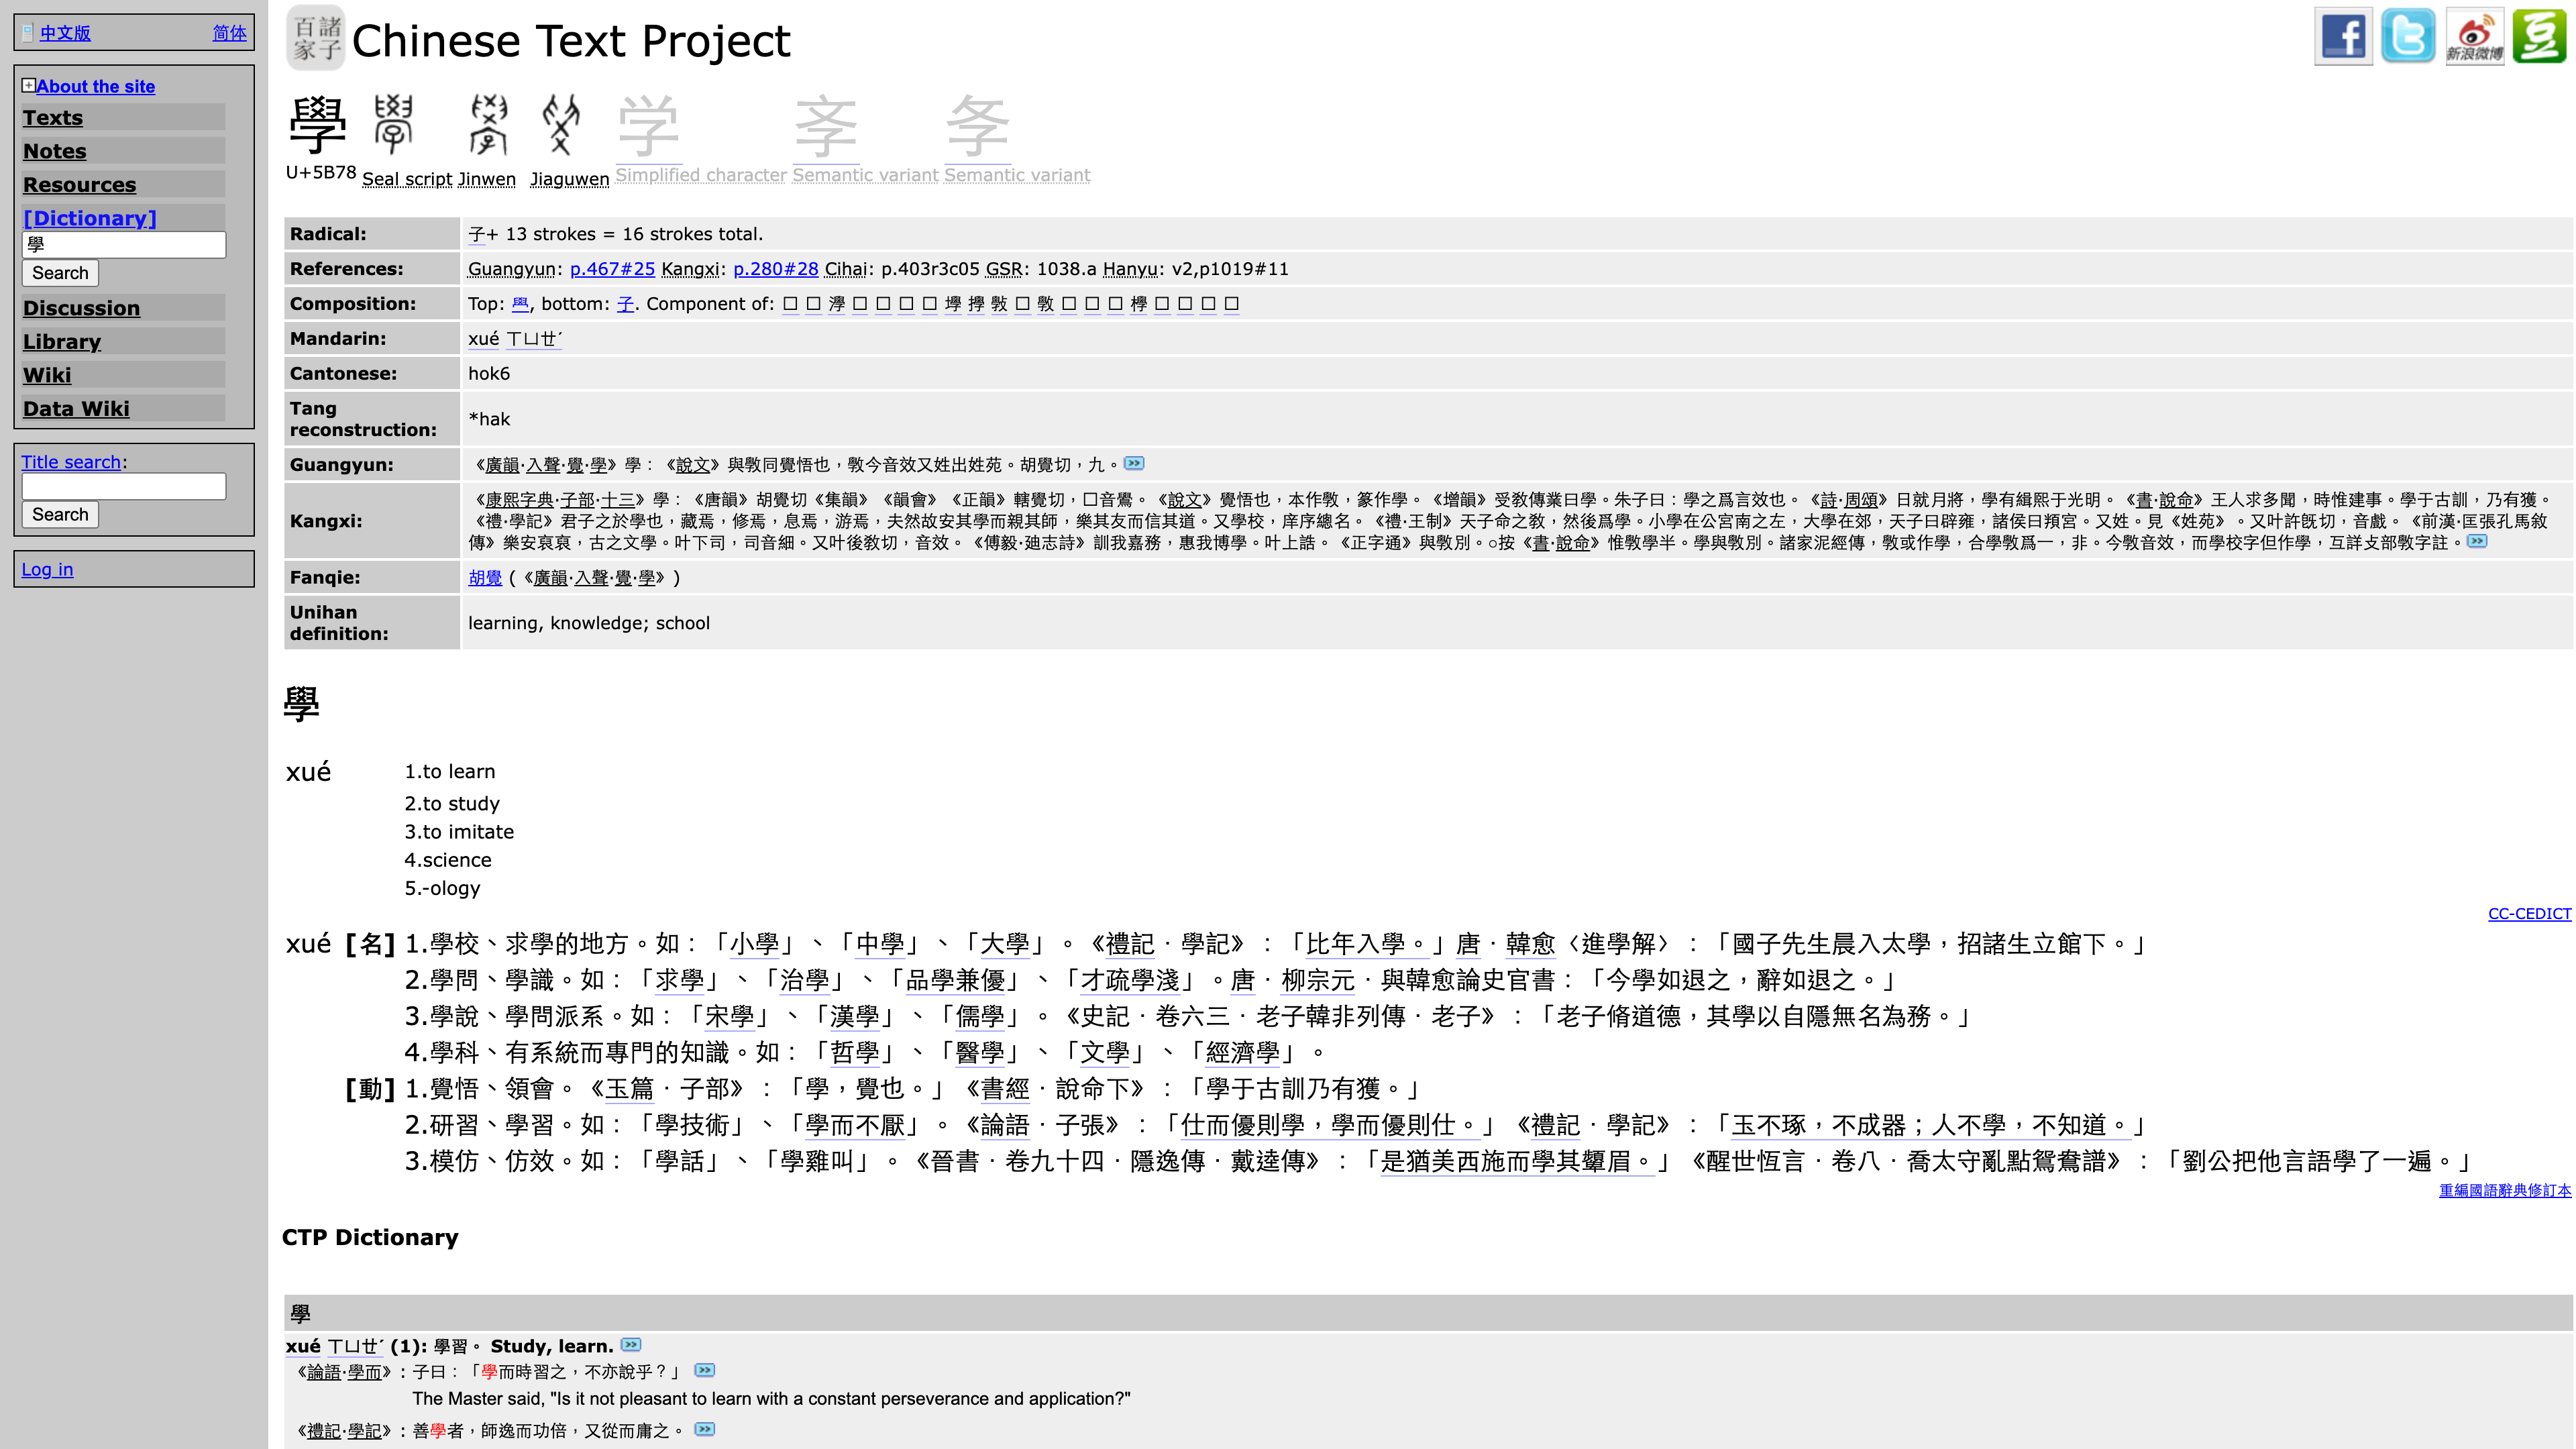
站内字典把字词义项与整个语料库打通:查一个字,除了《广韵》《康熙字典》引文、Unihan、CC-CEDICT、《重編國語辭典修訂本》等外部辞书条目,CTP 自有字典的每个义项下还直接列出该字以该义项出现在语料库中的真实例句及对应英译。字形方面提供篆书、金文、甲骨文图像;音韵信息包含反切、唐代读音构拟、粤语读音,并附《汉语大字典》、Grammata Serica Recensa 等工具书的页码索引(来源:字典"學"字条目)。
相似段落与引得工具
工具列表中的"相似段落数据库"用算法识别早期文献中的文本复用关系,在段落左侧点击"显示相似段落"即可查看同一语句在站内各文献中的出现位置;"引得与索引"工具支持用标准引得编号定位段落,或反查某段落在标准参考书中的位置。这类面向对勘与源流研究的功能,是 CTP 区别于一般古籍阅读站的地方。
原典影像与 Library 区
Library 区存放古籍扫描影像(上传仅接受 PDF 或 DjVu 格式),影像与转录文本逐行关联,阅读文本时可对照"数位底本"扫描页核对文字。官方同时提醒:指定数位底本是校勘目标而非质量保证,数字文本未必始终与底本相符,引用前应自行比对底本影像(FAQ)。
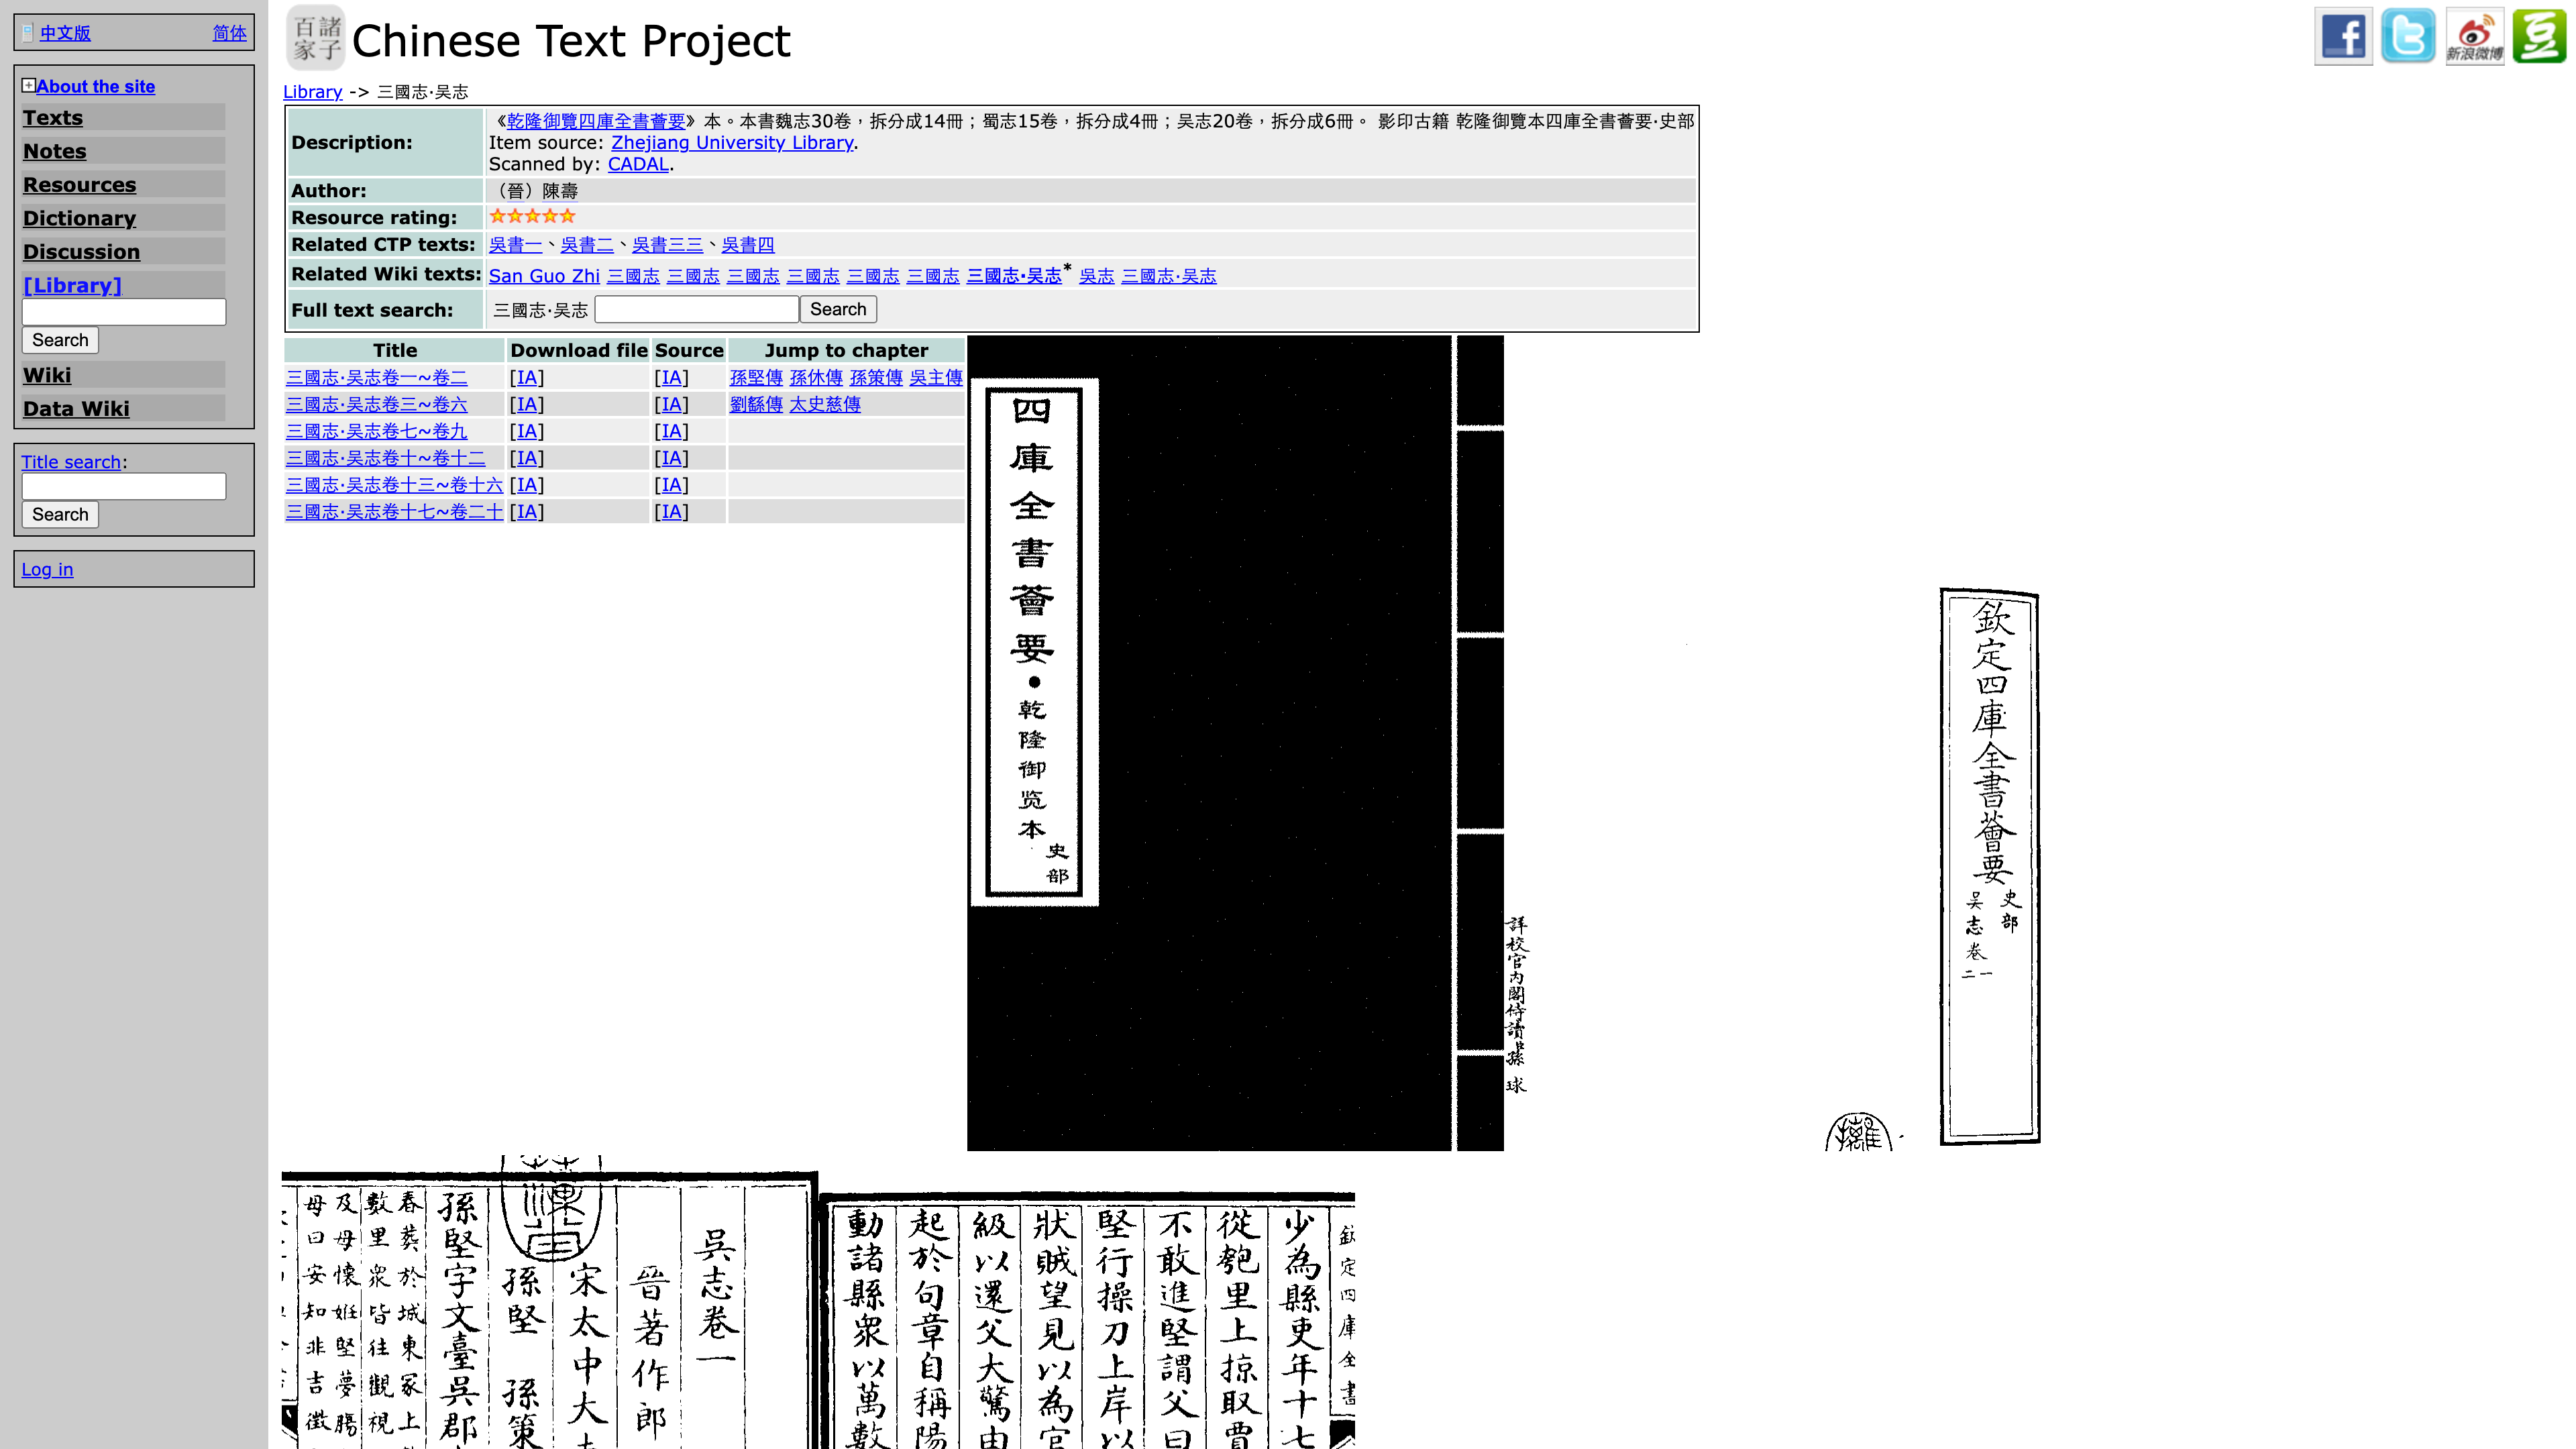
上图是 Library 区《乾隆御览四库全书荟要》本《三国志·吴志》页面:元数据标明影像来源为浙江大学图书馆、CADAL 扫描,表格提供各卷下载来源与"跳转到章节"链接(对应 Wiki 区转录文本),下方为扫描书页影像。
账号、订阅与 API
- 免费账号:可安装插件(如"纯文本导出",安装后能复制或下载任意篇章全文)、直接编辑 Wiki 区文本勘误、参与讨论区。官方说明使用机构邮箱(.edu、.ac.uk 等)注册的账号初始信任度更高,触发验证码的频率更低;持续在 Wiki 区做建设性编辑也会提高账号信任度(FAQ)。
- 机构订阅:面向大学图书馆等机构,权益包括扩展 API 功能(程序化获取文本结构、整书机器可读下载)、发放教研用 API Key、新功能优先体验。截至 2026-09-02,订阅说明页列出哈佛、牛津、斯坦福、中央研究院等约 20 家已订阅机构。
- API 与插件:CTP 提供 JSON API(api.ctext.org),用 URN(如
ctp:analects/xue-er)标识文本对象;未登录调用限额较低,登录用户与机构订阅者额度更高,官方提供 Python 客户端库与配套教程。插件系统允许第三方用 XML 描述把外部工具挂接进 CTP 界面(API 文档)。
版权与内容政策
CTP 不是公有领域文本的简单镜像,使用时需注意其分层版权安排(FAQ 版权一节):
- 网站及内容整体受国际版权法保护,未经许可不得再出版;官方鼓励合理使用,但明确禁止用自动化软件批量下载页面。
- 古代原文多属公有领域;站内译文版权归原译者所有(理雅各等版权过期译文除外),引用译文须注明译者。部分内容处于公有领域,但是否可以复制由使用者自行判断。
- 向 Library 上传材料者须声明材料为公有领域或已获版权人授权,并授予 CTP 永久且不可撤销的出版及衍生作品许可;在 Wiki 区提交或修改内容,须同意将相关版权不可撤销地转让给 CTP。用户提交的内容不经编辑审查,责任由提交者承担。
适用场景
- 检索先秦两汉文献字句出处,获取段落级固定链接
- 借助逐段英译与内置字典阅读原文,或做中英对勘
- 利用相似段落数据做文本源流、互文关系研究
- 通过 API 或 Python 库批量获取语料,开展数字人文分析
- 教学中对照原典影像与排印文本(官方建议教学使用时请所在学校图书馆订阅,以支持站点运营)
局限
- 文本准确性需自行把关:官方明确"指定数位底本不代表数字文本始终与之相符",学术引用前应比对底本影像;Wiki 区文本来自 OCR 与用户转录,不设编辑审查。
- AI 译文仅供辅助:官方公告承认 AI 翻译"不可避免包含错误",需逐句核对。
- 高频使用受限:匿名大量访问会被要求输入验证码或登录;整书批量下载、完整 API 功能需要机构订阅。
- 再发布受限:译文版权归属译者,整站内容不允许批量抓取与再版,与维基文库等自由授权站点不同。
- 使用门槛:界面是朴素的传统桌面 Web 设计(左上角可切换移动版);生僻字属于 Unicode CJK 扩展 A–D 区,需安装花園明朝(Hanazono)等大字集字体才能正常显示(首页说明)。
- 覆盖重心在先秦两汉:两汉以后文献虽按朝代编排,但深度主要依赖 Wiki 与 Library 的用户贡献。
同类参考
- 中文维基文库:志愿者协作的公有领域文献库,内容以自由授权发布、可合法再使用,与 CTP 的保留版权模式形成对照。
- 识典古籍:国内的免费古籍在线阅读平台,提供古籍原文在线阅读。
- Kanseki Repository(漢籍リポジトリ):把汉籍全文文本托管在 GitHub 仓库、按经史子集道佛六部分类的开放项目,适合批量获取机器可读文本。
参考资料
- ctext.org 首页(规模自述、AI 翻译与实体摘要公告、哈佛燕京合作公告、字体要求,核查 2026-09-02)
- 官方 FAQ(维护者、引用格式、译文来源、数位底本说明、版权与 Library/Wiki 条款、备用域名,核查 2026-09-02)
- 工具列表(原典资料库、相似段落数据库、字典、引得索引、插件,核查 2026-09-02)
- CTP API 文档(JSON API、URN、调用限额、Python 客户端库,核查 2026-09-02)
- 机构订阅说明(订阅权益与已订阅机构名单,核查 2026-09-02)
- Donald Sturgeon - Fairbank Center(现任杜伦大学计算机科学系助理教授,核查 2026-09-02)
- Chinese Text Project - Wikipedia(2006 年上线、贡献需注册,核查 2026-09-02)



